[译]基于模型的机器学习 - 4.1 收集与管理电子邮件数据
为了撰写本章,我们开发了一个工具,用于收集某个人在给定时间段内收到的全部电子邮件。随后我们用这个工具从 10 位志愿者那里收集了邮件,他们慷慨地同意分享自己的邮件数据——以匿名化的形式,我们稍后会讨论这一点。这是一个相当耗时的过程,因此我们需要仔细规划将如何使用这些宝贵的邮件数据。例如,我们需要决定用哪些数据来训练、用哪些数据来评估系统的准确率。极其重要的一点是,用于训练的数据不能用于评估。如果训练数据被用于评估,它会给出误导性的偏高准确率结果——因为当你已经被告知正确答案时,对一封邮件做出预测要容易得多!为避免这一点,我们需要把数据划分为不同的数据集:
- 训练集(training set),我们将用它来训练模型;
- 一个独立的测试集(test set),我们将用它来评估对每位用户的预测准确率,从而指示我们对真实用户可能期望达到的水平。
如果你在一个已训练模型的训练集上评估它,它往往会给出比在测试集上更高的准确率结果。训练集上准确率高出的那部分,指示了模型学到了多少特定于训练集中那批具体数据、而非该类数据总体的东西。如果一个模型在训练集上的准确率显著高于测试集,我们就说这个模型对训练数据发生了过拟合(overfitting)。
如果我们只打算评估系统一次,这两个数据集就足够了。然而,我们预期会对系统反复做出更改,并评估每次更改是否提升了预测准确率。如果我们在测试集上多次评估、只保留那些提升测试集准确率的更改,我们就会有对测试集过拟合的风险。这是因为反复做出提升测试集准确率的更改这一过程,可能会捕捉到特定于测试集与训练集合起来、而非该类数据总体的模式。这种过拟合将意味着,在测试集上报告的准确率将不再能代表我们对真实用户可能期望的水平。为避免过拟合,我们将改为把数据划分为三份,得到第三个数据集:
- 一个验证集(validation set),我们将用它在开发系统的过程中评估预测准确率。
我们可以在验证集上想评估多少次就评估多少次,以决定对系统做出哪些更改。一旦我们有了一个最终系统,我们就在测试集上评估一次。如果结果表明模型对验证集发生了过拟合,那么测试集上的准确率结果就会更低,这表明真实用户的准确率会低于我们根据验证集准确率数字可能期望的水平。
如果测试集准确率还不够,那么就有必要对系统做进一步更改。这些更改可以再次在验证集上评估。到了某个时刻,一个新的候选系统就准备好接受测试集评估了。严格来说,此时应当使用一个全新的测试集。在实践中,通常在一个测试集上评估少数几次是可以接受的,只要记住这些数字可能略偏乐观。然而,如果使用过多,一个测试集会因过拟合的可能性而变得无用,此时就有必要收集一个新的测试集。
对于我们收集到的邮件数据,我们可以把每位用户的邮件划分为训练集、验证集和测试集。由于目标是对到达用户收件箱的邮件做出预测,我们把用户已发送邮件(Sent Mail)和垃圾邮件(Junk)文件夹中的邮件排除在这些数据集之外,因为这类邮件并未到达收件箱。我们还排除了那些被规则自动移动的邮件,因为这类邮件同样没有出现在收件箱中。表 4.1 给出了移除这类非收件箱邮件之后,每位用户训练集、验证集和测试集的大小。
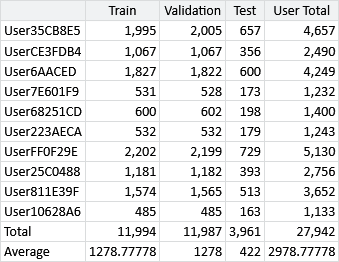
表 4.1:每位用户以及总体的训练集、验证集和测试集中的邮件数量。
从机密数据中学习
表 4.1 凸显了处理邮件数据时的另一个挑战——它是高度个人化、私密的数据!邮件数据是个人身份信息(personally identifiable information,简称 PII)的一个例子,即可用于识别某个特定的人或了解其信息的信息。对于一封邮件而言,个人身份信息包括邮件上的姓名和邮箱地址,以及主题和邮件正文的实际文字。举例来说,知道某位用户会忽略或回复哪些发件人,就会是非常敏感的数据。在任何使用 PII 的系统中,确保这类数据保持机密都是至关重要的。
在一个机器学习系统中,这种对机密性的需求,似乎与深入理解数据、监控系统性能、发现缺陷并做出改进的需求相冲突。用于化解这一冲突的主要技术是某种形式的匿名化(anonymisation),即对数据进行变换,以移除任何 PII,同时保留机器学习系统可以从中学习的底层模式。例如,姓名和邮箱地址可以通过用任意代码替换来匿名化。在本项目中,我们使用类似“User35CB8E5”这样的字母数字哈希码来匿名化所有用户身份,如表 4.1 所示。这类匿名化移除了 PII(或至少使识别所涉用户变得极其困难),但保留了与做出预测相关的信息,例如用户回复每个人的频率。
在某些情况下,匿名化难以实现。例如,如果我们逐词地对主题和正文进行匿名化,这种匿名化有可能被词频词典逆转。出于这个原因,我们从本章所用的数据中移除了邮件正文和主题行,以便我们能够在保护志愿者机密性的同时把数据提供下载。我们将保留主题行和正文文本的长度,因为它们对做出预测有用,但不会破坏机密性。如果你希望用一个更完整的邮件数据集做实验,有几个这样的数据集可用,其中一个例子是 Enron 邮件数据集 [The CALO Project, 2004]。请注意,即便对于这个公开的 Enron 数据集,也有一些邮件“因受影响员工的请求而作为编辑删除工作的一部分被删除”,这再次表明了邮件数据的敏感性!对于这类难以轻易实现匿名化的情形,有一种令人振奋的新方法正在开发之中,称为同态加密,它使得可以在不先解密数据的情况下对加密数据进行机器学习。这种方法目前仅处于研究阶段,因此尚未准备好用于真实应用(但如果你好奇,可在专栏 4.1 中了解更多)。
专栏 4.1 同态加密
同态加密是一种数据加密方式,它允许某些算法直接在加密数据上运行、给出加密的结果,而数据从不被解密!目前,对可以在数据上运行的算法种类存在实际的限制——例如,它们可能被要求只由加法或乘法组成(且数量有限)。目前以这种方式运行算法也有可观的计算开销。尽管有这些限制,使用同态加密运行推断算法仍是可能的——例如,Graepel 等人 [2013] 描述了一个完全在加密数据上运行的分类算法。
尽管仍处于研究阶段,同态加密在允许机器学习算法在机密数据上运行方面有着巨大的潜力。
使用我们经过匿名化和裁剪的数据集,意味着我们可以检查、优化或调试系统的任何部分,而无需看到任何机密信息。在某些情况下,这种匿名化会使人难以理解系统的行为或调试问题。因此,在这类情况下有一个小的、未经匿名化的数据集可供使用是有帮助的。在本章中,我们为此目的使用了我们自己的一部分邮件。对于一个已部署的系统,你也可以请真实用户自愿提供极其有限的、通常属于机密的信息,例如某一封特定的邮件。重要的是要允许用户确切地审阅正在共享哪些信息,并确保这些信息仅用于调试他们所报告问题(例如一次错误的预测)的目的。
现在我们已经有了以适当匿名化形式存在的训练和验证数据集,我们准备好开始开发我们的模型了。
本页引入概念回顾
训练集(training set):所收集数据中将用于模型训练的部分。
测试集(test set):所收集数据中将用于评估已训练模型准确率的部分。这种评估应当不常进行,理想情况下只进行一次,以避免对测试集过拟合。
过拟合(overfitting):一种已训练模型对数据中特定于训练集的模式、而非与同类数据总体相关的模式学得过多的情形。如果一个模型发生过拟合,它在训练集以外数据集上的预测准确率就会下降。
验证集(validation set):所收集数据中将用于在模型开发过程中评估其准确率的部分。验证集通常被反复使用,以决定是否对模型做出更改。这带来了对验证集过拟合的风险,这也是为什么另外拥有一个独立的测试集很重要。
个人身份信息(personally identifiable information):任何关于某个人的信息,可用于识别其身份或了解关于其的机密信息。
匿名化(anonymisation):一种对数据进行变换以移除任何个人身份信息、同时保留足够有用信息的过程。例如,邮箱地址可以通过用随机生成的字符串替换来匿名化,使得同一地址总是被替换为同一字符串。这使得可以识别邮件使用的模式,而不必把这些模式与任何给定的发件人或收件人关联起来。
参考文献
[The CALO Project, 2004] The CALO Project (2004). Enron email data set. http://www.cs.cmu.edu/~enron.
[Graepel et al., 2013] Graepel, T., Lauter, K., and Naehrig, M. (2013). ML confidential: Machine learning on encrypted data. In Kwon, T., Lee, M.-K., and Kwon, D., editors, Information Security and Cryptology - ICISC 2012, volume 7839 of Lecture Notes in Computer Science, pages 1–21. Springer Berlin Heidelberg.
下一节:一个用于分类的模型
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-08-06-mbml-emailclassifier_collecting_and_managing_email_data/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。