[译]基于模型的机器学习 - 4.4 设计特征集
要使用我们的分类模型,我们需要设计特征来变换数据,使其尽可能贴近地符合模型中内置的假设(表 4.3)。例如,为满足假设 4.7(即特征包含与用户行为相关的所有信息),我们需要确保我们的特征集包含所有与预测回复相关的特征。由于一封邮件几乎任何部分都可能有助于做出这样的预测,这意味着我们将不得不在特征中编码邮件的几乎所有方面。这将包括谁发送了邮件、收件人栏和抄送栏上的收件人、邮件的主题以及邮件的正文,还有关于该邮件所属会话的信息。
在设计一个新特征时,我们需要确保:
在本节中,我们将展示如何为我们的特征集设计若干新特征,同时确保它们满足上述前两条标准。在下一节中,我们将展示如何通过在有和没有某些特征的情况下评估系统,来检查第三条标准。
具有多个状态的特征
到目前为止,我们用一个 ToLine 特征来表示用户出现在邮件中的位置。这个特征只有两个状态:用户要么在收件人栏中,要么不在。因此这个特征忽略了用户是否在抄送栏中,尽管我们可能预期用户在出现在抄送栏中时比完全不出现时更有可能回复邮件。这个特征还忽略了用户在收件人/抄送栏上的位置。如果用户排在收件人栏的第一位,我们可能预期他比排在一长串收件人末尾时更有可能回复。我们可以用我们的数据集来检验这些直觉,方法是找出在若干情形下所有训练/验证邮件中实际被回复的比例:当用户在收件人栏中排第一、第二或第二之后时,当用户在抄送栏中排第一或其他位置时,以及当用户既不在收件人栏也不在抄送栏时(例如,如果他通过邮件列表收到邮件)。
图 4.8 绘制了这些比例,显示回复概率确实会根据适用于哪种情形而有很大变化。这幅图表明,一个能够区分这些情形的特征确实会捕捉到数据中有信息量的方面(即我们上面的第一条标准)。在评估回复比例(例如图 4.8 中的那些)时,重要的是要考虑该比例是从多少封邮件计算得来的,因为从少量邮件计算出的比例不会很准确。为检查这一点,在图 4.8 中我们在每个条形标签下方的括号中显示了邮件数量,表明每个情形都有足够的邮件来准确计算比例,因此我们可以信赖所计算的值。
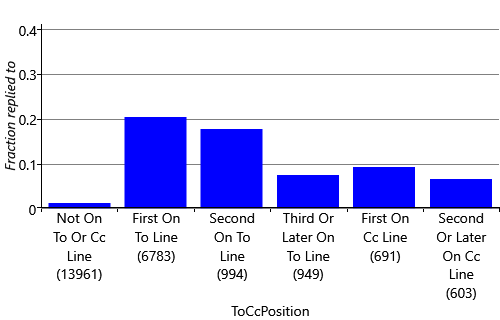
图 4.8:对于用户在收件人栏或抄送栏上六种可能位置中的每一种,被回复的邮件比例。用户处于每个位置的邮件数量显示在括号中(回复比例是这些邮件中被回复的比例)。该图显示,对于我们的数据集,排在收件人栏第一位表示最高的回复概率,但如果用户排在第二位或更后,这个概率会降低。它还显示,如果用户没有出现在收件人栏或抄送栏,回复概率非常低。
我们可以改进这个特征来捕捉这样的线索,方法是给它多个状态,图 4.8 的每个条形各对应一个。因此状态将是:{ NotOnToOrCcLine、FirstOnToLine、SecondOnToLine、ThirdOrLaterOnToLine、FirstOnCcLine、SecondOrLaterOnCcLine }。现在我们只需弄清楚特征的输出应该是什么,才能适合我们的模型(第二条标准)。我们可以尝试对 NotOnToOrCcLine 返回值 0.0、对 FirstOnToLine 返回 1.0,依此类推直到对 SecondOrLaterOnCcLine 返回 5.0。但是,根据假设 4.3(score 变化等于权重乘以特征值),这将意味着当值从 0.0 变到 5.0 时,回复概率要么稳步上升,要么稳步下降。图 4.8 表明情况并非如此,因为从左到右回复比例是有升有降的。所以这样的假设会是错误的。一般来说,我们希望避免做出依赖于某些本身没有内在顺序的状态排序的假设,就像这些状态一样。相反,我们希望能够分别学习每个状态如何影响回复概率。
为实现这一点,我们可以修改特征,让它输出多个特征值,每个状态一个。我们对适用于某封邮件的那个状态用值 1.0,对所有其他状态用值 0.0——这有时被称为独热(one-hot)编码。因此,用户排在收件人栏第一位的邮件将由特征值 $\{0.0,1.0,0.0,0.0,0.0,0.0\}$ 表示。类似地,用户排在抄送栏第一位的邮件将由特征值 $\{0.0,0.0,0.0,0.0,1.0,0.0\}$ 表示。这样做,我们实际上创建了一组相关的二值特征——不过,把它们看成一个输出多个值的单一 ToCcPosition 特征要方便得多。
为避免术语上的混淆,我们将把这样一个特征的不同元素称为特征桶(feature bucket)——因此 ToCcPosition 特征包含六个特征桶。对于某封特定的邮件,你可以把一个特征的独热编码想象成扔一个球,它落进其中一个桶里。
使用这个术语,我们因子图中横跨各特征的板现在应被解释为横跨所有特征的所有桶,因此每个桶有它自己的 featureValue 和它自己关联的 weight。这意味着我们 ToCcPosition 特征的每个桶可以有不同的权重——因此我们不再假设回复概率在各桶之间稳步上升或下降。
数值特征
我们还需要创建编码数值量的特征,例如邮件正文的字符数。如果我们直接把字符数用作特征值,我们就会假设更长的邮件意味着回复概率总是比更短的邮件更高或总是更低。但实际上,我们可能预期用户不太可能回复一封非常短的邮件(“谢谢”)或一封非常长的邮件(例如时事通讯),但可能会回复长度介于两者之间的邮件。同样,我们可以通过绘制各种正文长度下被回复的邮件比例来考察这些看法。为得到一个有用的图,有必要把长度相近的邮件归到一组,以便我们有足够的邮件来可靠地估计回复比例。在图 4.9 中,我们用相应的正文长度范围来标注柱状图中的每个条形。每个条形的长度范围大约是前一个的两倍,最后一个条形对应非常长的邮件(超过 1023 个字符)。
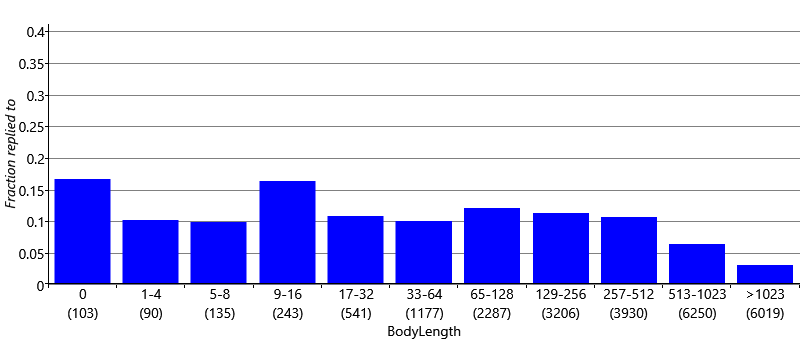
图 4.9:对于由邮件正文字符数给出的各种正文长度范围,被回复的邮件比例。落入每个长度范围的邮件数量显示在括号中。零长度邮件很可能把消息放在主题行中,因此回复比例相当高。对于其他邮件,回复比例在约 9–16 个字符处达到峰值,然后总体下降,直到对于非常长的邮件变得非常低。
这幅图有几个方面值得评论。零长度邮件有相当高的回复概率,很可能是因为这些是消息在主题中的邮件。正如我们所预料的,非常短的邮件回复概率相对较低,这个概率上升到 9–16 个字符处的峰值,然后大致保持恒定,直到我们到达 513 个字符或更长的非常长的邮件,此时回复概率开始逐渐减小。为捕捉回复概率中的这些变化,我们可以采用刚才对 ToCcPosition 使用的同样方法,把图中的每个条形当作一个不同的特征桶。这给了我们一个有 11 个桶的 BodyLength 特征。长度落入某个特定长度范围(例如 33–64 个字符)的邮件都映射到单个桶。这个映射编码了这样一个假设:回复概率不取决于确切的正文长度,而只取决于该长度落入哪个范围。
具有极多状态的特征
我们可能预期,一封邮件的发件人会是预测用户是否会回复的最有用的属性之一。但既然我们能使用数据,何必依赖看法呢?图 4.10 显示了 User35CB8E5 最频繁的二十个发件人的邮件被回复的比例。如你所见,从一个发件人到另一个发件人,回复比例有很大的变化:有些发件人根本没有回复,而另一些发件人有很高的回复比例。类似的模式对我们数据集中的其他用户也成立。所以,发件人确实是预测回复的一个非常有用的线索。
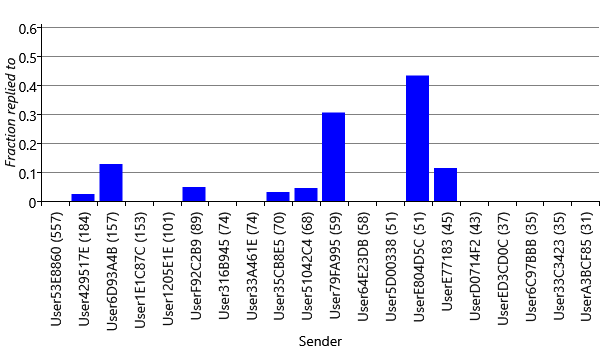
图 4.10:User35CB8E5 最常见的 20 个发件人的邮件被回复的比例(每个发件人的邮件数量显示在括号中)。回复比例在不同发件人之间差异显著,表明这是预测回复的一个非常有用的线索。正如第 4.1 节中所讨论的,发件人身份已被匿名化以保护用户的隐私。
为把发件人信息纳入特征集,我们可以使用一个多状态的 Sender 特征,数据集中的每个发件人各一个状态。例如,User35CB8E5 在训练集和验证集合起来中有 658 个唯一的发件人。这将导致一个有 658 个桶的特征,其中 657 个值为 0.0,而对应于实际发件人的那个桶值为 1.0。由于如此多的特征桶值会是零,把我们的因子图改为只包含实际“活跃”(非零)的特征桶要高效得多。一个经过适当修改的因子图如图 4.11 所示。
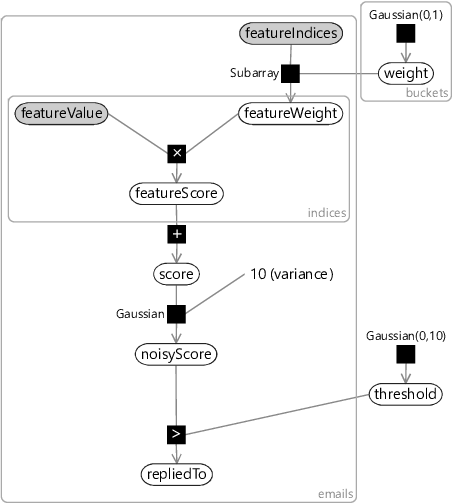
图 4.11:只表示非零特征桶的修改后因子图。featureIndices 变量包含具有非零值的特征桶的索引。featureValues 变量包含这些桶对应的值。Subarray 因子用于抽出 weight 数组中相关的元素,把它们放入 featureWeight 数组。
在这个修改后的图中,一封邮件的特征值由非零值的索引(featureIndices)以及这些索引处对应的值(featureValues)来表示。我们使用第 2.4 节中引入的 Subarray 因子,从完整的权重数组(weight)中抽出活跃桶的权重(featureWeight)。这个新的因子图使得像 Sender 这样的特征可以被添加进来,而不会导致训练和分类时间大幅变慢。例如,在 User35CB8E5 的训练集上训练,使用旧因子图需要 9.2 秒,而使用这个新因子图仅需 0.43 秒。如果我们在更多邮件上训练,这个加速会更大,因为会有更多唯一的发件人。
一个初始特征集
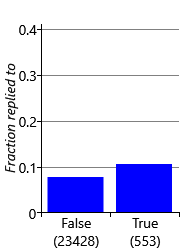
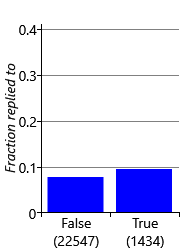
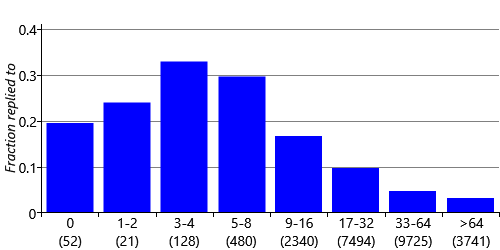
现在我们知道如何编码各种不同类型的数据属性了,我们可以完成我们的初始特征集,准备开始实验。为编码剩余的数据属性,我们再添加三个特征:FromMe、HasAttachments 和 SubjectLength,它们的特征桶和回复比例如图 4.12 所示。
(a) FromMe
(b) HasAttachments
(c) SubjectLength
图 4.12:对于三个新特征,每个特征桶被回复的邮件比例。落入每个特征桶的邮件数量显示在括号中。
正如我们早先在第 4.1 节中讨论的,我们从数据集中移除了主题行和邮件正文的内容,因此无法添加任何编码主题或邮件正文实际词语的特征。为 Exchange 项目构建分类器时,使用了来自自愿提供的数据的匿名化主题词和正文词。正如你可能预料的,纳入这样的主题词和正文词特征确实对预测准确性有实质性的帮助。
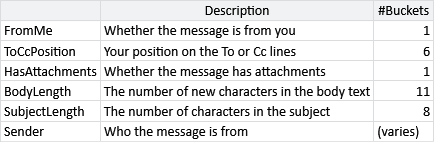
表 4.4:用于预测一封邮件回复的初始特征集。对每个特征,我们显示了特征类型、简要描述以及该特征的特征桶数量(在该数量固定的情况下)。
现在我们有了一个分类模型和一个特征集,我们准备好看看它们如何协同工作来预测用户是否会回复一封新邮件了。
本页引入概念回顾
独热(one-hot):一种用大小为 $N$ 的向量来编码 1-of-$N$ 选择的方式。该向量除了对应于所选项的位置为 1 之外,处处为零。因此,如果有三个选项,第一个将由 $\{1.0, 0.0, 0.0\}$ 编码,第二个由 $\{0.0, 1.0, 0.0\}$ 编码,第三个由 $\{0.0, 0.0, 1.0\}$ 编码。
特征桶(feature buckets):标识返回多个值的特征各个值的标签。例如,图 4.8 中的 ToCcPosition 特征有六个特征桶:NotOnToOrCcLine、FirstOnToLine、SecondOnToLine、ThirdOrLaterOnToLine、FirstOnCcLine 和 SecondOrLaterOnCcLine。对于这个特征,与其中一个桶关联的值将是 1.0,其他值将是 0.0,但对于其他特征,可能有多个桶具有非零值。
下一节:评估与改进特征集
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-08-21-mbml-emailclassifier_designing_a_feature_set/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。