Evaluation 中的文章

语音 Agent 评估:Foundry 多轮评估器到底有多可靠?

本文整理自 Microsoft Foundry 博客的 Evaluating Voice Agents: How Reliable Are Foundry’s Multi-turn Evaluators?,作者是 Sheng Liu、Shivank Goel 和 Morteza Ziyadi。

做语音 Agent 的团队迟早会撞上一个现实:每天几千通电话,Agent 还隔三差五更新,光靠人工听录音根本跟不上,只能上自动评估。Microsoft Foundry 给的办法是多轮评估器,它会看完整段对话,评估 Agent 的行为和结果。

……
阅读全文

评估更多,花费更少:把 Microsoft Foundry 评估器合并成一次调用

Evaluate More, Spend Less: Batching Microsoft Foundry Evaluators

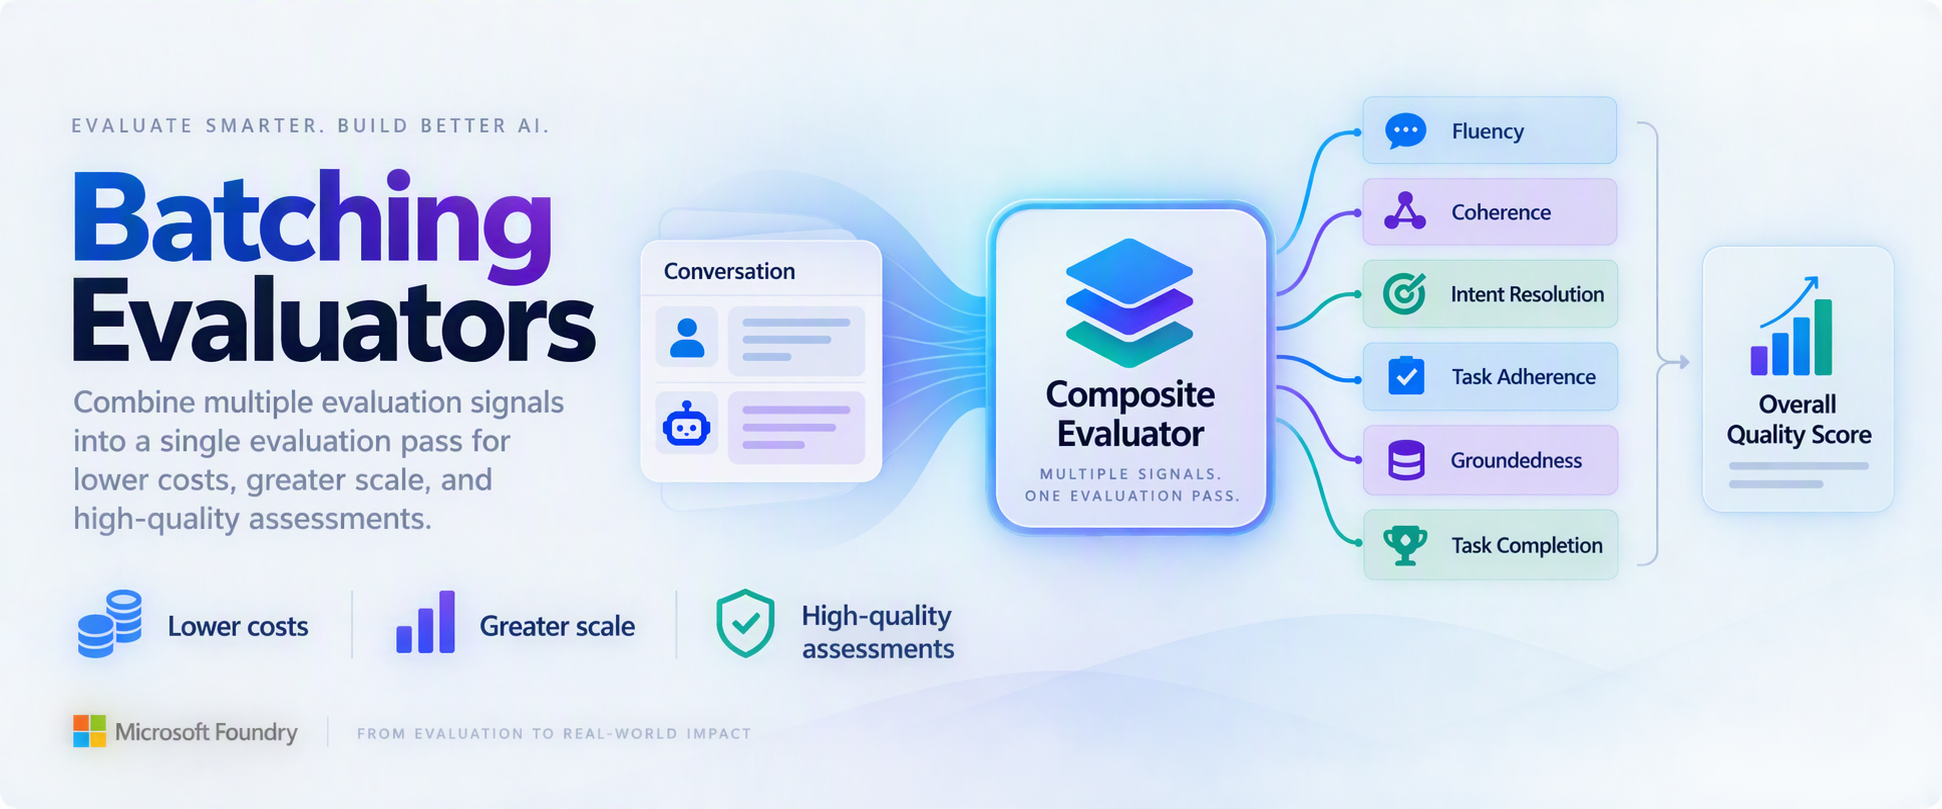
题图来自 Microsoft Foundry 博客的 Evaluate More, Spend Less: Batching Microsoft Foundry Evaluators for Efficient Evaluation,作者是 Salma Elshafey、Ali Mahmoudzadeh、Kayla Ames、Ahmad Qardahji、Vivek Bhadauria、Morteza Ziyadi 和 April Kwong。

给 Agent 做评估时,同一段对话往往要分别发给好几个评估器。这篇文章讲的是微软 Foundry 团队的一项实验:用一次 Judge 调用同时跑五六个 Microsoft Foundry 评估器,总输入 token 少了 61.25% 到 71.07%,实测运行耗时少了 35.74% 到 46.10%,而且在几个价值较高的评估维度上,前沿 Judge 模型的质量没有明显波动。我把它读完后觉得,数字好看是一回事,更有用的是它顺带给出了哪些评估器适合合并、哪些得留着单独跑。

……

阅读全文

最近文章

分类

标签

友情链接

其它