语音 Agent 评估:Foundry 多轮评估器到底有多可靠?
本文整理自 Microsoft Foundry 博客的 Evaluating Voice Agents: How Reliable Are Foundry’s Multi-turn Evaluators?,作者是 Sheng Liu、Shivank Goel 和 Morteza Ziyadi。
做语音 Agent 的团队迟早会撞上一个现实:每天几千通电话,Agent 还隔三差五更新,光靠人工听录音根本跟不上,只能上自动评估。Microsoft Foundry 给的办法是多轮评估器,它会看完整段对话,评估 Agent 的行为和结果。
问题是,这些评估器放到语音 Agent 的 trace 上到底靠不靠谱?微软团队拿 Task Completion 和 Generated Rubric 两个评估器,在基准对话和一个 Foundry 语音 Agent 的 trace 上做了一轮测试,结论围绕四件事展开:单通电话的判断准确率、Agent 之间的排名、同一批数据重复评估时的一致性,以及基于 rubric 的打分。我把数据过了一遍,下面按原文的结构整理。
两个评估器
Task Completion 和 Generated Rubric 的输入都是一段完整的多轮对话,由一个 Judge 模型自动评估。差别在评估标准和输出。
Task Completion 判断用户的任务有没有被成功、完整地完成。输出是一个二元结果(true 或 false),外加一段解释,说明为什么判定为完成或未完成。
Generated Rubric 则根据用户提供的评估要求生成一套标准,再按这套标准评估对话。输出是 0 到 1 之间的加权总分、通过或不通过的结果,以及每条标准各自的得分和解释。
研究设计
Task Completion
Task Completion 在两个 trace 数据集上做了评估。
第一个是 τ-Voice 基准 trace,包含 3000 多通模拟电话,覆盖航空、零售和电信三类任务,由 12 种语音 Agent 配置产生,其中既有 audio-native 的系统,也有级联(cascaded)的系统。图 1 只展示本文保留的 9 种配置:gpt-realtime、Gemini Live 和级联配置。数据只保留了 τ-Voice 的用户模拟器确实遵循了所收到指令的那些对话。
第二个是 Foundry Agent trace,由一个基于 gpt-realtime-2 的 Foundry 语音 Agent 在 τ-Voice 任务上产生,同样只保留用户模拟器遵循指令的对话。
Judge 这边,Task Completion 评估器保持不变,结果来自 7 种 GPT Judge 配置。对每通电话,研究者把评估器的结论和研究数据中的参考通过/不通过标签做对比。Agent 排名和重复评估一致性则是在 τ-Voice 基准 trace 上测量的。
Generated Rubric
Generated Rubric 的评估对象是电信类对话,仍由那个基于 gpt-realtime-2 的 Foundry 语音 Agent 在 τ-Voice 任务上产生。rubric 由 gpt-5.4-mini 根据描述预期行为的要求生成。gpt-5.4 和 gpt-5.6-sol 各自用 Generated Rubric 给同样的 114 段对话打分,再把预测结果和参考标签做比较。
指标
两个评估器的核心正确性指标都是平衡准确率(balanced accuracy)。Task Completion 另外还看原始准确率、排名一致性和可重复性。
- 平衡准确率是成功召回率与失败召回率的平均值,即(成功召回率 + 失败召回率)/ 2。每个召回率指对应结果的通话被正确标注的比例。两类等权,可以避免多数类把分数拉偏。
- 原始准确率是评估结论与参考标签一致的通话占比。和平衡准确率不同,它会反映数据集中成功与失败通话的比例。
- Kendall’s τ 衡量评估器给出的 Agent 排名和基准排名之间的一致程度。取值范围是 -1(完全倒序)到 1(顺序完全相同),0 表示整体上没有排名关联。数值越高,排名越一致。
- 配对顺序一致率(pairwise order agreement)是评估器与基准对 Agent 配对排序相同的百分比。12 个 Agent 共构成 66 对。研究同时报告了全部配对的一致率,以及基准通过率相差超过 10 个百分点的"明显分开"配对的一致率。
- 可重复性是指对 4 个 Agent 在相同设置下评估两次时的一致程度。报告内容包括预测结果不变的百分比、平衡准确率的绝对变化,以及 Agent 排名是否保持不变。一致率越高、准确率变化越小,说明判断越稳定。
Task Completion 的结果
单通电话的准确率
在微软内部研究中,以 gpt-5.6-terra 作为 Judge,Task Completion 在保留下来的 τ-Voice 基准通话上取得约 83% 的平衡准确率和 85% 的原始准确率。表 1 汇总了本文保留的 7 个 Judge 在各项指标上的一个报告值。
| 指标 | 取整后的研究数值 |
|---|---|
| 平衡准确率 | 83% |
| 原始准确率 | 85% |
| Kendall’s τ | 0.818 |
| 配对一致率:全部配对 | 91% |
| 配对一致率:差距 > 10 pp | 100% |
| 预测一致率 | 97% |
表 1:来自微软内部研究的 7 种 GPT Judge 配置的跨 Judge 指标汇总。百分比取整到整数,Kendall’s τ 保留三位小数。不同行的数值可能来自不同的 Judge,不能当作同一个配置的结果来读。研究没有做统计显著性检验。
图 1 给出了研究中每个 Judge 与 Agent 组合的平衡准确率。9 行是本文保留的 gpt-realtime、Gemini Live 和级联语音 Agent 配置,7 列是保留的 GPT Judge 配置。这张矩阵只是描述性的,研究没有检验不同 Judge 之间的差异是否显著,也没有检验结果能否推广到这些 trace 之外。
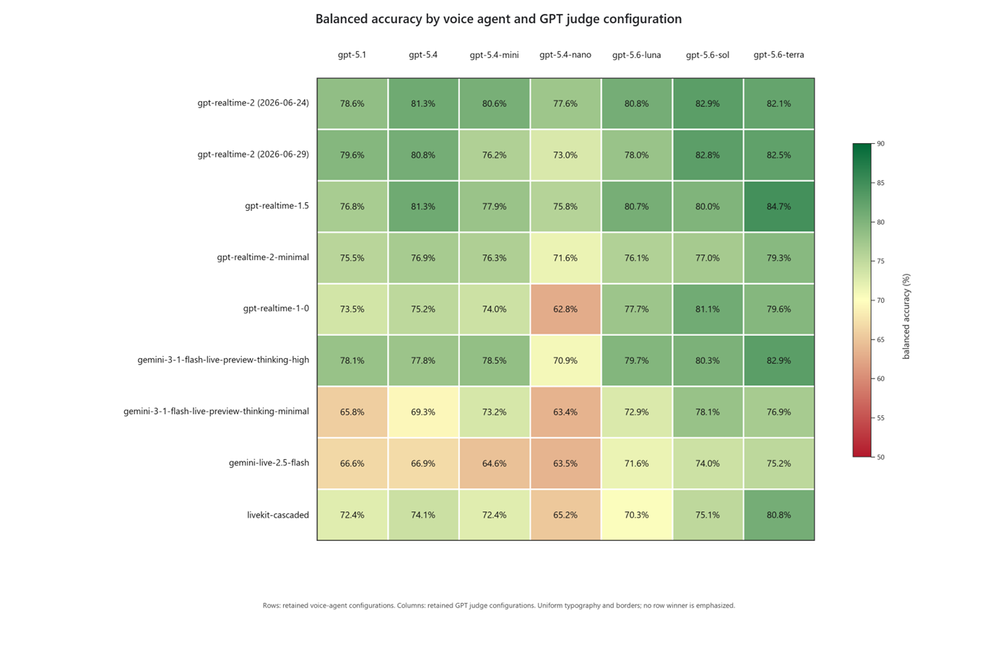
图 1:微软内部研究中 63 个 Judge 与 Agent 组合的描述性平衡准确率。
Agent 排名
很多评估决策关心的是 Agent 之间的先后顺序,而不只是某一通电话有没有通过。研究者按评估器得出的通过率给 τ-Voice 基准数据集中的 12 个 Agent 排序,再和基准排序对比。在本文保留的 7 个 GPT Judge 上,Kendall’s τ 的范围是 0.758 到 0.818。全部 66 个 Agent 配对上观察到的配对一致率最高为 90.9%,7 个 Judge 的平均值是 89.8%。
| Judge | Kendall’s τ | 全部配对一致率 (%) | 差距 > 10 pp 配对一致率 (%) |
|---|---|---|---|
| gpt-5.4-mini | 0.818 | 90.9 | 100.0 |
| gpt-5.4-nano | 0.818 | 90.9 | 100.0 |
| gpt-5.6-luna | 0.818 | 90.9 | 100.0 |
| gpt-5.1 | 0.788 | 89.4 | 100.0 |
| gpt-5.4 | 0.788 | 89.4 | 100.0 |
| gpt-5.6-sol | 0.788 | 89.4 | 100.0 |
| gpt-5.6-terra | 0.758 | 87.9 | 100.0 |
表 2:来自微软内部研究的 7 种 GPT Judge 的描述性 Agent 排名结果。“全部配对"覆盖 12 个 Agent 的全部 66 对。“差距 > 10 pp"只统计基准通过率相差超过 10 个百分点的配对。没有对 Judge 之间的差异做显著性分析。
对于基准通过率相差超过 10 个百分点的配对,7 个 Judge 排出的方向全都和基准一致。出现分歧的,多半是基准通过率本来就接近的配对。这些观察只适用于被测的 Agent、trace、Judge 和排名流程。
不同 Judge 之间的结果
以 gpt-5.6-terra 作为 Judge 时,Task Completion 在 τ-Voice 基准 trace 上的平衡准确率是 82.7%。换成 gpt-5.6-luna 是 80.3%,观察到的差距为 2.4 个百分点。两者对应的 Kendall’s τ 分别是 0.758 和 0.818,配对一致率分别是 87.9% 和 90.9%。这些描述性数据反映的是被测配置的不同侧面。研究没有评估价格、延迟、调用量或经济价值,也没有检验观察到的差异是否显著或等效,所以这些数值并不能推出该用哪个 Judge 作默认选择。
| Agent | Judge | 平衡准确率 (%) |
|---|---|---|
| 全部 Agent | gpt-5.6-terra | 82.7 |
| 另一项实测结果 | gpt-5.6-luna | 80.3 |
| gpt-realtime | gpt-5.6-terra | 82.0 |
| 另一项实测结果 | gpt-5.4-mini | 77.4 |
| Cascaded | gpt-5.6-terra | 80.8 |
表 3:微软内部研究中,按保留的语音 Agent 分组、选取的 GPT Judge 描述性结果。
表 3 里的分数会随语音 Agent 分组而变。使用 gpt-5.6-terra 时,全部基准 Agent 的值是 82.7%,gpt-realtime 是 82.0%,Gemini Live 是 78.6%,级联配置是 80.8%。另外两项实测值是:gpt-5.6-luna 在全部 Agent 上为 80.3%,gpt-5.4-mini 在 gpt-realtime 上为 77.4%。这些描述性差异不能说明某个 Judge 普遍更强,也不能说明是 Agent 架构造成了这些数值。图 1 给出了 9 种语音 Agent 配置对应的完整测量值。
可重复性
为了衡量重复评估的一致性,研究者用本文保留的 7 个 GPT Judge,在设置不变的前提下,对同样 4 种基准语音 Agent 配置各评估了两次。这个子集每个 Judge 恰好包含 1,109 通电话,其中既有 audio-native 配置,也有级联配置。某条判定在两次运行之间发生变化,称为一次预测翻转(prediction flip),一个 Judge 的翻转率就是出现翻转的通话占比。7 个 Judge 的平均预测一致率是 95.1%,平衡准确率的平均绝对变化是 0.8%,观察到的最大变化是 2.4%。
| Judge | 第 1 次平衡准确率 (%) | 第 2 次平衡准确率 (%) | 变化 (%) | 预测翻转 (%) | Agent 排名是否相同 |
|---|---|---|---|---|---|
| gpt-5.6-terra | 82.4 | 80.9 | 1.5 | 6.0 | 是 |
| gpt-5.6-sol | 81.8 | 82.0 | 0.2 | 3.4 | 是 |
| gpt-5.4 | 79.2 | 78.9 | 0.3 | 4.0 | 是 |
| gpt-5.6-luna | 78.9 | 79.9 | 1.0 | 4.2 | 是 |
| gpt-5.4-mini | 78.1 | 75.7 | 2.4 | 8.8 | 否 |
| gpt-5.1 | 77.8 | 77.6 | 0.2 | 4.1 | 是 |
| gpt-5.4-nano | 74.6 | 74.5 | 0.1 | 4.1 | 是 |
表 4:在相同设置下对同一批通话运行两次的结果。平衡准确率的变化根据表中显示的分数计算。预测翻转是单条判定发生变化的百分比。
7 个 Judge 里有 6 个复现了相同的 Agent 排名。gpt-5.6-sol 的翻转率是 3.4%,排名保持不变。gpt-5.4-mini 的准确率变化为 2.4%,翻转率 8.8%,排名发生了变化。这两个例子正好说明为什么预测一致率和排名稳定性要分开报告,它们是两个不同的描述性指标。它们也不能推出模型之间有一个普遍成立的可重复性高低顺序。
Foundry Agent 的结果
研究者把同一个 Task Completion 评估器和同一组 Judge 用到了 278 条 Foundry Agent trace 上,数据集的来源见前面的研究设计。这些通话由一个基于 gpt-realtime-2 的 Foundry 语音 Agent 在 τ-Voice 任务上产生,并通过 Foundry 的可观测性管道采集。
| Judge | 平衡准确率 (%) | 原始准确率 (%) |
|---|---|---|
| gpt-5.6-terra | 80.7 | 80.2 |
| gpt-5.6-luna | 79.4 | 76.4 |
| gpt-5.4 | 79.3 | 77.5 |
| gpt-5.6-sol | 78.2 | 77.8 |
| gpt-5.4-nano | 76.9 | 73.5 |
| gpt-5.4-mini | 76.7 | 76.3 |
| gpt-5.1 | 76.6 | 74.7 |
| 平均(列出的 7 个 Judge) | 78.3 | 76.6 |
表 5:微软内部研究中 7 种 GPT Judge 在保留下来的、来自一个基于 gpt-realtime-2 的 Foundry 语音 Agent 的 τ-Voice 任务 trace 上的 Task Completion 描述性结果。平均行是列出的 7 个 Judge 的平均值。没有计算置信区间,也没有做显著性检验。
在这 278 条 Foundry Agent trace 上,7 个 Judge 的平衡准确率平均为 78.3%,范围是 76.6% 到 80.7%。用 gpt-5.6-terra 时,平衡准确率是 80.7%,原始准确率是 80.2%;而在 τ-Voice 基准 trace 的 gpt-realtime 子集上,平衡准确率是 82.0%。用 gpt-5.6-luna 时,对应的两个平衡准确率分别是 79.4% 和 79.2%。这些数字描述的是两个被测数据集。没有显著性或等效性检验,就不能据此说两者表现相当,也不能据此推荐某个 Judge。
Generated Rubric 的结果
Task Completion 用的是一套统一的"任务是否成功解决"的定义,Generated Rubric 则把用户提供的评估要求翻译成打分标准。研究者在同一批电信对话上测了这两个评估器,描述它们在两种 Judge 配置下的观察得分。
表 6 在同一批保留的 τ-Voice 电信对话上报告了两个评估器的结果,这些对话由一个基于 gpt-realtime-2 的 Foundry 语音 Agent 产生。gpt-5.4 和 gpt-5.6-sol 各自把两个评估器应用到同样的通话上。
| Judge | Rubric 平衡准确率 (%) | Task Completion 平衡准确率 (%) | 差值 (%) |
|---|---|---|---|
| gpt-5.4 | 74.5 | 76.8 | −2.3 |
| gpt-5.6-sol | 78.5 | 76.3 | +2.2 |
表 6:Generated Rubric 与内置 Task Completion 在同一批保留的 τ-Voice 电信对话上的对比,对话由一个基于 gpt-realtime-2 的 Foundry 语音 Agent 产生。rubric 由 gpt-5.4-mini 生成。差值等于 Generated Rubric 的平衡准确率减去 Task Completion 的平衡准确率。
微软内部研究里,以 gpt-5.4 作 Judge 时,Generated Rubric 的平衡准确率是 74.5%,Task Completion 是 76.8%,差值为 −2.3%。换成 gpt-5.6-sol,两者分别是 78.5% 和 76.3%,差值为 +2.2%。研究没有做显著性或等效性检验,所以这些差异既不能说明哪个评估器更好,也不能说明两者准确率相当。
Generated Rubric 的价值在于,团队不用从零写 rubric,就能把自己提供的评估要求转成打分标准。这些要求可以涉及任务结果、预期行为,或者对应用来说重要的其他质量维度。在被测的电信对话上,表 6 给出了观察到的分数。这项研究不能证明它与内置的 Task Completion 准确率相当。
观察结果与研究范围
在这项微软内部研究里,Task Completion 和 Generated Rubric 在特定的 τ-Voice 基准通话、Foundry Agent trace、保留的 GPT Judge 配置和评估器设置下,给出了上面这些描述性数据。这些发现不能证明评估器普遍可靠,不能证明某个 Judge 更优,也不能证明两个评估器等效。它们能做的,是示范在一套明确的评估设置里,怎样去检视单通电话准确率、Agent 排名、重复评估一致性,以及 rubric 特有的标准。
读完我的感受是,这篇文章最诚实的地方就在于反复强调自己没有做显著性检验。80% 出头的平衡准确率对自动化评估来说可以用,但它离"可以完全替代人工抽检"还有距离。在排名上,基准通过率差距超过 10 个百分点的配对,7 个 Judge 全部排对了,真正容易出错的是水平接近的 Agent。所以如果要用这类评估器比较两个版本的语音 Agent,差距很小的时候,我会保留人工复核。
动手试试
想评估自己的语音 Agent,可以在 Microsoft Foundry 里打开项目,挑选能代表你想评估的任务和行为的对话。按照对话评估指南,对完整对话运行 task completion。如果想按自己的要求评估,可以用 rubric 评估器指南生成 rubric,再套用到这些对话上。查看得分和解释,就能知道 Agent 在哪些地方达到预期、哪些地方还需要改进。语音 Agent 可观测性指南介绍了怎样采集和查看对话 trace。
要注意,这里讨论的语音 Agent 可观测性和评估工作流目前处于预览阶段,不提供服务级别协议(SLA),也不建议用于生产工作负载。不同区域和版本的可用性与界面路径可能有差异。
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-10-09-evaluating-voice-agents-how-reliable-are-foundry-s-multi-turn-evaluators/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。