[译]基于模型的机器学习 - 5.6 另一个冷启动问题
当我们绘制电影在特质空间中的位置时(之前的图 5.14),我们只展示了那些位置能被合理准确地知道的电影(也就是后验方差较低的那些)。由此可知,有许多电影的后验方差较大,甚至可能大得多。这意味着我们基本上不知道某些电影在特质空间中的位置。我们可能会预期这些是那些没有很多评分的电影。如果我们不知道某些电影在特质空间中的位置,那么我们可能会预期与这些电影相关的推荐准确性会很低。我们该如何诊断是否属于这种情况呢?
首先,了解每部电影通常有多少评分会很有用。图 5.25 展示了整个数据集中每部电影的评分数量,电影从左边评分最多到右边评分最少排序。
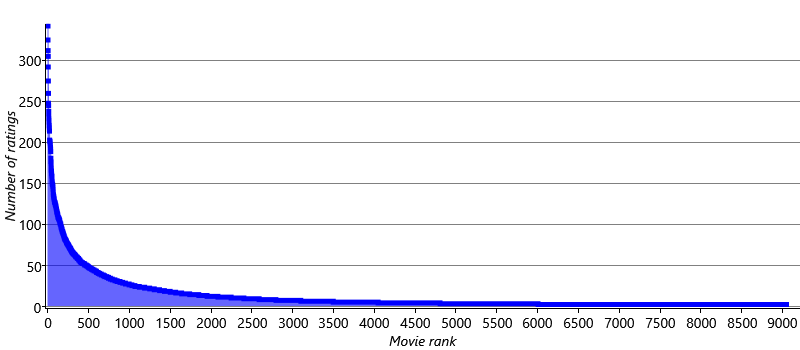
图 5.25:整个数据集中为每部电影给出的评分数量。电影从左边评分最多到右边评分最少排序。
从图 5.25 中,我们可以看到 9000 部电影里只有大约 500 部拥有超过 50 条评分。更仔细地看,只有大约 2000 部电影拥有超过 10 条评分。这就剩下 7000 部电影拥有 10 条或更少的评分——其中约 3000 部只有单独一条评分!如果仅使用评分信息就无法准确地把这样的电影放置在特质空间中,那也并不奇怪。因此,我们可能会预期,对于那些评分很少的电影,我们的预测准确性会低于那些评分很多的电影。
为了证实这个假设,我们可以绘制电影的平均绝对误差,把电影按它们在训练集中的评分数量分组。这幅图展示在图 5.26 中,用于一个含 16 个特质的实验。对于这个实验,我们把那些在训练集中没有任何评分的电影加入了验证集(图 5.26 中最左边的条形)。这提供了一个有用的参照,因为它显示了完全没有评分的电影的 MAE 是多少。图中显示,当我们只有一条评分时(第二个条形),相比零条评分(第一个条形),我们实际上并没有把 MAE 降低多少。对于评分越来越多的电影,平均绝对误差显著下降,如图 5.26 中的第三和第四个条形所示。总体而言,这幅图清楚地显示,我们在预测评分较多的电影的评分方面做得更好——而对那些只有一条评分的电影则做得非常糟糕。
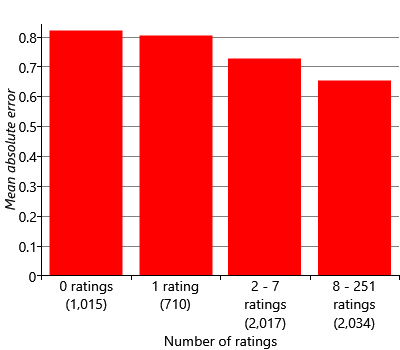
图 5.26:对于一个含 16 个特质的模型,训练集中不同评分数量的电影的平均绝对误差。每个条形都标注了评分的范围,以及括号中落入该范围的电影数量。例如,最左边的条形给出了在训练集中没有评分的电影的 MAE,这样的电影有 1,015 部。比较这四个条形可以看出,评分很多的电影的预测误差远低于那些评分很少或为零的电影。
图 5.26 证实了我们对评分很少的电影存在准确性问题。这在实践中尤其令人担忧,因为新发行的电影很可能评分相对较少,但也很可能是对用户最有用的推荐。那么我们该如何解决这个问题呢?回想上一章的 4.6 节,我们可以把这看作另一个冷启动问题。我们需要能够对一部电影做推荐,即使我们对那部电影只有很少甚至零条评分。
除了评分之外,我们还有哪些其他信息可以用来改善我们的推荐呢?看我们的数据集,我们发现它还包括每部电影的发行年份和所属的类型。这些额外信息的一个样本展示在表 5.4 中。
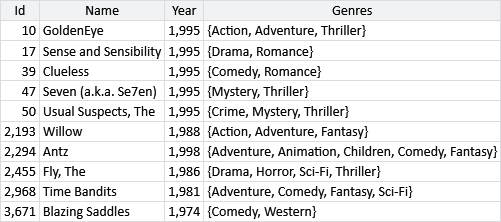
表 5.4:每部电影可用的额外信息的一个样本。
如果我们能够使用这些信息把我们的电影更准确地放置在特质空间中,也许那就能改善我们对那些只有很少评分的电影的推荐。我们可以通过使用特征把这些信息添加到我们的模型中来尝试这一点,就像我们在上一章所做的那样。
向我们的模型添加特征
为了向我们的推荐模型添加特征,我们可以复用第 4.3 节中分类模型的一块。具体来说,我们将为每部电影和每个特征引入 featureValue 变量,以及为每个特征和特质引入一个权重。和之前一样,它们的乘积将给出一个 featureScore。这些特征得分之和现在将成为每个特质的均值。图 5.27 展示了扩展后模型的因子图,其中新添加的部分被突出显示。
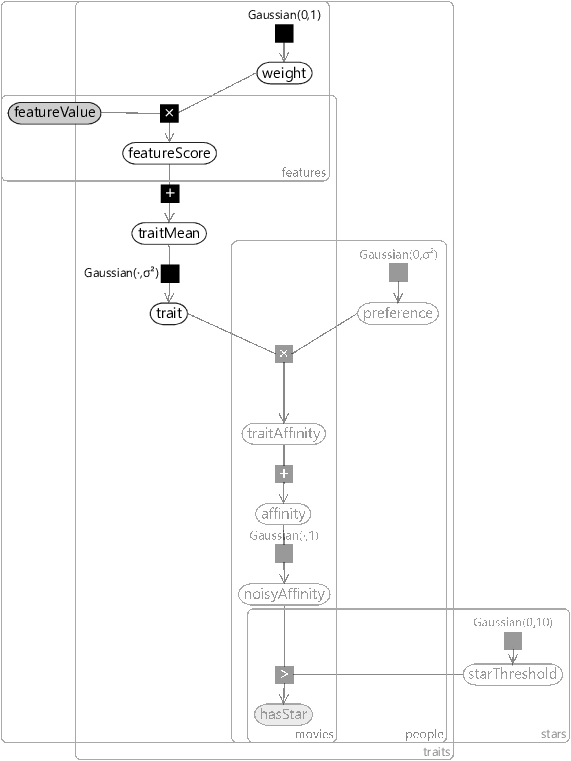
图 5.27:一个能够消费单个电影特征值的推荐模型的因子图。为了强调已添加的变量和因子,图中其余部分已被淡化。
在从上一章取用这一块模型时,我们必须记住,我们也继承了相应的假设。用我们模型的语言来表述,它们是:
7 对于任何电影,特征值总是可以被计算出来。
8 如果一部电影的特征值变化了 $x$,那么每个特质均值会移动 $\mathit{weight}\times x$,其中 $\mathit{weight}$ 是某个固定的、连续的、特质相关的权重。
9 一个特征和特质的权重同样可能为正或为负。
10 单个特征通常对特质均值的影响很小,有时有中等影响,偶尔有很大的影响。
我们在上一章广泛探讨过这些假设,所以这里不再讨论它们。然而,花些时间反思每个假设将如何影响我们推荐系统的行为,会是一个有价值的练习。
和上一章一样,我们需要决定如何把电影信息表示为特征。我们将使用的特征是:
- 一个对所有电影都设为 1.0 的常数特征,用于捕捉任何固定的偏置。
- 一个
ReleaseYear(发行年份)特征,使用分桶来表示,很像我们在 4.4 节设计的BodyLength特征。我们选择的分桶为:到 1980 年为止每十年一桶,此后每五年一桶——总共给出 17 个桶。 - 一个
Genres(类型)特征,其设计与 4.5 节的Recipients特征相同。也就是说,总特征值 1.0 被均分给一部电影所拥有的各个类型。所以如果一部电影是剧情片又是爱情片,那么剧情桶的值会是 0.5,爱情桶的值也会是 0.5。
这个数据集包含关于电影的额外信息,但不包含关于给出评分的人的信息(比如年龄或性别)。如果我们有这样的额外信息,我们就可以使用特征把它纳入我们的模型,就像我们对电影所做的那样。我们所需做的,只是为 preference 先验的均值添加一个特征模型,其形式与图 5.27 中用于特质先验的那个相同。这样得到的模型在电影/特质与人/偏好之间就会是对称的。
使用特征的结果
让我们看看使用电影特征对我们的准确性指标有什么影响。图 5.28 展示了带特征和不带特征的模型,对于评分数量不同的电影分组的平均绝对误差。我们可以看到,添加特征改善了所有四个分组的准确性,其中最大的改善出现在零评分的分组。虽然评分较多的电影仍然有更好的准确性,但使用特征帮助缩小了这些电影与那些可用评分很少的电影之间的差距。
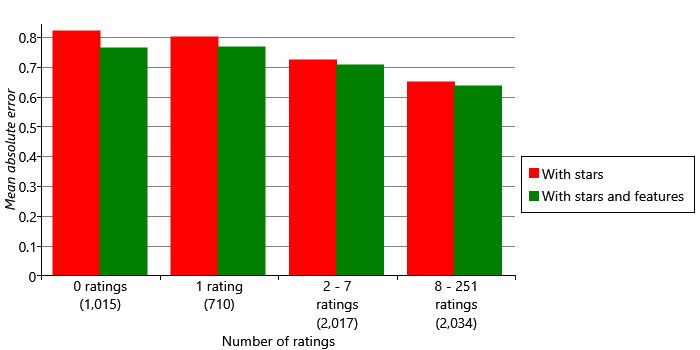
图 5.28:在我们的模型中纳入特征信息降低了预测误差,尤其是对于那些在训练集中没有评分的电影。
我们还可以看使用特征对我们整体指标的影响。这些在图 5.29 中针对不同特质数量展示出来。为了与之前的结果比较,我们再次排除了那些不出现在训练集中的电影的评分(即图 5.28 中最左边的条形)。图表显示,无论我们看哪个指标,特征都提高了准确性。有趣的是,当使用更多特质时,这种提高更大。这一效应的解释是,我们并不是直接使用特征来做推荐,而是间接使用它们把电影定位在特质空间中。使用更多特质帮助我们更精确地捕捉特征信息,因为当特质更多时,特质空间中的一个位置传达了更多信息。
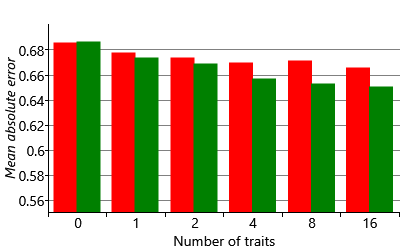
(a) 平均绝对误差(MAE)
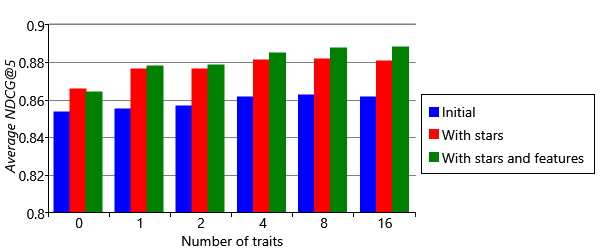
(b) 平均 NDCG@5
图 5.29:我们每个模型的 MAE 和 NDCG 指标的比较。注意,MAE 无法为最初的模型计算,因为它不预测星级评分。根据这些指标,对于任何至少有一个特质的模型,特征都提高了准确性,且使用的特质越多,提高越大。
总体而言,使用特征提供了很好的准确性提升,尤其是对于评分很少的项目。这意味着我们的模型现在应该在为新电影做推荐方面做得好得多——这是一个非常理想的特性!
结语
在本章中,我们开发了一个既能消费喜欢/不喜欢标签、也能消费完整星级评分的推荐模型。这个模型还能利用关于被推荐项目的额外信息。因此,这个模型已经足以为许多 Azure 机器学习的客户带来价值——而且它确实非常接近实际用于 Azure ML 的那个模型。主要的区别是,Azure ML 的模型还能学习个性化的星级评分阈值。这是通过把 starThreshold 变量移入 people 板块、并给每个阈值一个合适的、有信息量的先验来实现的,以应对数据稀缺。
在开发我们的模型时,我们假设一个好的推荐是用户会给该项目打高分的推荐,但事实上情况可能并非如此。一个科幻迷可能会给《星球大战》打高分,但它会是一个糟糕的推荐,因为他们几乎肯定已经看过它了。换句话说,一个好的推荐是针对一部你很可能喜欢、但还没看过的电影。真实的推荐系统会记录一个人通过系统看过哪些电影,这些电影会被自动从任何推荐列表中移除。但这样的系统并不知道在系统之外看过哪些电影。我们可以修改我们的模型,让它既预测一个人是否会喜欢一部电影,又预测他们是否很可能已经看过它。把这两种预测一起使用会带来更有价值的推荐。
相似的项目在特质空间中彼此靠近。
通过学习项目在特质空间中的位置,我们也学到了哪些项目彼此相似,因为这些项目会彼此靠近。给定一个目标项目,我们可以通过搜索特质空间中附近的项目来找到相似的项目。更确切地说,我们可以通过为一个位于与目标项目相同特质空间位置的虚拟人做推荐来做到这一点。这一过程的结果对于做项目相关的推荐很有用,比如“喜欢这部电影的人也喜欢”。项目相关性还可以用来提升一组推荐的多样性。例如,我们可能不想在一个推荐列表中有两部非常相似的电影(比如同一系列的两部电影)。我们可以使用电影在特质空间中的距离来移除这样相似的电影,从而创建一个更多样化的推荐列表。
还有一些能够有用地做出的模型扩展。其中之一是利用关于某个项目的隐式反馈。例如,许多人从不给任何电影评分,而只是观看它们。即使在这种情况下,仍然有关于这个人喜欢哪些电影的有用信息。我们可以假设他们观看的是他们预期会喜欢的电影——所以观看一部电影是这个人喜欢这部电影的一个隐式信号。要获得一个人不喜欢一部电影的隐式信号更难,所以隐式反馈往往只提供正向数据。换句话说,我们只有好的评分,而没有任何差的评分。拥有一个能够应对这种只有正向数据的模型会非常有用——如今最常见的方法是把未评分电影的一个随机样本当作被负向评分来对待。
即使当我们确实有评分时,关于我们拥有哪些评分、以及没有哪些评分的信息也是非常有价值的。拥有一个评分有点像看过一部电影——它提供了一个关于喜欢这部电影的正向信号。表现最好的推荐系统会利用缺失的评分来提供关于一个人喜欢或不喜欢什么的信息。对于任何可能缺失的数据,我们既可以建模数据本身,也可以建模它是否缺失。在下一章中,我们将讨论不同种类的缺失数据以及如何处理它们——在理解儿童哮喘这一非常不同的场景中。
下一章:理解哮喘
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-09-26-mbml-recommender_another_cold_start_problem/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。