[译]基于模型的机器学习 - 5.3 训练我们的推荐系统
在能够训练我们的模型之前,我们需要一些数据来训练它。好消息是,有一些高质量的公开数据集可以用来训练推荐模型。我们将使用明尼苏达大学 GroupLens Research 提供的、极为出色的 MovieLens 数据集之一 [Harper and Konstan, 2015]。我们将使用一个已经免费提供、供教育和开发用途的数据集——谢谢你,MovieLens!你可以自己使用这个链接下载该数据集。
认识我们的数据
与任何新数据集一样,我们的首要任务是认识数据。首先,这里是数据集中 10 条评分的样本:
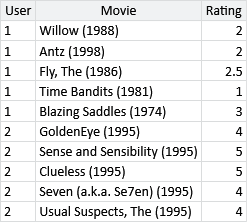
表 5.3:来自 MovieLens 数据集的评分样本。
这个样本显示,每条评分给出了提供评分的人的 ID、被评分的电影,以及这个人给这部电影打的星数。除评分之外,数据集还包含一些关于每部电影的信息——我们稍后会在第 5.6 节中查看这些信息。
以多种不同的方式查看一个新数据集是个好主意,这样可以更深入地理解数据,并尽早识别出任何可能的数据问题。举例来说,让我们画一张图来理解人们给出的是什么样的评分。上面的样本提示我们,评分最高到 5 星,而且允许打半星。为确认这一点并理解每种评分被给出的频率,我们可以绘制数据集中所有评分的直方图。
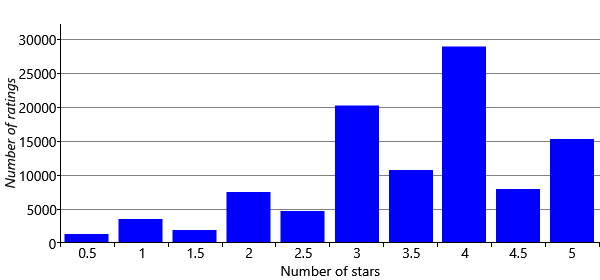
图 5.12:为每一种可能的星数(从半星到五星)所给出的评分数量。
我们可以从图 5.12 中了解到几件事。第一,整星评分比邻近的带半星评分被给出得更多。第二,这张图向右偏,表明人们给出高于三星评分的可能性远大于低于三星。这或许是因为人们对电影很宽厚,尽量给它们不错的评分。另一种可能是,人们只给他们看过的电影评分,而他们只看自己预期会喜欢的电影。例如,某人可能讨厌恐怖片,因此永远不会看它们,也就永远不会给它们评分。如果他们被迫去看这部电影,他们很可能会给它一个非常低的评分。由于人们通常不会被迫看电影,这类评分就不会出现在数据集中,从而导致图 5.12 中看到的那种向右偏的偏置。
缺失数据这个问题是一个重要的问题,我们将在下一章的第 6.2 节中详细讨论它。目前我们只需牢记,这些缺失数据很可能会对我们的预测准确性产生负面影响——因为我们关于某人不喜欢的电影的数据更少。
在 MovieLens 数据上训练
我们已经开发的这个模型允许两种可能的评分:“喜欢”或“不喜欢”。如果我们想在这个模型上使用 MovieLens 数据集,我们就需要一种方法把每个星级评分转换成一个喜欢或不喜欢(稍后我们会看看如何直接使用星级评分)。在图 5.12 的指引下,我们将假设 3 星或更多意味着这个人喜欢这部电影,而 2.5 星或更少意味着他不喜欢这部电影。应用这个变换后,我们就得到了一个喜欢/不喜欢评分的数据集。
我们需要把这些喜欢/不喜欢数据划分为一个用于训练模型的训练集,以及一个用于评估来自模型的推荐的验证集。对每个人,我们将使用他 70% 的喜欢/不喜欢来训练,留下 30% 用于验证。我们还会从验证集中移除那些没有在训练集任何地方出现过的电影的评分(因为这些电影的特质位置无法被学习)。这个过程的结果是:
- 一个包含 69,983 条评分(57,383 条喜欢/12,600 条不喜欢)、覆盖 8,032 部电影的训练集,
- 一个包含 28,831 条评分(23,952 条喜欢/4,879 条不喜欢)、覆盖 4,761 部电影的验证集。
两个数据集都包含来自 671 个不同的人的评分。
为了训练模型,我们把训练集数据附加到 likesMovie 变量上,并再一次使用期望传播来推断每部电影的特质值和每个人的偏好值。然而,当我们试图这样做时,这些变量的后验分布始终保持宽阔,并以零为中心。这是怎么回事?
对称性会引起推断问题。
为理解这个问题的成因,让我们再看一眼图 5.9 中特质空间的图,我们在图 5.13a 中把它重复了一遍。把情感放在左边、动作放在右边,这个选择完全是任意的。我们可以把它们翻转过来,使动作在左、情感在右,同时相应地翻转所有人和电影的位置,如图 5.13b 所示。结果是一个翻转后的特质空间,它给出的预测完全相同。我们还可以把动作/情感特质与逃避现实/写实特质对调,如图 5.13c 所示。同样地,结果会给出完全相同的预测。注意,图 5.13c 也等同于把图 5.13b 向左旋转 90 度。我们还可以应用其他旋转,使图的坐标轴不再与我们原来的特质对齐(图 5.13d),而我们仍然得到相同的预测!当一个模型的变量可以被系统性地变换而不改变所产生的预测时,我们就说这个模型包含对称性(symmetries)。在推断期间,这些对称性会使后验分布变得非常宽阔,因为它们试图同时捕捉特质空间的所有旋转和翻转。毫无帮助!
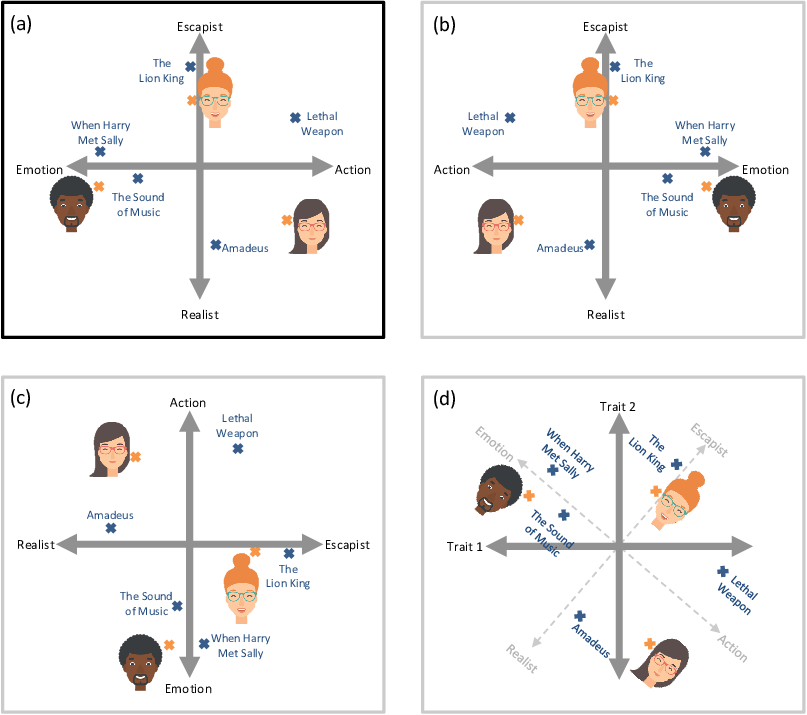
图 5.13:我们推荐模型中对称性的例子。(a) 原始特质空间 (b) 一个左右翻转对称 (c) 一个由对调坐标轴引起的翻转对称 (d) 一个旋转对称。
为解决这个推断问题,我们需要做某种对称性破缺(symmetry breaking)。对称性破缺是指对模型或推断算法所做的任何修改,其目的是从我们所关心的后验分布中移除对称性。对于我们模型的两特质版本,我们可以通过固定特质空间中两个点的位置来破缺对称性——例如,固定训练集中前两部电影的位置。固定这两个点意味着特质空间的旋转和翻转现在会导致不同的结果,因为这两部电影无法被相应地旋转/翻转——于是我们就从模型中移除了对称性。
有了对称性破缺,EP 现在会收敛到一个有意义的结果。然而,由于计算与乘积(×)因子相关的消息代价很高,EP 消息传递算法运行得极其缓慢。在 Stern 等人 [2009] 中,对这些消息使用了 EP 消息计算的一个变体(如该论文中的公式 (6) 所示),其效果是大幅加快了消息计算的速度。
这个更快的推断算法为每部电影和每个人给出了在特质空间中位置的后验。在许多情况下,这些后验相当宽阔,因为没有足够多的评分来把电影或人准确地放置在特质空间中。在图 5.14 中,我们绘制了那些后验足够窄、从而能相当精确地定位的电影的推断位置。具体而言,对每部在每个维度上后验方差小于 0.2 的电影,我们在其后验均值处绘制一个点——这意味着在我们 8,032 部电影中只有 158 部被绘制出来。人在特质空间中被学到的位置,其分布方式与电影的位置大体相似,因此我们就不展示他们位置的图了。
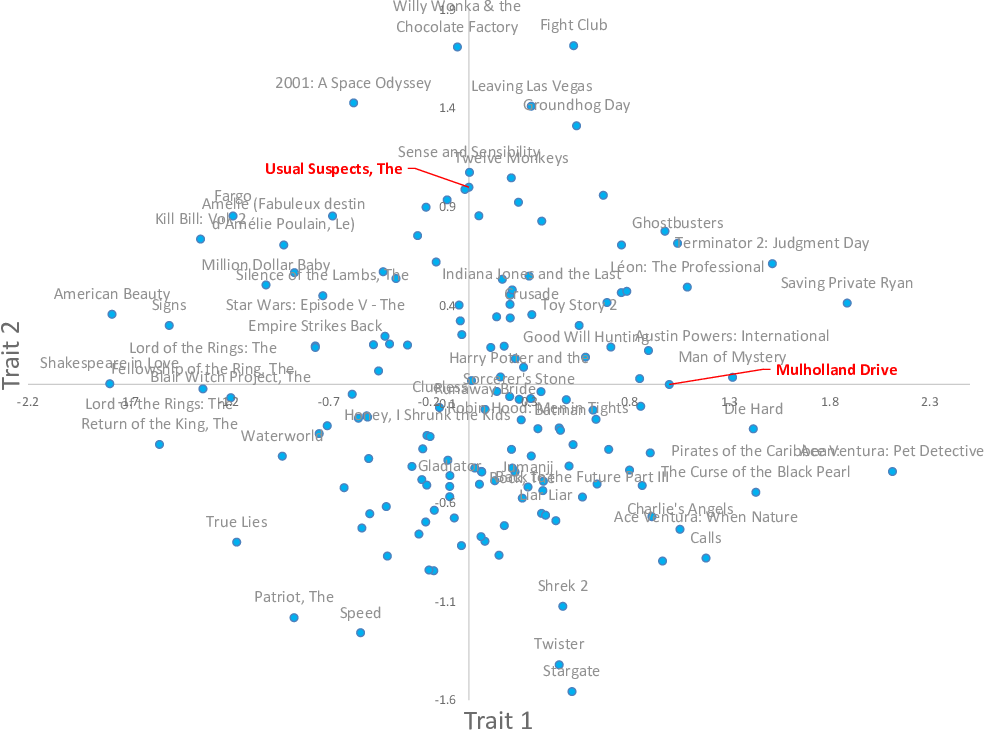
图 5.14:电影在特质空间中被学到的位置。为便于阅读,只有一部分点被标注了电影名称(以对应点为中心)。两部“锚点”电影《非常嫌疑犯》和《穆赫兰道》以红色显示在 (0,1) 和 (1,0) 处。
这张图显示,我们的模型已经能够学到两个特质,并为某些电影赋予这些特质的值,而这完全是使用评分做到的——一项相当不可思议的成就!我们可以看到,学到的特质值有一些令人安心的特征——例如,同一系列的电影被放置在了彼此附近(比如两部《指环王》电影或两部《神探飞机头》电影)。仅这一点就相当不可思议——我们的系统根本不知道这些电影出自同一系列,因为它并没有被给出电影的名称。仅仅使用喜欢/不喜欢评分,它就把这些电影在特质空间中放到了一起!除了这些特征之外,在现阶段很难对这些特质本身作过多的解读。相反,我们只能等到做推荐的时候,再看看它们有多有用。
本页引入概念回顾
对称性(symmetries):模型中的对称性是指模型的某些部分可以互换、或可以彼此等价地起作用。当一个模型包含对称性时,这意味着存在模型变量的多种配置,它们会产生相同的数据。在推断期间,这类对称性会引起问题,因为后验分布会试图同时捕捉所有这些等价的配置,通常会带来无用的结果。当一个模型包含对称性时,通常有必要做某种对称性破缺。
对称性破缺(symmetry breaking):对模型或推断算法所做的修改,以允许移除对称性,从而得到更有用的后验分布。一种典型的对称性破缺方法涉及向消息传递算法中的初始消息添加扰动。其他方法则涉及对模型做出改动以移除对称性,例如固定某些隐变量的值或添加排序约束。
参考文献
[Harper and Konstan, 2015] Harper, F. M. and Konstan, J. A. (2015). The MovieLens Datasets: History and Context. ACM Trans. Interact. Intell. Syst., 5(4).
[Stern et al., 2009] Stern, D., Herbrich, R., and Graepel, T. (2009). Matchbox: Large Scale Bayesian Recommendations. In Proceedings of the 18th International World Wide Web Conference.
下一节:我们的首次推荐
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-09-14-mbml-recommender_training_our_recommender/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。