[译]基于模型的机器学习 - 5.2 多重特质与多人
我们那个只有一个特质的模型,并不能很好地刻画电影。为了看清这一点,让我们再看一眼图 5.4:
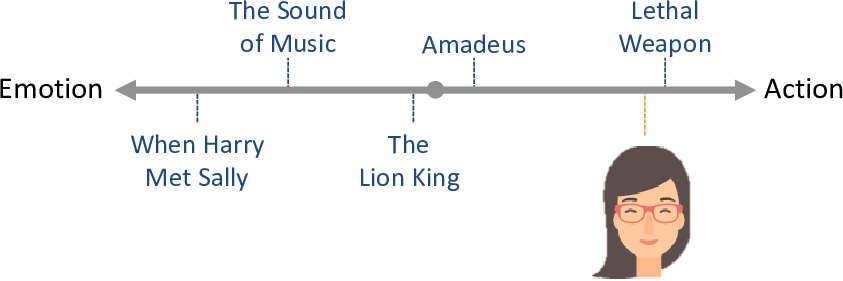
只用动作/情感这一个特质,我们几乎无法区分《狮子王》和《莫扎特传》,因为它们在这条特质线上的位置非常接近。因此,对于这幅图中的这位女士,我们没办法在不同时推荐像《狮子王》这样的电影(她不喜欢)的情况下,去推荐像《莫扎特传》这样的电影(她喜欢)。
我们可以通过使用额外的特质来解决这个问题。如果我们加入第二个特质,表示影片有多逃避现实或多写实,那么每部电影现在除了在原来的特质线上有一个位置外,在这条第二特质线上也会有一个位置。这个第二特质值让我们能够区分这两部电影。为了看清这一点,我们可以把电影展示在一张二维图上,其中逃避现实/写实的特质位置位于纵轴上,如图 5.8 所示。
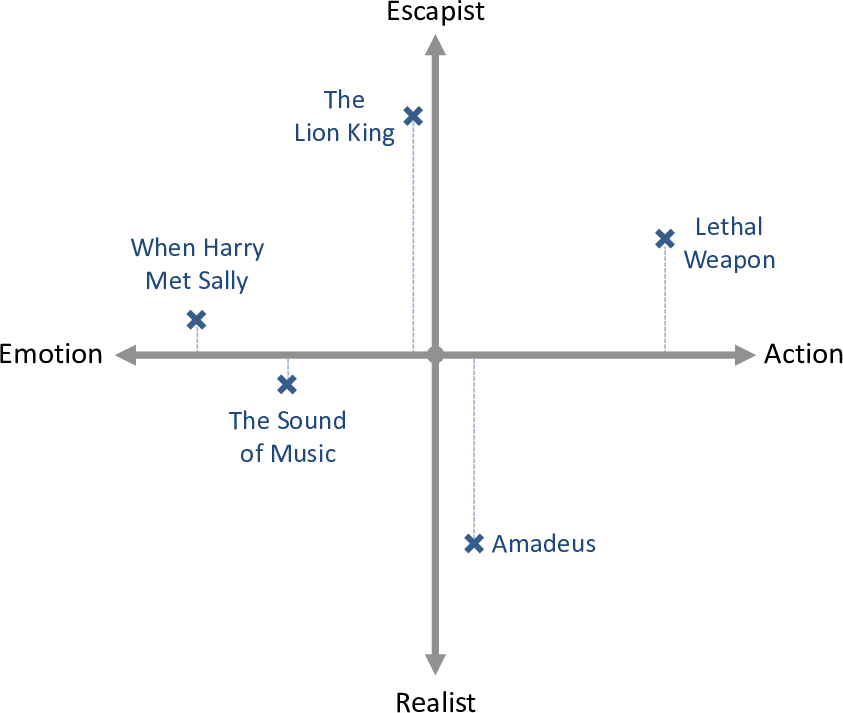
图 5.8:二维图,其中新的纵轴表示一部电影有多逃避现实或多写实。虚线表示电影的水平位置没有改变。
在图 5.8 中,更逃避现实的电影移到了情感/动作线的上方,而更写实的电影移到了下方。这些电影的左右位置相比之前没有改变(如虚线所示)。这个二维空间让《莫扎特传》能够远离《狮子王》,这意味着这两部电影现在可以彼此区分开来。
有了这张二维图,我们就可以通过把每个人适当地放置在情感/动作线的上方或下方,来表示他对更逃避现实还是更写实的电影的偏好,如图 5.9 所示。看这幅图,你可以看到来自图 5.4的那位女士现在已经移到了情感/动作线的下方,因为她偏好更写实的电影。她的偏好点现在离《莫扎特传》比离《狮子王》近得多——这意味着我们的系统现在有可能在不同时推荐《狮子王》的情况下推荐《莫扎特传》。
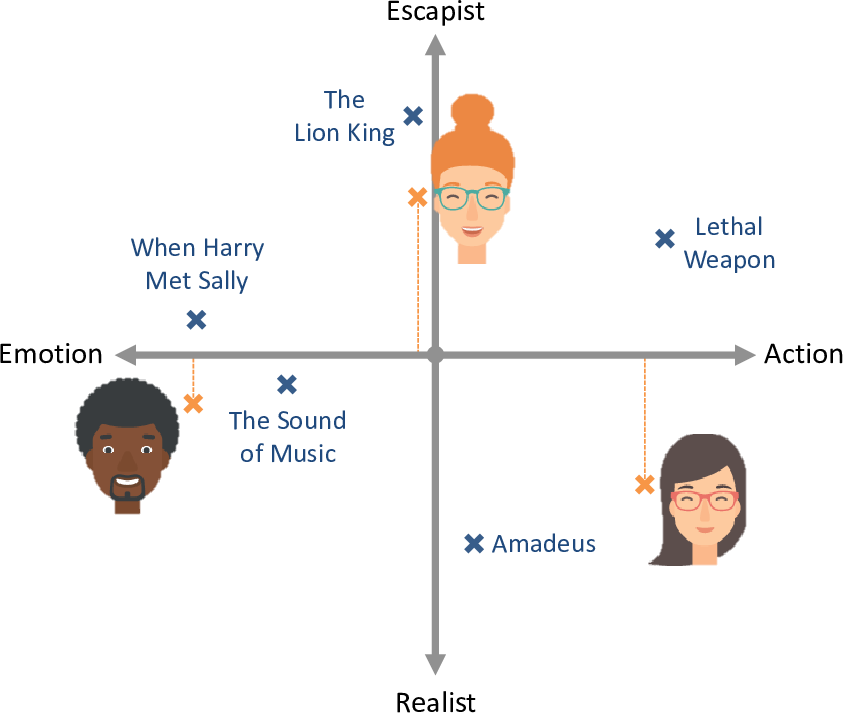
图 5.9:把人放置在二维图上,让我们能够捕捉他们对逃避现实/写实电影的偏好,同时仍然表示他们对情感/动作电影的偏好。
我们现在已经把电影和人放置在了一个二维空间中,我们将把这个空间称为特质空间(trait space)。如果我们有三个特质,那么特质空间就会是三维的,更多特质的情形以此类推。我们可以利用特质空间这个概念来更新我们的前两条假设,以允许多个特质:
- 每部电影都可以由它在特质空间中的位置来刻画,每个特质表示为一个连续数值。
- 一个人的偏好可以由他在特质空间中的位置来刻画,同样地,每个特质表示为一个连续数值。
假设 5.3 不需要改变,因为我们把每个特质和偏好结合起来的方式,与只有一个特质时完全相同。不过,我们确实需要对一个人对不同特质的偏好如何结合成一个整体的 affinity 做一条额外的假设。
- 一个特质值对某人喜欢还是不喜欢一部电影的影响是相同的,无论这部电影具有其他什么样的特质值。
我们可以把这条假设编码进我们的模型:为每个特质计算一个单独的 affinity(我们将称之为 traitAffinity),然后把它们直接加在一起,得到一个整体的 affinity。图 5.10 给出了这个模型的因子图,其中新增了一个 traits 板,包含每部电影的 trait 值、每个人的 preference 和 traitAffinity,表明所有这些变量都按特质被复制。
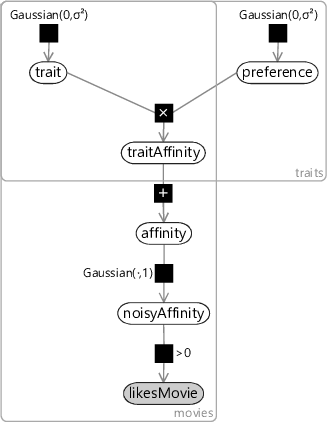
图 5.10:把多个特质结合在一起的因子图。
这个模型结合各个特质的方式,与我们在上一章中结合各个特征的方式完全相同。再一次,它导出了一个非常相似的因子图——为看清这一点,把图 5.10 与图 4.5相比较。主要区别同样在于,我们现在有一个未观测的 trait 变量,而之前我们有的是一个已观测的 featureValue。这看起来似乎是一个很小的区别,但让这个变量成为未观测的,其含义是巨大的。我们现在不再使用那些人工设计、为每件物品提供既定取值的特征,而是要求我们的模型自己去学习这些特质以及特质值!想一想这件事——我们实际上是在要求我们的系统创建它自己的特征集,并为每部电影给这些特征赋值——而这一切仅仅通过使用电影评分就能做到。这件事居然可能做到,看起来简直像魔法一样——但它源自一个定义清晰的模型与一个强大的推断算法的结合。
在这个模型中出现了一个新的复杂之处,与 trait 和 preference 变量的先验方差 $\sigma^2$ 的选择有关。因为我们现在把若干个 traitAffinity 加在一起,我们就有了随着特质数量的变化而改变 affinity 所能取值范围的风险。为了让这个范围大致保持不变,我们设 $\sigma^2 = 1/\sqrt{T}$,其中 $T$ 是特质的数量。这个方差选择背后的直觉是:我们由此会预期 traitAffinity 具有约为 $1/\sqrt{T}\times 1/\sqrt{T}= 1/T$ 的方差。而 $T$ 个这样的量之和会具有约为 $1$ 的方差,这与单个特质的模型相同。
同时向许多人学习
如果我们试图用这个模型,仅根据一个人的数据来推断特质和偏好,那么我们只能了解到这个人评过分的那些电影——很可能没有多少。如果我们把许多人的数据汇集在一起,就能做得好得多,因为这很可能为热门电影提供大量数据,并为绝大多数电影至少提供一点数据。这种方法被称为协同过滤(collaborative filtering)——这个术语由 Tapestry(有史以来第一个推荐系统)的开发者提出。在 Tapestry 中,协同过滤被提出用来处理电子邮件文档,在那里“人们通过记录自己对所读文档的反应来协作,从而帮助彼此进行过滤”[Goldberg et al., 1992]。在我们的应用中,我们想通过记录其他人对他们所看电影的评分(也就是反应)来过滤电影——这是一个不同的应用,但底层原理是相同的。
为了扩展我们的因子图以处理多个人,我们添加一个跨 people 的新板,并把除 trait 变量(它在人之间共享)以外的所有变量都放进去。得到的因子图如图 5.11 所示。看这个因子图,你可以看到它在人和电影之间是对称的。换句话说,我们可以把人和电影对调,最终会得到完全相同的模型!
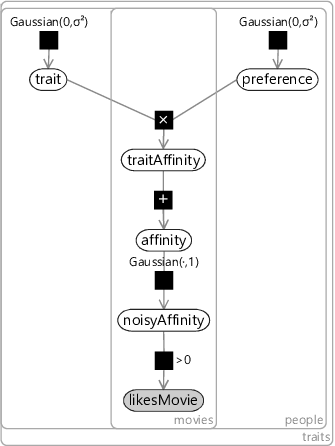
图 5.11:一个推荐模型的因子图,它能够从汇集了许多人的喜欢/不喜欢数据中学习。
在这个模型中,我们选择把 noisyAffinity 在零处做阈值处理,这大致对应于这样一个假设:一半的评分会是“喜欢”,另一半会是“不喜欢”。这是一个相当强的假设,所以我们本可以像对分类器模型那样去学习这个阈值。但我们将做一件更好的事——我们会做一个改动,它实际上允许为每部电影和每个人学习不同的阈值。我们将为每部电影添加一个偏置变量、为每个用户添加一个偏置变量,并在我们计算总的 affinity 时把这两个变量包含进求和中。以这种方式引入偏置,让模型能够捕捉一部电影的总体受欢迎程度,以及每个人总体上有多喜欢电影。例如,如果一个用户几乎喜欢每一部电影,那么他就会得到一个高的用户偏置。类似地,如果一部电影几乎被每个用户喜欢,那么它就会得到一个高的电影偏置。
我们可以在不改变图 5.11 那个因子图的情况下加入偏置——我们所做的只是使用一个比期望特质数量多两个的 traits 板,并把第一个 preference 值和第二个 trait 值固定为恰好 1.0。这样,第一个 trait 值就将是一部电影的偏置,而第二个 preference 值就将是一个人的偏置。我们将用这个技巧在本章的所有模型中加入偏置,但为了保持因子图简单,它们不会在图中显式地展示出来。
我们最后一条假设是:我们的模型中不需要任何更多的变量——或者换一种说法:
- 一个人会喜欢还是不喜欢一部电影,只取决于他对这部电影各特质的偏好,而不取决于其他任何东西。
我们稍后会评估这条假设的有效性,但首先让我们把所有假设放在一处,以便我们能够一并回顾它们(表 5.2)。
表 5.2:我们的推荐模型中所编码的假设。
- 每部电影都可以由它在特质空间中的位置来刻画,每个特质表示为一个连续数值。
- 一个人的偏好可以由他在特质空间中的位置来刻画,同样地,每个特质表示为一个连续数值。
preference取正值意味着这个人偏好trait取正值的电影(负值的情形反之亦然)。preference值的绝对大小表示偏好的强度,其中零表示无所谓。- 一个特质值对某人喜欢还是不喜欢一部电影的影响是相同的,无论这部电影具有其他什么样的特质值。
- 一个人会喜欢还是不喜欢一部电影,只取决于他对这部电影各特质的偏好,而不取决于其他任何东西。
假设 5.1 似乎是合理的,因为理论上我们可以把特质空间做得任意大,以便完整地刻画任何电影——对较少数量的特质而言,这条假设成立的程度会差一些,但但愿它对实际目的来说仍是一个足够好的假设。假设 5.2 假定一个人的口味可以由特质空间中的单个点很好地表示。很有可能,人们可以占据特质空间中的多个点,例如某人可能既喜欢儿童动画片又喜欢非常暴力的电影,却不喜欢介于两者之间的任何东西。然而,可以合理地假设这样的人很少见,因此在大多数情况下,一个人占据单个点是一个不错的假设。
假设 5.3 和假设 5.4 与电影特质和人的特质如何结合在一起产生 affinity 有关。这里也许最值得商榷的假设是假设 5.4,它说每个特质的影响不依赖于其他特质。在实践中,我们可能会预期某些特质会压过其他特质,或者以不寻常的方式结合。例如,如果某人只喜欢由阿诺·施瓦辛格主演的动作片,却不喜欢他出演的所有其他种类的电影——那么这就会被这些假设很糟糕地建模,因为“由阿诺·施瓦辛格主演”这个特质在某些情况下会有正面影响,在另一些情况下会有负面影响。
一个人可能只在一年中的特定时节才喜欢某些电影
最后,我们有假设 5.5,它说某人喜欢还是不喜欢一部电影只取决于他对这部电影各特质的偏好——而事实上它可能取决于许多其他东西。例如,一年中的时节可能是一个因子——某人可能在十二月热爱圣诞电影,却在一月厌恶它们。另一个因子可能是一起看电影的其他人——某人是否喜欢一部电影,很可能取决于是谁和他一起看。沿着这个思路,我们可以想象一个为一群人推荐电影的推荐系统——事实上,例如 Zhang 等人 [2015] 就已经探索过这一点。可能影响一个人观影乐趣的其他东西还包括:一天中的时间或一周中的时间、他们的情绪状态(他们想看一部欢乐的电影还是一部悲伤的?他们想从现实生活中被分散注意力,还是想被挑战?)等等。简而言之,关于假设 5.5 有很多可质疑之处——但暂时坚持它是没问题的,之后再考虑扩展模型以捕捉额外的线索。
所以,让我们暂且保持模型不变,并用它来做一些推荐吧!
本页引入概念回顾
特质空间(trait space):一个多维空间,其中空间里的每个点对应于一件具有特定一组特质值的物品。相邻的点将对应于具有相似特质的物品,而相距较远的点则代表共同点较少的物品。特质空间对于识别相似物品以及做出物品推荐都很有用。关于一个二维特质空间的可视化,见图 5.9。
协同过滤(collaborative filtering):一种为系统的某个用户过滤物品的方法,其依据是该系统的其他用户对物品的隐式或显式评分。例如,根据他人对同一批邮件的反应来过滤邮件,或根据他人对电影的评分来推荐电影。
参考文献
[Goldberg et al., 1992] Goldberg, D., Nichols, D., Oki, B. M., and Terry, D. (1992). Using collaborative filtering to weave an information tapestry. Communications of the ACM, 35:61–70.
[Zhang et al., 2015] Zhang, C., Guiver, J., Minka, T., and Zaykov, Y. (2015). Groupbox: A generative model for group recommendation. Technical report, Microsoft Research.
下一节:训练我们的推荐系统
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-09-10-mbml-recommender_multiple_traits_and_multiple_people/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。