[译]基于模型的机器学习 - 6.3 比较可选模型
在前面所有章节中,我们都假设数据源自单一的潜在过程。但现在我们不能再这样假定了,因为我们预期:会发展出过敏和哮喘的孩子与不会发展出的孩子,遵循的是不同的过程。为了处理这类可选过程,我们需要引入一种新的建模技术。
这种技术将使我们能够:
为了介绍这项新技术,我们暂时把哮喘项目放在一边,转而看一个双过程情形的简单例子(如果你更愿意继续聚焦于哮喘项目,可以直接跳到第 6.5 节)。既然我们身处医学领域,有一个绝佳的双过程情形可用:随机对照试验。随机对照试验是一种临床试验,常用于检验各类医疗干预(如新药)的有效性。在这类试验中,每个受试者被随机分配到治疗组(接受实验性干预)或对照组(不接受干预)。试验的目的是判断实验性干预是否对一个或多个关注的结局有影响,并理解这种影响的性质。
我们这个随机对照试验的目标是弄清一种新药是否有效。
让我们考虑一个简单的试验,检验一种新药治疗某种特定疾病的有效性。我们将使用一个关注的结局——患者是否从疾病中完全康复。用建模的话来说,这个试验的目的是判定以下两种过程中的哪一种发生了:
- 一个药物对患者是否康复没有影响的过程。
- 一个药物对患者是否康复确有影响的过程。
为了判定发生了哪种过程,我们需要为每个过程构建一个模型,然后比较它们,看哪个最符合数据。在两个模型中,数据都相同:每个受试者是否康复。我们可以用二值变量把数据附加到每个模型上,若该受试者康复则为 true,否则为 false。我们把这些二值变量放进两个数组:recoveredControl 包含对照组中每个受试者的变量,recoveredTreated 类似地包含治疗组中每个受试者的变量。
药物无效的模型
让我们从第一个过程(药物无效)的模型开始。在这种情况下,因为药物没有影响,治疗组和对照组之间没有差别。所以我们可以使用这样一个假设:
1 康复的(未知)概率对治疗组和对照组的受试者都相同。
一个受试者完全有可能在没有任何医疗干预(或接受了不起作用的医疗干预)的情况下从疾病中康复。在这个模型中,我们假设药物没有影响,因此所有康复都是这种类型的。我们不知道这种自发康复的概率是多少,因此可以引入一个随机变量 probRecovery 来表示它,并配以均匀的 Beta(1,1) 先验。然后对于 recoveredControl 和 recoveredTreated 数组中的每个变量,我们假设它们都是从以 probRecovery 为参数的 Bernoulli 分布中抽取的。由此得到的模型以因子图的形式展示在图 6.9 中——如需复习像这样的 Beta-Bernoulli 模型,可以回看第 2 章。
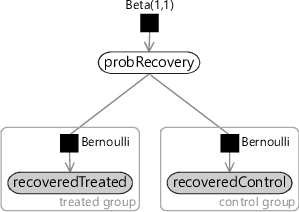
图 6.9:实验药物没有影响的过程的因子图。在这种情况下,治疗组和对照组的康复概率相同。
药物有效的模型
现在我们转向第二个过程,其中药物对患者是否康复确有影响。在这种情况下,我们需要假设治疗组和对照组有不同的康复概率。我们希望治疗组的康复概率更高,但我们不会假设这一点。我们只假设:如果服用了药物,康复概率会发生改变。
2 康复的概率对治疗组的受试者和对照组的受试者是不同的。
为了在因子图中编码这个假设,我们需要两个变量:probTreated 是服用了药物的受试者的康复概率,probControl 是对照组中未服用药物的受试者的康复概率。我们再次为这两个变量各选择一个均匀的 Beta(1,1) 先验。然后对于 recoveredControl 数组中的每个变量,我们假设它们是从以 probControl 为参数的 Bernoulli 分布中抽取的。反过来,对于 recoveredTreated 数组中的每个变量,我们假设它们是从以 probTreated 为参数的 Bernoulli 分布中抽取的。由此得到的模型展示在图 6.10 中。
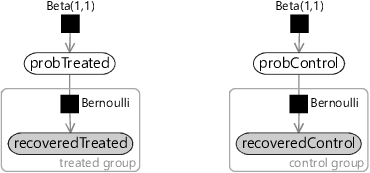
图 6.10:实验药物确有影响的过程的因子图,因此治疗组和对照组的康复概率不同。
比较一下图 6.9 和图 6.10 给出的两个不同过程的模型。你可以看到这两张因子图相当相似。唯一的区别是:“无效”模型只有一个共享的康复概率,而“有效”模型对治疗组和对照组有不同的康复概率。
在两个模型之间做选择
我们现在需要判定这两个模型中的哪一个产生了试验中实际测得的结局。从若干模型中选择哪一个最符合某个特定数据集的任务,称为模型选择(model selection)。在基于模型的机器学习中,如果我们想知道某个未知量的取值,就为该量引入一个随机变量,并推断该变量取值上的后验分布。我们可以用完全相同的方法来做模型选择。让我们考虑一个叫做 model 的随机变量,它有两个可能取值:如果“无效”模型产生了数据则为 NoEffect,如果“有效”模型产生了数据则为 HasEffect。请注意这里隐含的假设:
3 要么是“无效”模型、要么是“有效”模型产生了数据。不考虑任何其他模型。
为简洁起见,我们用 data 指代我们所有的观测数据,也就是 recoveredTreated 和 recoveredControl 这两个数组。然后我们可以用贝叶斯法则(专栏 1.1)来推断在给定 data 时 model 上的后验分布。
模型可以通过模型证据来比较,这个过程称为贝叶斯模型选择。
不出所料,这种用贝叶斯法则来做模型选择的技术被称为贝叶斯模型选择(Bayesian model selection)。
$$P(\text{model} \mid \text{data}) = \frac{P(\text{model})\,P(\text{data} \mid \text{model})}{P(\text{data})}. \tag{6.1}$$在方程 (6.1) 中,左边是我们想要计算的、模型上的后验分布。在右边,$P(\text{model})$ 编码了我们关于哪个模型更可能的先验信念——通常这个先验被选为均匀的,以避免偏袒任何一个模型。同样在右边,$P(\text{data} \mid \text{model})$ 给出了以模型选择为条件的数据的概率。这是随模型而变的、依赖数据的一项,因此它提供了支持或反对每个模型的证据。为此,这个量被称为模型证据(model evidence),有时也简称为证据。
在模型上使用均匀先验时,结果是:model 上的后验分布等于归一化到相加为 1 的模型证据值。换句话说,一个模型的后验概率与该模型的模型证据成正比。为此,在比较两个模型时,通常会看它们模型证据的比值——这个量被称为贝叶斯因子(Bayes factor)。例如,把“有效”模型证据与“无效”模型证据相比较的贝叶斯因子是:
贝叶斯因子越高,说明上方模型(此处为“有效”模型)比下方模型(“无效”模型)更好的证据越强。例如,Kass and Raftery [1995] 建议:贝叶斯因子在 3–20 之间是支持上方模型的正面证据,20–150 之间是强证据,高于 150 是非常强的证据。不过,重要的是要记住,这个证据只是“上方模型优于下方模型”的相对证据——它不是“这是数据的真实模型”甚至“这是数据的一个好模型”的证据。
你也许会担心“有效”模型总会比“无效”模型更受青睐,因为“有效”模型把“无效”模型作为一种特例包含在内(当 probTreated 等于 probControl 时)。这意味着“有效”模型总能拟合由“无效”模型生成的任何数据。所以,即使药物没有影响,“有效”模型仍然能很好地拟合数据。正如我们开始计算贝叶斯因子时将看到的,如果药物没有影响,贝叶斯因子会正确地偏向“无效”模型。
那么,为什么在这种情况下“无效”模型会被青睐呢?这是因为一个被称为奥卡姆剃刀(Occam’s razor,以使其广为流传的奥卡姆的威廉命名)的原则,它可以表述为“当多个解释同样好地拟合一组观测时,偏好最简单的那个”。贝叶斯模型选择通过偏好简单模型(通常是变量更少的模型)而非复杂模型,自动地应用了奥卡姆剃刀。这是因为:一个更复杂的模型能生成比更简单模型更多样的数据集,因此会把更低的概率分配到任何一个特定的数据集上。由此可知,当一个数据集本可以由任一模型生成时,它在更简单模型下会有更高的概率——从而有更高的模型证据。我们将在下一节看到这一效应的实际作用,届时会展示如何为不同的试验结局计算模型证据和贝叶斯因子。
用贝叶斯模型选择比较两个模型
推断深入探究
在这个可选的小节中,我们展示为刚才描述的两个模型做贝叶斯模型选择所需的推断计算。如果你想聚焦于建模,可以放心跳过本节。
接下来我们可以看看如何在随机对照试验中的两个模型之间执行贝叶斯模型选择。作为一个例子,我们将考虑一个有 40 人的试验:对照组 20 人,治疗组 20 人。在这个示例试验中,我们发现治疗组 20 人中有 13 人康复,而对照组 20 人中只有 8 人康复。为了给这个试验做模型选择,我们需要为两个模型各计算模型证据。
计算“无效”模型的证据
让我们先计算“无效”模型的证据,它由 $P(\text{data} \mid \text{model} = \text{NoEffect})$ 给出。记住 data 指代 recoveredTreated 和 recoveredControl 两个数组,我们可以把它更精确地写成 $P(\text{recoveredTreated}, \text{recoveredControl} \mid \text{model} = \text{NoEffect})$。
如果我们写下“无效”模型的联合概率,它看起来是这样的:
$$\begin{aligned} P(&\text{recoveredTreated}, \text{recoveredControl}, \text{probRecovery} \mid \text{model} = \text{NoEffect}) \\ &= \text{Beta}(\text{probRecovery};1,1) \\ &\times \prod_{i \in \text{treated}} \text{Bernoulli}(\text{recoveredTreated}[i] \mid \text{probRecovery}) \\ &\times \prod_{i \in \text{control}} \text{Bernoulli}(\text{recoveredControl}[i] \mid \text{probRecovery}) \end{aligned} \tag{6.3}$$在方程 (6.3) 中,记号 $\prod_{i \in \text{treated}}$ 表示对所包含各项的乘积,其中 $i$ 遍历治疗组中的所有人。请注意,正如我们早在第 2.1 节中学到的,联合概率中每一项都对应图 6.9 因子图中的一个因子。还请注意,在处理多个模型时,我们把联合概率写成以模型选择为条件的形式,此处为 $\text{model} = \text{NoEffect}$。这个条件化明确了我们在为哪个模型写联合概率。
我们可以把这个联合概率大幅简化。首先,我们可以注意到 $\text{Beta}(\text{probRecovery};1,1)$ 是一个均匀分布,因此可以把它去掉(因为乘以一个均匀分布没有影响)。其次,我们可以利用 recoveredTreated 和 recoveredControl 都是观测变量这一事实,把 Bernoulli 项替换为:每个康复的受试者对应 $\text{probRecovery}$,每个未康复的受试者对应 $(1-\text{probRecovery})$。此时定义一些受试者计数会很有帮助。我们把治疗组中康复的人数记为 $T_T$,未康复的人数记为 $T_F$。类似地,把对照组中康复的人数记为 $C_T$,未康复的人数记为 $C_F$。
这个联合概率 $P(\text{recoveredTreated}, \text{recoveredControl}, \text{probRecovery} \mid \text{model} = \text{NoEffect})$ 与我们试图计算的模型证据 $P(\text{recoveredTreated}, \text{recoveredControl} \mid \text{model} = \text{NoEffect})$ 相当相似。区别在于联合概率里包含了 probRecovery 变量。为了计算模型证据,我们需要通过边缘化(积分)把这个变量消去。
为了求这个积分,我们可以把它与 beta 分布的概率密度函数相比较,后者我们早在方程 (2.22) 中引入过:
$$\text{Beta}(x;\alpha,\beta) = \frac{x^{\alpha-1}(1-x)^{\beta-1}}{\mathrm{B}(\alpha,\beta)} \tag{6.6}$$我们知道这个密度函数的积分为 1,因为任何概率密度函数下的面积都必须为 1。我们在方程 (6.5) 中的模型证据看起来像是一个 $\alpha=T_T+C_T+1$、$\beta=T_F+C_F+1$ 的 beta 分布的积分,只是它没有除以归一化的 beta 函数 $\mathrm{B}(\alpha,\beta)$。如果我们确实除以 $\mathrm{B}(\alpha,\beta)$,积分就会是 1。既然我们没有除,那么对于上述 $\alpha$ 和 $\beta$ 的取值,积分就必定等于 $\mathrm{B}(\alpha,\beta)$。换句话说,模型证据等于 $\mathrm{B}(T_T+C_T+1,T_F+C_F+1)$。
对于我们例子中的计数,这个模型证据是 $\mathrm{B}(13+8+1,7+12+1)$,即 $\mathrm{B}(22,20)$。
计算“有效”模型的证据
“有效”模型的模型证据计算其实相当类似。同样地,我们写下联合分布,现在以 $\text{model} = \text{HasEffect}$ 为条件,这表明这是“有效”模型的联合分布:
$$\begin{aligned} P(&\text{recoveredTreated}, \text{recoveredControl}, \text{probTreated}, \text{probControl} \mid \text{model} = \text{HasEffect}) \\ &= \text{Beta}(\text{probTreated};1,1) \\ &\times \text{Beta}(\text{probControl};1,1) \\ &\times \prod_{i \in \text{treated}} \text{Bernoulli}(\text{recoveredTreated}[i] \mid \text{probTreated}) \\ &\times \prod_{i \in \text{control}} \text{Bernoulli}(\text{recoveredControl}[i] \mid \text{probControl}) \end{aligned} \tag{6.7}$$我们可以通过去掉均匀 beta 分布、并再次使用每组中康复/未康复受试者的计数来简化这个表达式:
$$\begin{aligned} &P(\text{recoveredTreated}, \text{recoveredControl}, \text{probTreated}, \text{probControl} \mid \text{model} = \text{HasEffect}) \\ &= \text{probTreated}^{T_T}(1-\text{probTreated})^{T_F} \times \text{probControl}^{C_T}(1-\text{probControl})^{C_F} \end{aligned} \tag{6.8}$$请注意,在这个模型里我们有两个额外的变量需要通过边缘化消去:probTreated 和 probControl。为了对这些额外变量做积分,我们可以使用与之前相同的技巧,只是现在我们有两个 beta 密度:一个关于 probTreated,一个关于 probControl。由此得到的模型证据是:
对于我们例子中的计数,这个模型证据是 $\mathrm{B}(13+1,7+1)\mathrm{B}(8+1,12+1)$,化简为 $\mathrm{B}(14,8)\mathrm{B}(9,13)$。
计算“有效”模型相对“无效”模型的贝叶斯因子
现在我们有了两个模型各自的模型证据:
$$P(\text{data} \mid \text{model}=\text{NoEffect}) = \mathrm{B}(T_T+C_T+1,T_F+C_F+1)$$$$P(\text{data} \mid \text{model}=\text{HasEffect}) = \mathrm{B}(T_T+1, T_F+1) \times \mathrm{B}(C_T+1, C_F+1)$$这些模型证据值可以代入方程 (6.1),以计算 model 变量上的后验分布。
让我们为示例试验计算贝叶斯因子,其中对照组 20 人中有 8 人康复,而治疗组 20 人中有 13 人康复:
$$\text{Bayes 因子} = \frac{P(\text{data} \mid \text{model}=\text{HasEffect})}{P(\text{data} \mid \text{model}=\text{NoEffect})} = \frac{\mathrm{B}(14,8)\,\mathrm{B}(9,13)}{\mathrm{B}(22,20)} = 1.25 \tag{6.10}$$仅为 1.25 的贝叶斯因子表明“有效”模型比“无效”模型只是略微更受青睐,但证据非常微弱。请注意,这并不意味着药物没有效果,而是我们尚未可靠地证明它确有效果。根本问题在于这个试验太小,无法为药物的效果提供强有力的证据。我们将在下一节探讨增大试验规模对贝叶斯因子的影响。
早些时候,我们声称:在药物确实没有效果的情况下,贝叶斯因子会正确地偏向“无效”模型。为了证明这一点,让我们考虑一个药物确实没有效果的试验,它导致对照组和治疗组都是 8/20 康复的结局。在这种情况下,贝叶斯因子由下式给出:
$$\text{Bayes 因子} = \frac{P(\text{data} \mid \text{model}=\text{HasEffect})}{P(\text{data} \mid \text{model}=\text{NoEffect})} = \frac{\mathrm{B}(9,13)\,\mathrm{B}(9,13)}{\mathrm{B}(17,25)} = 0.37 \tag{6.11}$$现在我们得到一个小于 1 的贝叶斯因子,这意味着尽管两个模型同样好地拟合了数据,“无效”模型还是被青睐于“有效”模型。贝叶斯模型选择偏好更简单模型的这种倾向,对于在实际应用中选出正确的模型至关重要。正如这个例子所示,没有它,我们就无法分辨出一种药物不起作用!关于这种偏好更简单、更不灵活模型的更多解释,可以看看下一章的第 7.3 节。
我们刚刚看到的模型证据计算有一种熟悉的形式。我们引入了一个叫做 model 的随机变量,然后用贝叶斯法则来推断该随机变量上的后验分布。然而,model 这个随机变量并没有出现在任何因子图中,我们是手工计算它的后验分布的,而不是使用通用的消息传递算法。如果这个后验分布可以通过定义一个包含 model 变量的模型、并在该模型上运行标准的推断算法来计算,那将会更简单、更容易、也更一致。在下一节中,我们将展示这可以用一种叫做门(gate)的建模结构来实现。
本页引入的概念回顾
随机对照试验(randomised controlled trial) 一种临床试验,常用于检验各类医疗干预(如新药)的有效性。在这类试验中,每个受试者被随机分配到治疗组(接受实验性干预)或对照组(不接受干预)。试验的目的是判断实验性干预是否对一个或多个关注的结局有影响,并理解这种影响的性质。
模型选择(model selection) 从若干模型中选择哪一个最符合某个特定数据集的任务。模型选择之所以有帮助,不仅因为它能让人使用最好的模型,还因为识别出最好的模型有助于理解产生该数据集的过程。
贝叶斯模型选择(Bayesian model selection) 通过计算“在给定数据集条件下、模型选择上的后验分布”来做模型选择的过程。贝叶斯模型选择不是给出单个“最佳”模型,而是为每个模型返回一个概率,这些概率的相对大小可用于评估每个模型拟合优度的相对高低。
模型证据(model evidence) 以模型选择为条件的数据的概率,换句话说就是 $P(\text{data} \mid \text{model})$。这个条件概率提供了支持或反对某个模型是产生数据集的那个模型的证据,因此得名“模型证据”。比较不同模型的模型证据值就可以做贝叶斯模型选择。由于它是一个常用概念,模型证据常被简称为“证据”。
贝叶斯因子(Bayes factor) 某个关注模型的模型证据与另一个模型(通常是基线或“零”模型)的模型证据之比。贝叶斯因子越高,相对于基线模型,对所提出模型的支持就越大。
奥卡姆剃刀(Occam’s razor) 当多个解释同样好地拟合一组观测时,偏好最简单的那个。它以奥卡姆的威廉命名,他在其哲学论证中使用了这一原则。不过,这个概念并非他所发明,早在亚里士多德(公元前 384—322 年)时就有相关表述。
下一节:用门建模
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-10-17-mbml-asthma_comparing_alternative_models/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。