Machine Learning 中的文章

[译]基于模型的机器学习 - 6.3 比较可选模型

在前面所有章节中,我们都假设数据源自单一的潜在过程。但现在我们不能再这样假定了,因为我们预期:会发展出过敏和哮喘的孩子与不会发展出的孩子,遵循的是不同的过程。为了处理这类可选过程,我们需要引入一种新的建模技术。

这种技术将使我们能够:

  • 在单个模型中表示多个可选过程;
  • 评估每个可选过程产生某个特定数据项(例如某个特定孩子的数据)的概率;
  • 比较两个或更多不同的模型,看看哪一个最能解释某些数据。

为了介绍这项新技术,我们暂时把哮喘项目放在一边,转而看一个双过程情形的简单例子(如果你更愿意继续聚焦于哮喘项目,可以直接跳到第 6.5 节)。既然我们身处医学领域,有一个绝佳的双过程情形可用:随机对照试验。随机对照试验是一种临床试验,常用于检验各类医疗干预(如新药)的有效性。在这类试验中,每个受试者被随机分配到治疗组(接受实验性干预)或对照组(不接受干预)。试验的目的是判断实验性干预是否对一个或多个关注的结局有影响,并理解这种影响的性质。

……
阅读全文

[译]基于模型的机器学习 - 6.2 试验模型

现在我们有了一个完整的模型,可以在一些研究数据上试验它了。正如本书前面多次强调的,在使用真实数据集时,务必仔细查看数据集,确保它是完整、正确且符合你预期的形式。请记住,许多常见的机器学习问题都是由数据问题引起的(例如第 2.5 节中列举的那些)。检查数据集的一个好办法是构建可视化,让你一眼就能看清它的样子。在本例中,我们需要为每个孩子、每种过敏原和每个时间点创建检测结果的可视化。然而,这个研究数据集包含私密的医疗数据,因此我们无法在本书中公开分享这些数据,哪怕是以可视化的形式。从这次可视化中我们学到的最重要一点是:数据集中有大量检测结果缺失。

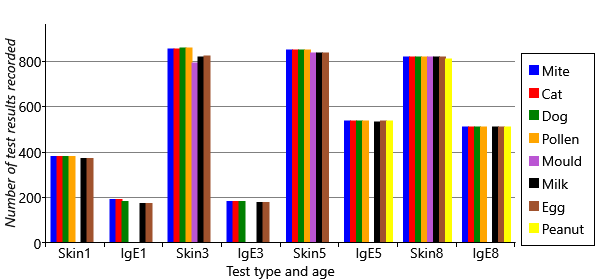
当存在缺失数据时,总是值得分析一下它们为什么缺失。在图 6.6 中,我们绘制了数据集中每个年龄、每种检测类型的检测结果数量(无论阳性还是阴性)。

图 6.6

图 6.6:为两类检测各自记录的检测结果,按孩子的年龄拆分。

你可以在图 6.6 中看到几种不同的缺失数据模式。首先,图中显示某些年龄和检测类型对特定过敏原完全没有数据。例如,花生在 1 岁和 3 岁完全没有结果,5 岁时只有 IgE 结果。霉菌完全没有 IgE 结果,1 岁时也没有皮肤试验结果。其次,越早的年龄缺失数据越多,尤其是 1 岁。第三,图中显示 IgE 检测总体上比皮肤试验缺失得多。我们需要把所有这些缺失数据点的影响考虑进来。

……

阅读全文

[译]基于模型的机器学习 - 6.1 过敏模型

我们的首要目标是通过在 MAAS 数据中寻找规律,来加深对过敏发展(及其与儿童哮喘之间关系)的理解。为了理解本研究中的相关数据,我们需要先了解一点关于过敏诊断的知识。研究中的医生使用两类检测来尝试判断一个人是否对某种特定的过敏原(如猫毛或花生)过敏。这两类检测是:

皮肤点刺试验,即把一滴过敏原溶液滴在患者的皮肤上(见下图),然后用针刺破皮肤。如果皮肤出现免疫反应,表现为一定大小的红色隆起,则该检测为阳性,否则为阴性。

……

阅读全文

[译]基于模型的机器学习 - 6 理解哮喘

在全球范围内,每年约有 450,000 人死于哮喘。如果我们能够更好地理解是什么导致人们患上哮喘,这将对哮喘的检测、诊断和治疗产生巨大的积极影响。基于模型的机器学习能否帮助我们获得这种更深入的理解呢?

哮喘

哮喘是一种非常常见的疾病,在英国约有 5% 的人受其影响 [Anderson et al., 2007],在美国这一比例约为 7% [Fanta, 2009]。对于患者而言,哮喘可能造成极其严重的后果。发展成哮喘的一个已知风险因子是这个人是否患有过敏,但过敏与哮喘之间的关系尚未被充分理解。若能加深对这一关系的理解,就有可能实现对那类可能导致住院乃至更糟后果的严重哮喘的早期检测。

曼彻斯特哮喘与过敏研究(Manchester Asthma and Allergy Study,MAAS)是一项旨在帮助理解儿童哮喘和过敏成因的研究 [Custovic et al., 2002]。具体而言,该研究的目标是理解为什么有些患有过敏的儿童会发展成哮喘,而另一些却不会。MAAS 是一项出生队列研究——换句话说,参与者是在出生时被招募进入研究的——共包含约 1,000 人。该研究始于 1995 年,并持续至今,不断收集有关研究参与者的最新数据,如今这些参与者已是青年人。可以想见,这些参与者及其家庭为此付出了巨大的奉献与投入——我们和研究团队都对他们心怀由衷的感激!

……

阅读全文

[译]基于模型的机器学习 - 5.6 另一个冷启动问题

当我们绘制电影在特质空间中的位置时(之前的图 5.14),我们只展示了那些位置能被合理准确地知道的电影(也就是后验方差较低的那些)。由此可知,有许多电影的后验方差较大,甚至可能大得多。这意味着我们基本上不知道某些电影在特质空间中的位置。我们可能会预期这些是那些没有很多评分的电影。如果我们不知道某些电影在特质空间中的位置,那么我们可能会预期与这些电影相关的推荐准确性会很低。我们该如何诊断是否属于这种情况呢?

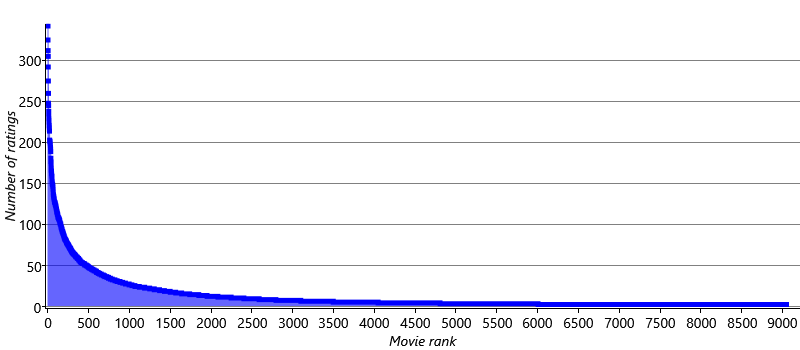
首先,了解每部电影通常有多少评分会很有用。图 5.25 展示了整个数据集中每部电影的评分数量,电影从左边评分最多到右边评分最少排序。

图 5.25

图 5.25:整个数据集中为每部电影给出的评分数量。电影从左边评分最多到右边评分最少排序。

……

阅读全文

[译]基于模型的机器学习 - 5.5 建模星级评分

星级评分

我们的模型把完整的星级评分范围变成了简单的喜欢或不喜欢,这意味着它丢弃了大量有用的信息。给一部电影打 3 星和打 5 星之间有天壤之别,然而我们却把这两种情况同等对待。为了利用不同的星级评分,我们需要改变模型,使其能够处理完整的评分范围,而不是二值的喜欢/不喜欢。这不仅让我们能够在星级评分上训练,还让我们能够预测星级评分——一举两得!

我们可以在已经设计好的二值喜欢/不喜欢模型的基础上做出这一改变。在这个模型中,我们有一个 affinity(好感度)变量,它是一个连续的数字,表示一个人对一部电影的喜欢程度。目前我们在零处对这个好感度取阈值,说大于零的值意味着这个人喜欢这部电影,小于零的值意味着他们不喜欢这部电影。为了建模不同的星级评分,我们可以假设更高的好感度意味着一个人会给出更高的星级评分。更确切地说,我们现在不再只在零处取阈值,而是为每一个星级评分引入一个阈值。如果一个人对一部电影的好感度高于某个特定星数的阈值,那么我们就预期他们会给这部电影至少那么多星。

……

阅读全文

[译]基于模型的机器学习 - 5.4 我们的首次推荐

竖起或放下大拇指

有了我们训练好的两特质模型,我们现在准备好做一些推荐了!在训练期间,我们学到了每部电影和每个人在特质空间中(不确定的)位置。我们现在可以为验证集中每一条被留出的评分做预测。我们一次做一条评分——也就是说,一次针对一个人和一部电影。首先,我们把电影 trait 和人的 preference 的先验设为训练期间学到的后验。然后我们运行期望传播来推断 likesMovie 上的后验分布,以计算这个人会喜欢这部电影的概率。在验证集中所有评分上重复这一过程,就得到了每个人喜欢每部电影的概率,如图 5.15a 所示。图 5.15b 显示了对应的真实标签喜欢/不喜欢的值。

图 5.15a 推断的喜欢概率

(a) 推断的喜欢概率

图 5.15b 真实标签喜欢/不喜欢

(b) 真实标签喜欢/不喜欢

图 5.15:我们推荐模型的初步结果。(a) 计算得到的每个人喜欢每部电影的概率。白色方块对应概率 1.0,黑色对应概率 0.0,灰色的深浅表示介于两者之间的概率值。(b) 真实标签——白色表示这个人喜欢这部电影,黑色表示他不喜欢。

从图 5.15b 中最先引人注意的一点是,人们大多喜欢电影,而不是不喜欢它们。因此从某种意义上说,我们给推荐系统设定的任务,是试图找出一个人不喜欢的少数几部电影。看图 5.15a 中预测的概率,我们可以在这个任务上看到一些成功——因为某些较暗的方块确实与真实标签中的黑色方块正确对齐了。此外,某些行总体上比平均更暗或更亮,表明我们能够学到每个人总体上有多可能喜欢或不喜欢电影。然而,这些预测并不完美——有许多不喜欢的电影被漏掉了,也有一些不喜欢的预测是错误的。但在我们对模型做任何改进之前,我们需要先决定用哪些评估指标来度量和追踪这些改进。

……

阅读全文

[译]基于模型的机器学习 - 5.3 训练我们的推荐系统

在能够训练我们的模型之前,我们需要一些数据来训练它。好消息是,有一些高质量的公开数据集可以用来训练推荐模型。我们将使用明尼苏达大学 GroupLens Research 提供的、极为出色的 MovieLens 数据集之一 [Harper and Konstan, 2015]。我们将使用一个已经免费提供、供教育和开发用途的数据集——谢谢你,MovieLens!你可以自己使用这个链接下载该数据集。

认识我们的数据

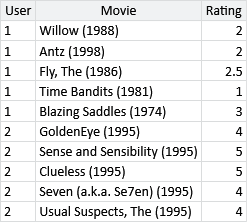
与任何新数据集一样,我们的首要任务是认识数据。首先,这里是数据集中 10 条评分的样本:

表 5.3

表 5.3:来自 MovieLens 数据集的评分样本。

……

阅读全文

[译]基于模型的机器学习 - 5.2 多重特质与多人

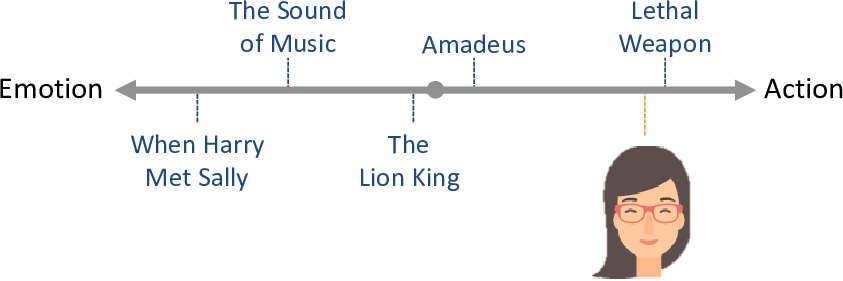
我们那个只有一个特质的模型,并不能很好地刻画电影。为了看清这一点,让我们再看一眼图 5.4:

图 5.4

只用动作/情感这一个特质,我们几乎无法区分《狮子王》和《莫扎特传》,因为它们在这条特质线上的位置非常接近。因此,对于这幅图中的这位女士,我们没办法在不同时推荐像《狮子王》这样的电影(她不喜欢)的情况下,去推荐像《莫扎特传》这样的电影(她喜欢)。

我们可以通过使用额外的特质来解决这个问题。如果我们加入第二个特质,表示影片有多逃避现实或多写实,那么每部电影现在除了在原来的特质线上有一个位置外,在这条第二特质线上也会有一个位置。这个第二特质值让我们能够区分这两部电影。为了看清这一点,我们可以把电影展示在一张二维图上,其中逃避现实/写实的特质位置位于纵轴上,如图 5.8 所示。

……

阅读全文

[译]基于模型的机器学习 - 5.1 学习用户和电影

本章的目标是向特定的人做出个性化的电影推荐。思考这个问题的一种方式,是想象一张表格,其中行是电影、列是人。表格的单元格显示这个人喜欢还是不喜欢这部电影——例如,如表 5.1 所示。这张表格是一个例子,展示了我们用来训练推荐系统时可能拥有的那类数据:我们询问了若干人,让他们说出自己是喜欢还是不喜欢某些特定的电影。

……

阅读全文

最近文章

分类

标签

友情链接

其它