Machine Learning 中的文章

[译]基于模型的机器学习 - 3.3 一个解法:期望传播

我们已经看到,置信传播使我们能够在图 3.10 的模型中计算变量 Jskill 的精确边缘后验分布。虽然 Jskill 的先验分布是一个由两个参数描述的高斯,但后验分布不是高斯,而是一个需要四个参数的更复杂分布。为阻止参数数量在每局游戏后不断增加,我们需要一种方法用具有固定数量参数的分布来近似这个真实的后验,为此我们选择高斯。这样后验分布就会与先验具有相同的函数形式,模仿共轭先验的行为。如果我们能做到这一点,就能把所得的近似后验分布当作下一局游戏的先验分布。这样,每个玩家的技能将始终由一个仅受两个参数支配的高斯分布表示。

第一个问题是如何用一个高斯来近似一个非高斯分布。一个简单的解法是求出该非高斯分布的均值和方差,然后选一个具有相同均值和方差的高斯作为我们的近似。事实证明这是一个合理的近似,它可以通过优化两个概率分布不相似性的某种度量来形式化地推导出来 [Bishop, 2006; Minka, 2005]。

我们也许会因此想干脆直接用一个高斯来近似 Jskill 的精确后验分布。虽然这对图 3.10 的因子图会令人满意地奏效,但当我们转向更复杂的因子图(例如本章后面将遇到的那些)时,它又会失效。具有简单函数形式的消息在穿过因子后往往会变得更复杂。当我们把模型扩展到更大、更精巧的图时,很快就会遇到消息无法被精确计算的情形。这类问题可以通过在每个因子节点处局部地做近似来避免,从而使所有消息都具有所需的分布类型。这确保了只要每个因子都能使用适当的分布类型向所有相邻的变量节点发送近似消息,因子就可以被组合成任意的图。

下面这一小节会深入这类近似推断算法的数学细节。如果你想跳过这些细节,尽可直接看下一节。

推断深入探讨

在这个可选小节中,我们引入期望传播这一近似推断技术,我们将在本书中广泛使用它。如果你想专注于建模,尽可跳过本小节。

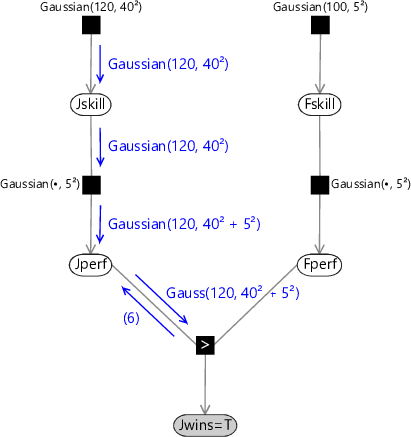
回到图 3.12(为方便起见在图 3.21 中重现),我们看到消息 (6) 是我们遇到的第一个非高斯消息。
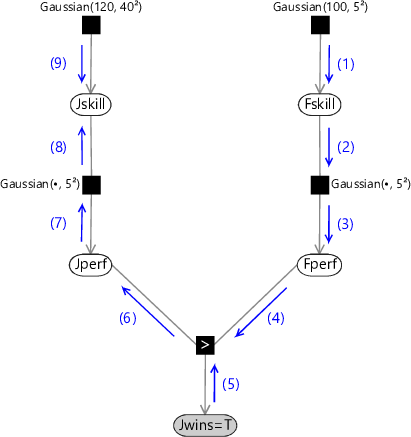
图 3.21

图 3.21:在应用置信传播计算 Jskill 更新分布时出现的消息。(重现自图 3.12。)

因此我们的目标是用一个高斯来近似消息 (6),从而确保所有后续消息也都是高斯分布。

尽管这似乎是一个可取的目标,但也似乎存在一个重大障碍——如图 3.17 所示,消息 (6) 的精确形式看起来一点也不像高斯!事实上,它的均值和方差甚至都没有良好定义(两者都是无穷)。找到一个合理高斯近似的关键在于注意到:消息 (6) 的近似版本随后会作为消息 (7) 和 (8) 的修改形式在图中传递,然后会被向下的消息 (9) 相乘,以确定 Jskill 的(近似)后验分布。因此我们的目标将是:让消息 (6)(关于 Jperf)的高斯近似在那些被图中其他部分传来的信息认为更可能的区域上最为精确。然而,正如我们刚刚讨论的,我们需要把近似保持在图中生成该消息的局部区域内。消息 (6) 被发送到节点 Jperf,因此我们可以选择我们的近似,使 Jperf 边缘分布的精度最大化。这通过把消息 (6) 乘以图中同一条边上向下的消息得到,后者可如图 3.22 所示计算。注意,求 Fskill 的后验边缘时也需要这些相同的消息,因此计算它们并不引入额外开销。

图 3.22

图 3.22:计算将用于为消息 (6) 找高斯近似的“上下文”消息。

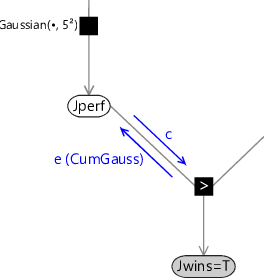
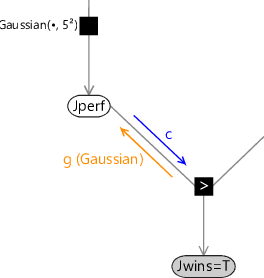
让我们更详细地考虑因子图中靠近 Jperf 节点的部分,如图 3.23 所示。

图 3.23a

(a)

图 3.23b

(b)

图 3.23:Jperf 节点周围因子图的细节,展示所涉及的消息:(a) 运行置信传播时;(b) 对来自 GreaterThan 因子的向上消息做局部高斯近似时。

这里 $e$ 表示此前在图 3.20 中所见的精确消息 (6),$c$ 表示向下的“上下文”消息,$g$ 表示我们所需的对消息 $e$ 的高斯近似。这些消息都只是变量 Jperf 的函数。我们已经看到,我们不能简单地用高斯来近似消息 $e$,因为消息 $e$ 具有无穷的均值和方差。相反,我们对 Jperf 的边缘分布做高斯近似。精确的边缘由入向消息之积 $ce$ 给出。因此我们把近似消息 $g$ 定义为:使消息 $c$ 与 $g$ 之积给出的 Jperf 边缘分布是对真实边缘的最佳高斯近似,从而

$$cg = \text{Proj}\left( ce \right). \tag{3.14}$$

这里 Proj() 表示“投影”,代表用一个具有相同均值和方差的高斯替换一个非高斯分布的过程。这可以看作把精确消息投影到高斯分布族中“最近”的消息上。两边同除以 $c$,我们于是得到

$$g = \frac{\text{Proj}\left( ce \right)}{c}. \tag{3.15}$$

如何做到这一点的数学细节在 Herbrich 等人 [2007] 中讨论。

因此我们如下为精确消息 (6) 找到一个高斯近似。首先我们像之前一样计算精确的输出消息 (6)。它在图 3.24 中以蓝色显示。
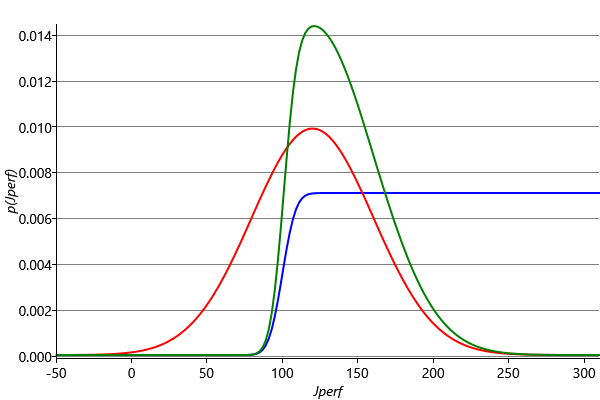
图 3.24

图 3.24:蓝色为精确的输出消息 (6),红色为入向的上下文消息 $c$,绿色为这两条消息之积。

然后我们把它乘以入向的上下文消息 $c$(在图 3.24 中以红色显示)。这给出一个分布(在图 3.24 中以绿色显示),它是非高斯的,但是局部化的,因此具有有限的均值和方差,从而可以用一个高斯来近似。这条曲线在图 3.25 中重复出现,图 3.25 还展示了具有相同均值和方差的高斯分布。
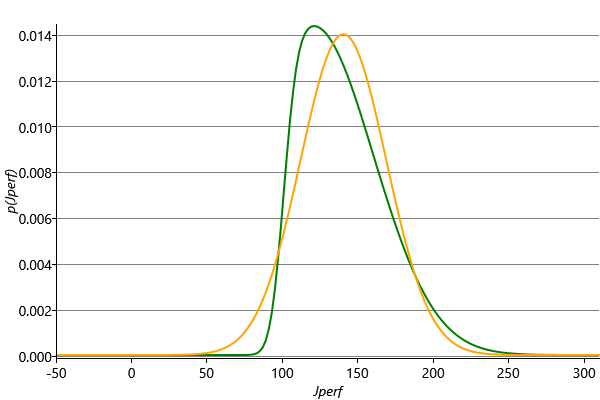
图 3.25

图 3.25:绿色为从图 3.24 复制来的、真实置信传播消息与入向上下文消息之积。橙色为对此积的高斯近似,即 Gaussian(140.4, 28.5²)。

最后,我们把这个高斯分布除以入向的高斯上下文消息 $c$,以生成我们的近似输出消息。因为两个高斯之比本身也是一个高斯 [Bishop, 2006],所得的输出消息也将是高斯的,这正是我们最初的目标。对于我们这个具体例子,这条消息是一个均值为 160.8、标准差为 40.2 的高斯。近似消息的计算过程总结于图 3.26。
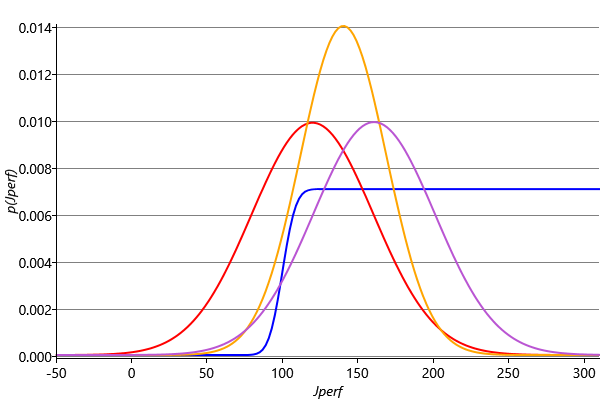
图 3.26

图 3.26:计算消息 (6) 高斯近似所涉及的步骤。蓝色曲线为精确消息 (6),红色曲线为入向上下文消息 $c$,橙色曲线为真实消息与上下文消息之积的高斯近似,即 Gaussian(140.4, 28.5²)。最后,紫色曲线为橙色曲线除以红色上下文消息的结果,给出 Gaussian(160.8, 40.2²)。这个高斯随后被用作消息 (6)。

我们看到,总体上我们先乘以入向上下文消息,然后做高斯近似,最后再把上下文消息除掉。因此入向消息所提供的证据仅用于确定高斯近似应当在哪个区域上精确,而不会被直接并入近似消息本身。如果我们恰好有一个共轭分布,那么投影运算就没有必要,上下文消息也不会产生任何影响。

既然我们已经为输出消息 (6) 找到了合适的高斯近似,我们就可以继续沿图传递消息,给出相应的近似消息 (7),如图 3.27 所示。
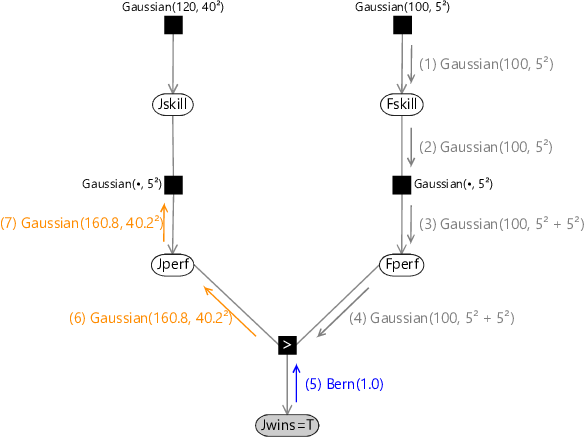
图 3.27

图 3.27:计算 Jskill 更新分布时的消息 (5)、(6) 和 (7)。注意以橙色高亮的消息 (6) 和 (7) 不同于图 3.18 中的精确消息,它们均为 Gaussian(160.8, 40.2²)。

对新的(近似)版本消息 (8) 的计算同样涉及一个高斯与一个高斯的卷积,结果如图 3.28 所示。
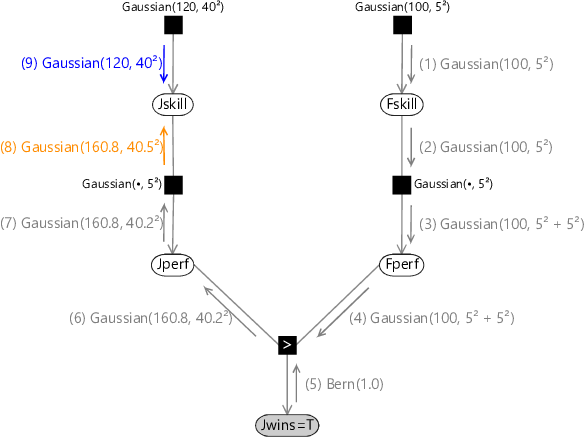
图 3.28

图 3.28:计算 Jskill 更新分布时的消息 (8) 和 (9)。注意除了消息 (6) 和 (7),消息 (8)(橙色,Gaussian(160.8, 40.5²))也不同于图 3.19 中的精确消息。

向下的消息 (9) 保持不变,因此我们最终可以把 Jskill 后验分布的高斯近似计算为两个高斯之积,给出最终结果:一个均值为 140.1、标准差为 28.5 的高斯。

这种在消息传递过程中局部近似消息的方法被称为期望传播(expectation propagation,简称 EP),由 Minka [2001] 提出。近似是在因子节点处局部做出的,而且其方式独立于图其余部分的结构。因此,只要每个因子都一致地用所需的分布类型(此处为高斯)发送和接收消息,该技术就可以应用于任意结构的图。期望传播算法总结于算法 3.1,其中与循环置信传播的差异以红色高亮。

算法 3.1:期望传播

输入:因子图、要计算边缘的目标变量列表、消息传递调度、初始消息值(可选)、每条边的近似分布选择。

输出:目标变量的边缘分布。
  1. 把所有消息初始化为均匀(或初始值,若已提供)。
  2. 对消息传递调度中的每一条边:发送下面适当的消息——
    • 变量节点消息:在其他边上收到的所有消息之积;
    • 因子节点消息:计算置信传播消息(见算法 2.1)。乘以上下文消息(在这条边上朝该因子传来的消息)。用矩匹配把它投影到这条边所需的分布类型。把上下文消息除掉。
    • 观测节点消息:在观测值处的一个点质量;
  3. 直到所有消息收敛。
  4. 在每个目标变量节点处,把所有入向消息之积计算为边缘分布。
……

阅读全文

[译]基于模型的机器学习 - 3.2 推断玩家的技能

到目前为止,我们假设已经知道 Jill 和 Fred 的技能,并用这些技能计算了每个玩家成为胜者的概率。在实践中,我们必须反向推理:我们观察到谁赢得了游戏,并需要用这个信息来了解玩家的技能值。因此,我们转向学习玩家技能这一问题。

下棋

在任何游戏中,看到谁胜谁负都会告诉我们关于玩家技能的信息。

给定一局游戏的结果,提高胜者的技能值、降低败者的技能值似乎是合理的。然而,不太清楚的是我们应当做多大的调整。直觉上我们可以这样推理。假设 Jill 是这局游戏的胜者。如果 Jill 的技能显著高于 Fred,那么 Jill 获胜并不令人意外,因此技能值的变化应当相对较小。如果技能相近,那么较大的变化就有道理。然而,如果 Jill 的技能显著低于 Fred,那么这个游戏结果就非常令人意外。这个结果表明我们当前对技能值的评估不太准确,因此我们应当对技能值做大得多的调整。简而言之,意外的程度指示了应当对技能值做多大的改变。我们将看到,在一个合适的模型中执行推断会自动给出这种行为。

……

阅读全文

[译]基于模型的机器学习 - 3.1 建模游戏的结果

我们的目标是构建一个能够评估在线游戏玩家技能的系统。作为迈向这一目标的第一步,我们需要先考察一个更简单的问题:在已经知道相关玩家技能的情况下,预测一局游戏的结果。这将使我们发展出解决“确定技能”这一更复杂问题所需的许多概念。

假设 Jill 将在 Xbox Live 上与 Fred 玩一局《光环》。在第 2 章中,我们用一个二值变量来表示一个人的软件开发技能,指示此人是否具备某项特定技能。当我们考虑一个人在《光环》这类典型 Xbox 游戏中的技能时,这种做法就不够用了,因为可能的技能水平存在很宽的谱系。相反,用一个连续值来表示一个人的技能更为合适。因此,我们的第一条建模假设是:

……

阅读全文

[译]基于模型的机器学习 - 3 匹配你的对手

每一天,全世界数以百万计的玩家登录 Xbox Live®,在数百款不同的游戏里彼此对战。他们的乐趣取决于是否能被匹配到实力相当的其他玩家,从而获得良好的游戏体验。那么,我们如何用基于模型的机器学习来自动匹配实力相近的玩家呢?

对于游戏而言,在线世界的一大优势在于随时随地都能找到对手,无论白天黑夜。Xbox Live 的一项重要需求,是能够找到技能水平相当的对手,以便让玩家获得愉快的游戏体验。这一需求意味着系统必须有办法估计玩家的技能。然而,要做到这一点会面临一些重大挑战——尤其是,实力更强的玩家并不总能赢得一局游戏。许多游戏都带有运气成分,在某一局中运气可能会偏向较弱的玩家。更普遍地说,一名玩家的表现会因疲劳或热情起伏等因子而在不同对局之间发生变化。因此,我们不能假设某一局的胜者一定比败者技能更高。另一方面,我们确实预期实力更强的玩家在与较弱玩家的对局中,赢的次数会多于输的次数,所以对局结果确实能提供关于玩家相对技能的有用信息。

……

阅读全文

[译]基于模型的机器学习 - 插曲:机器学习生命周期

回到第 1 章处理谋杀之谜时,我们首先从犯罪现场收集证据,然后运用我们自己的知识来构建这起谋杀的概率模型。我们以观测变量的形式,把犯罪现场的证据整合进模型,并执行推断来回答我们关心的查询:每个嫌疑人是凶手的概率是多少?随后我们评估推断的结果是否足够好——也就是说,概率是否高到足以认定谋杀已被侦破?当结果不够好时,我们便收集更多数据、扩展模型、重新运行推断,最终达到了我们的目标概率。

在第 2 章评估求职者技能时,我们从参加真实测试的人那里收集数据并对这些数据进行了可视化。然后我们基于对人们如何做测试的知识建立了一个模型。我们运行了推断,并评估出结果不够好。我们诊断了问题、扩展了模型,然后对原始模型和扩展后的模型都进行了评估,以量化改进程度,并检查改进后的模型是否达到了我们的成功标准。

我们可以从这两个例子出发进行归纳,定义出任何基于模型的机器学习应用所需的步骤:

  1. 收集用于训练和评估模型的数据。
  2. 收集知识,以帮助做出恰当的建模假设。
  3. 可视化数据,以更好地理解它、检查数据问题,并获得对有用建模假设的洞见。
  4. 构建一个模型,使其捕捉关于问题领域的知识,并与你对数据的理解相一致。
  5. 执行推断,利用数据来固定其他变量的取值,从而对我们关心的变量做出预测。
  6. 使用某种评估指标来评估结果,看它们是否满足目标应用的成功标准。

在(通常的)系统第一次未能满足成功标准的情况下,还需要额外的两个步骤:

……

阅读全文

[译]基于模型的机器学习 - 2.6 学习猜测概率

你可能以为,推断猜测概率需要用到与我们目前所用完全不同的技术。事实上,我们的做法将完全相同:我们把想要学习的概率值作为新的连续随机变量加入模型,并用概率推断来计算它们的后验分布。这展示了基于模型方法的威力——每当我们想知道某个东西时,我们就把它作为一个随机变量引入模型,然后用概率推断去求出它。

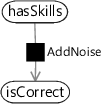
让我们看看如何修改模型,把猜测概率作为随机变量纳入进来。为了保持一致,我们也会为犯错概率(实际上是不犯错概率)添加一个变量,但我们会把它固定在 10% 的犯错几率上。首先,我们要改变书写 AddNoise 因子的方式。

图 2.25a

(a) 内置概率的自定义因子

图 2.25b

(b) 通用的 Table 因子

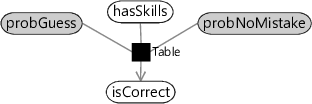
图 2.25:书写 AddNoise 因子的两种方式:(a) 作为一个把猜测和犯错概率“内置”其中的自定义因子。(b) 使用一个通用的 Table 因子,它带有两个参数:给定父节点为 false 时子节点为 true 的概率(左参数),以及给定父节点为 true 时子节点为 true 的概率(右参数)。这种书写因子的方式让我们可以把这些概率作为变量提供给因子。

图 2.25 展示了如何把现有的 AddNoise 因子(其中猜测和不犯错概率被硬编码为 0.2 和 0.9)替换为一个通用的 Table 因子,后者把这些概率作为额外的参数。然后我们可以用两个新的随机变量来设置这些参数,我们把它们命名为 probGuess 和 probNoMistake。推断这些变量的后验分布,就会给出我们所需的猜测和不犯错概率的学习值——但为此,我们首先需要一种能表示这类变量不确定性的分布。

……

阅读全文

[译]基于模型的机器学习 - 2.5 诊断问题

当一个机器学习系统不工作时,通常有三个可能的原因:坏数据、坏模型或坏推断。以下是这三个类别下各自一些常见的问题成因:

  • 坏数据(Bad data):数据项被错误地录入、存储或加载;数据项不完整或标注错误;数据值噪声太大而无用;数据有偏或不能代表系统将被使用的方式;这是任务的错误数据;数据不足以做出准确预测。
  • 坏模型(Bad model):一个或多个建模假设是错的——即与实际生成数据的过程不一致;模型做了太多简化假设;给定可用数据量,模型包含的假设不足以做出准确预测。
  • 坏推断(Bad inference):推断代码含有 bug;消息传递调度不好;推断尚未收敛;存在数值问题(例如舍入、溢出);近似推断算法不够准确。

在我们的情形中,我们可以相当有信心地认为数据是好的,因为我们已经仔细地检查和可视化过它。所以看起来问题很可能出在模型或推断上。我们将从检查推断算法——即循环置信传播——是否正确工作开始。

……

阅读全文

[译]基于模型的机器学习 - 2.4 迁移到真实数据

既然我们已经在示例数据上充分试验过模型,现在就可以用一些真实数据来工作了。我们请了 22 位志愿者完成一份由 48 道题组成的测评测试,用以评估七种不同的开发技能。许多题目需要两项技能,因为它们既需要某个软件开发概念的知识(例如面向对象编程),又需要该题所用编程语言的知识(例如 C#)。

除了完成测试之外,我们还请每位志愿者说明他们认为自己具备哪些开发技能。这些自评技能将作为技能变量的真实标注(ground truth)——也就是说,我们把它们当作变量的真实取值。这类真实标注数据将用于评估我们的系统从志愿者答案中自动推断技能的准确性。真实标注数据应当相当可靠,因为志愿者没有夸大自己技能的动机:结果是匿名的,所报告的技能和答案无法与任何特定志愿者关联。然而,某些志愿者也有可能高估或低估自己的技能,我们在用这些数据评估准确性时需要牢记这一点。

……

阅读全文

[译]基于模型的机器学习 - 2.3 有环性

现在让我们把模型稍微扩展一下,添加第四道需要两项技能的题目。这张新的因子图如图 2.14 所示,我们为这道新题添加了新的 isCorrect4 和 hasSkills4 变量。在这张仅仅略微变大的图上,我们当然也可以用置信传播来做推断吧?其实,我们不能。

飞机航迹环

环可能很棘手。

问题在于,置信传播只有在某个(未观测)节点的所有其它边上都收到了消息之后,才能从该节点发出一条消息(算法 2.1)。在这个约束下,只有当图中没有环时,我们才能把图中的所有消息都发送出去;这里的环是指一条穿过图、从同一个节点出发又回到该节点的路径(且不重复经过同一条边)。如果图中有一个环,那么我们无法沿着环上的任何一条边发送消息,因为这总是要求先计算出环上的另一条消息。

……

阅读全文

[译]基于模型的机器学习 - 2.2 试验模型

构建好一个模型之后,首先要做的就是用一些简单的示例数据来试验它,检查它的行为是否合理。假设有一位候选人懂 C# 但不懂 SQL——我们会预期他答对第一题,而答错另外两题。那么让我们针对这种情况试验一下模型,看看对于这样的答题模式它会推断出哪些技能。为方便起见,我们用 isCorrect 来指代数组 [isCorrect1, isCorrect2, isCorrect3],因此我们要考虑的是 isCorrect 为 [true, false, false] 的情形。

我们想在给定这一组特定的 isCorrect 取值的条件下,推断候选人具备 csharp 和 sql 技能的概率。这是一个推断查询的例子,它由我们想要推断的变量(csharp、sql)以及我们所条件化的变量(isCorrect)连同它们的观测值共同定义。由于这个例子相当小,我们可以用手工方式求出这个推断查询的答案。

手动进行推断

作为开始,我们先来看看在只给定第一题答案的情况下,如何推断 csharp 技能的概率。舍去其它变量后,就得到图 2.6 所示的简化因子图。

……

阅读全文

最近文章

分类

标签

友情链接

其它