评估更多,花费更少:把 Microsoft Foundry 评估器合并成一次调用
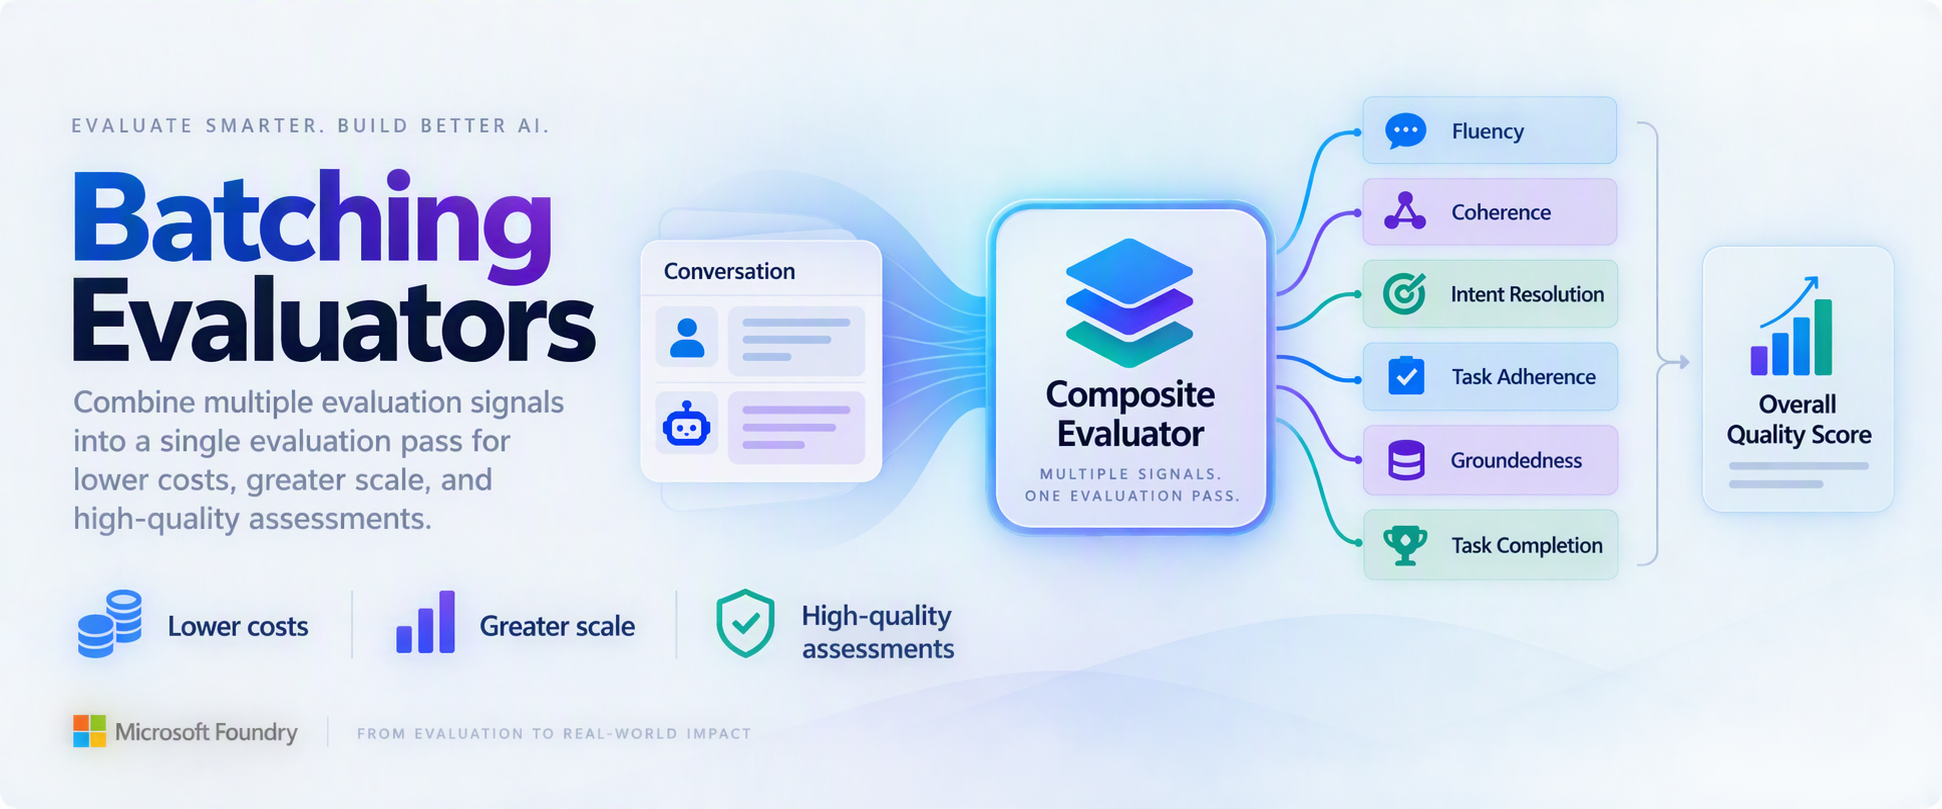
题图来自 Microsoft Foundry 博客的 Evaluate More, Spend Less: Batching Microsoft Foundry Evaluators for Efficient Evaluation,作者是 Salma Elshafey、Ali Mahmoudzadeh、Kayla Ames、Ahmad Qardahji、Vivek Bhadauria、Morteza Ziyadi 和 April Kwong。
给 Agent 做评估时,同一段对话往往要分别发给好几个评估器。这篇文章讲的是微软 Foundry 团队的一项实验:用一次 Judge 调用同时跑五六个 Microsoft Foundry 评估器,总输入 token 少了 61.25% 到 71.07%,实测运行耗时少了 35.74% 到 46.10%,而且在几个价值较高的评估维度上,前沿 Judge 模型的质量没有明显波动。我把它读完后觉得,数字好看是一回事,更有用的是它顺带给出了哪些评估器适合合并、哪些得留着单独跑。
一条 Agent 轨迹可能要评估 groundedness、coherence、指令遵循、任务完成度和工具使用是否正确。传统流水线里,每个评估器都会在一次独立的模型调用中重新拿到同样的消息、工具调用、工具结果和工具定义。轨迹越长,同一份上下文就被重复处理得越多。
于是问题很直接:一次 LLM Judge 调用能不能同时应用五六个评估器,又不丢掉评估本身该有的区分度?实验的设计很简单,把共享上下文只发一次,让一个复合评估器在同一次调用里给多个标准打分。
先看结论。在 100 行的质量样本和工具使用样本上,复合评估需要的模型调用少了 5 到 6 倍,总输入 token 减少 61.25% 到 71.07%,completion token 减少 46.63% 到 63.89%,实测运行耗时减少 35.74% 到 46.10%。在测试过的工作负载里,前沿 Judge 模型在多个关键维度上保持稳定。作者的建议是把复合评估当作成本更低的默认选项,对那些随工作负载变化较大的评分标准,再针对性地保留单独评估。
评估为什么会变贵
评估一段对话很少只看一个维度。常见的做法是同时检查回复是否连贯、是否遵循指令、是否完成用户任务、是否基于现有证据,以及工具用得对不对。每个维度通常对应一个独立的 prompt 和一次模型调用,所以对话轨迹、工具调用、工具输出和工具定义会被反复处理。成本既随评估标准的数量增长,也随共享上下文的长度增长,长 Agent 轨迹因此评估起来特别贵。
复合评估器的做法
复合评估不再逐个维度独立评估,而是让一次 Judge 模型调用给多个标准打分,共享上下文只处理一遍。团队做了两个复合评估器。
Output Quality 评估器
Output Quality 评估器在一次 LLM 调用里给六个 Microsoft Foundry 评估器打分:
| 评估器 | 对应的问题 |
|---|---|
| Fluency | 回复是否清晰、结构完整? |
| Coherence | 是否与对话逻辑一致? |
| Intent Resolution | 助手是否理解了用户的目标? |
| Task Adherence | 是否遵循了用户的指令? |
| Groundedness | 回复中的论断是否有现有证据支撑? |
| Task Completion | 是否完成了被要求的任务? |
Tool Use Quality 评估器
Tool Use Quality 评估器在一次 LLM 调用里给五个 Microsoft Foundry 评估器打分:
| 评估器 | 对应的问题 |
|---|---|
| Tool Call Accuracy | 这次工具调用整体上正确吗? |
| Tool Call Success | 调用本身成功了吗? |
| Tool Input Accuracy | 传入的参数正确吗? |
| Tool Output Utilization | 回复是否正确使用了工具输出? |
| Tool Selection | 选的工具合适吗? |
每个复合 prompt 里,共享的轨迹和工具定义只出现一次,后面依次附上每个评估器完整的定义、评分量表和适用性规则。prompt 还要求 Judge 对每个评估器独立判断,避免一个结论影响另一个。Judge 会为每条标准返回结构化结果,包含分数、理由和适用状态。多轮评估时,它还能指出最早出现失败的那一轮。
他们怎么验证评估质量
这项研究把单独评估器和复合评估器放在下面几个维度上做了对比:
- 两种模式:Single-Turn 和 Multi-Turn。
- 九个 Judge 模型:GPT-4o、GPT-5.4、GPT-5.4 mini、GPT-5.6 Luna、GPT-5.6 Sol、GPT-5.6 Terra、DeepSeek V4 Flash、DeepSeek V4 Pro 和 Grok 4.1 Fast Reasoning。
- 多个数据集,见下表。
| 数据集 | 模式 | 行数 | 主要验证目标 | 参考标签 |
|---|---|---|---|---|
| 内部质量集 | Single-Turn 和 Multi-Turn | 283 | 六个质量评估器 | 已有的逐评估器标签 |
| 内部工具使用集 | Single-Turn 和 Multi-Turn | 200 | 五个工具使用评估器 | 已有的逐评估器标签 |
| BFCL v4 | Multi-Turn | 200 | Task Completion、Tool Call Accuracy 和失败轮次定位 | 确定性的状态与工具调用检查 |
| AgentIF | Multi-Turn | 148 | Task Adherence | 约束级别的多数投票参考 |
| FaithDial | Multi-Turn | 300 | Groundedness | 忠实回复与幻觉回复 |
| FED | Multi-Turn | 125 | Coherence | 五位标注者的人工评分 |
| Tau-Voice | Multi-Turn | 278 | Task Completion | 由 reward 推导的完成标签 |
| AgentRx tau_retail | Multi-Turn | 29 | 失败轮次定位 | 人工标注的失败位置 |
衡量的指标有这几类:
- 输入 token、输出 token、模型调用次数和延迟
- 有标签时的 accuracy、macro-F1 和 Cohen’s kappa
- 单独模式与复合模式之间的一致性和相关结构
- 四次评估运行之间的可重复性
发现一:输入 token 降 61.25% 到 71.07%,延迟降 35.74% 到 46.10%
成本和延迟是在配对的 100 行 Single-Turn 样本上测的,一份给 Output Quality,一份给 Tool Use,对比的是并行跑单独评估器和每行只跑一次复合评估器。每一行的评估器上下文包括 query 和 response、工具调用及结果,以及序列化后的工具定义。
这里的 Single-Turn 指评估器只关注最后一条 Agent 回复,但整段对话历史仍然会作为上下文传进去。
成本样本里的轨迹长度
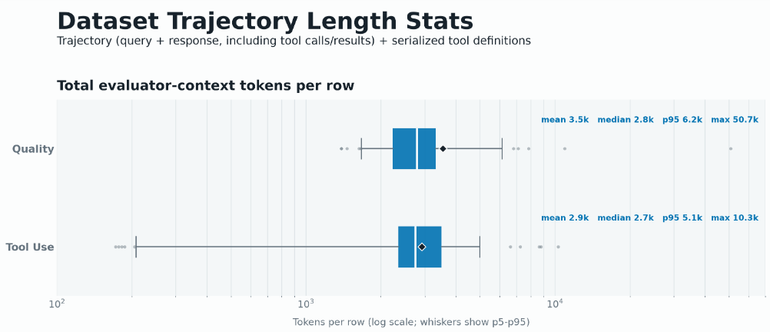
评估器重新格式化之前的轨迹长度分布
对数坐标下的分布显示,大多数行集中在几千个 token 左右,少数轨迹明显更长。两份样本里,评估器上下文越长,省下的 token 绝对数就越多。
实测的成本下降
整份样本的情况如下:
- 重复上下文是省钱的主要来源。Output Quality 的总输入 token 从 2,058,930 降到 797,843,减少 61.25%;Tool Use 从 2,036,122 降到 589,097,减少 71.07%。未命中缓存的输入分别减少了 57.51% 和 53.29%。Output Quality 的复合调用里有 52.72% 的输入 token 命中缓存,单独评估整套是 56.88%;Tool Use 对应的数字是 46.22% 和 66.69%。不过复合评估处理的 token 总量仍然少得多。
- 调用量骤降。Output Quality 从 600 次单独评估器调用降到 100 次复合调用,Tool Use 从 494 次降到 100 次。有 6 个评分标准与行的组合,按评估器自带的适用性规则本来就不该给分,比如这一行根本没有工具调用可评。这几次跳过解释了为什么单独评估的 Tool Use 基线低于 500。
- 实测耗时更短。Output Quality 的 wall time 从 504.41 秒降到 324.12 秒,减少 35.74%;Tool Use 从 536.95 秒降到 289.42 秒,减少 46.10%。折算到每行,Output Quality 是 5.044 秒降到 3.241 秒,Tool Use 是 5.369 秒降到 2.894 秒。Completion token 分别减少 46.63% 和 63.89%。
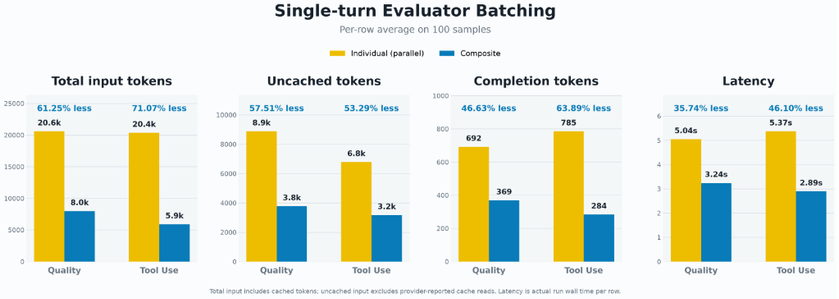
并行单独评估器与复合评估器的 token 和 wall time 对比
质量样本上,复合评估共用了 797,843 个输入 token 和 36,919 个 completion token,并行单独评估是 2,058,930 和 69,180。工具使用样本上,复合评估是 589,097 和 28,358,单独评估是 2,036,122 和 78,522。这些都是实测的运行总量,不是按 prompt 长度估算的。
更大范围的实验结果相近。完整六评估器标准的 Single-Turn 研究少用了约 68% 的输入 token,283 行的 Multi-Turn 质量研究少用了约 77%:六次调用的等价输入是每行 28,715 个渲染后的输入 token,复合调用只要 6,608 个。具体能省多少钱取决于模型和部署的定价,但合并之后,重复的输入和往返开销确实一直被去掉了。
发现二:质量上的取舍取决于评分标准和 Judge 模型
Output Quality 的基准结果
在内部 Single-Turn 质量集上,复合评估的 Task Adherence 准确率在每个 Judge 上都有提升,Task Completion 则和单独评估很接近。外部 Multi-Turn 基准的表现就杂得多,随评分标准、Judge 和工作负载而变。
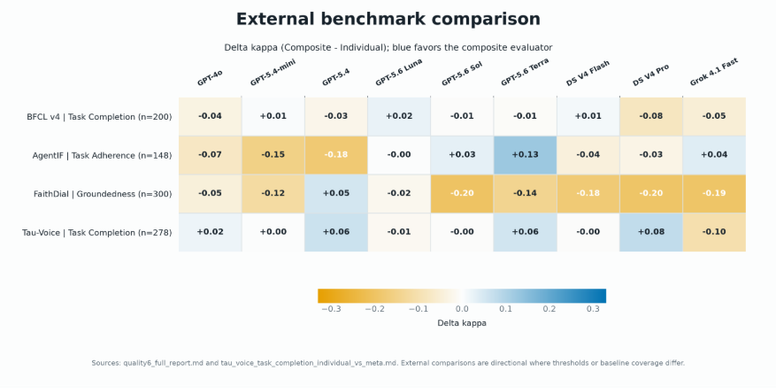
外部基准上 Cohen’s Kappa 的变化量
图里画的是 Δκ = κComposite - κIndividual,蓝色表示复合评估更好,橙色表示单独评估更好。方向有正有负,说明挑好的评分标准和 Judge 之后,还是得用接近生产的数据验证一遍。
BFCL 是带标签的 Multi-Turn 数据里对 Task Completion 最有说服力的一个。用 GPT-5.6 Luna 时,复合评估器的 macro-F1 是 0.848,κ 是 0.696,单独评估器是 0.836 和 0.672。换到别的 Judge,Sol、Terra 和 DeepSeek V4 Flash 上复合与单独的 Task Completion 表现接近,DeepSeek V4 Pro 和 Grok 4.1 Fast 的结果则偏向单独评估。
Tool Use Quality 的基准结果
五评估器的工具复合评估器是在生产风格的工具轨迹上测的。每一行只带一个来源评分标准的 ground truth,所以下表报告的是各评估器可用子集上的准确率。
| Judge | Tool Call Accuracy | Tool Call Success | Tool Input Accuracy | Tool Output Utilization | Tool Selection |
|---|---|---|---|---|---|
| gpt-4o | 0.800 | 0.902 | 0.850 | 0.800 | 0.878 |
| gpt-5.4 | 0.800 | 0.902 | 0.775 | 0.737 | 0.829 |
| gpt-5.4-mini | 0.750 | 0.902 | 0.725 | 0.763 | 0.756 |
| gpt-5.6-luna | 0.914 | 0.902 | 0.848 | 0.775 | 0.901 |
| gpt-5.6-sol | 0.886 | 0.902 | 0.750 | 0.743 | 0.854 |
| gpt-5.6-terra | 0.857 | 0.902 | 0.750 | 0.794 | 0.854 |
| DeepSeek-V4-Flash | 0.775 | 0.902 | 0.800 | 0.848 | 0.854 |
| DeepSeek-V4-Pro | 0.800 | 0.878 | 0.800 | 0.789 | 0.902 |
| grok-4-1-fast-reasoning | 0.946 | 0.902 | 0.925 | 0.745 | 0.823 |
在整个生产风格语料上,复合评估器在五个评分标准上的准确率落在 0.75 到 0.95 之间。各模型有自己的强项:Grok 4.1 Fast 在 Tool Call Accuracy 和 Tool Input Accuracy 上最高,DeepSeek V4 Flash 在 Tool Output Utilization 上最高,DeepSeek V4 Pro 在 Tool Selection 上最高。Tool Call Success 在大多数 Judge 上并列 0.902。Luna 整体仍然排在前面,但没有哪个 Judge 在所有评分标准上都占优。
分类准确率
在真正的多轮 BFCL 基准上,Tool Call Accuracy 是唯一带原生 ground truth 的工具评分标准。GPT-5.6 Terra 在单次运行的榜单上以 0.864 的 macro-F1 领先,GPT-5.6 Sol 是 0.858,GPT-5.6 Luna 是 0.828。其他模型更低:Grok 4.1 Fast 为 0.626,DeepSeek V4 Pro 为 0.625,V4 Flash 为 0.521。这说明只要选对模型,复合评估器在完整对话上判断整体工具调用是否正确,表现不输生产风格的轨迹。
失败定位
同一次 BFCL 运行还测了失败出现在哪一轮。GPT-5.6 Terra 的 member-any 失败轮次定位达到 0.78,也就是在 78% 的失败对话里,Tool Call Accuracy 评分标准预测的那一轮,至少命中了 BFCL 失败轮次集合中的一轮。它在 75 条通过的对话里产生了 22 次误报。GPT-5.6 Sol 的 member-any 是 0.75,GPT-5.6 Luna 是 0.74。Luna 的 Tool Selection 通道可以当作高精度的辅助信号,它在 50% 的失败里找到了失败轮次,误报只有 3 次。
为了确认定位能力不只在机械可检查的 BFCL 轨迹上成立,团队又用了带人工失败标注的 29 行 AgentRx tau_retail 数据集。在 8 个属于工具机制的失败里,Sol 找对了 8 个根因,Terra 和 Luna 找对了 7 个。Grok 4.1 Fast 只找对 2 个,两个 DeepSeek 模型只找对 1 个。样本很小,这个结果只能当作方向性的参考。
合并之后,评分标准之间的关系还在吗
测完直接的准确率,团队又看了批量评估是否保留了各评分结论之间的关系。这是结构上的辅助证据,不是对照 ground truth 得出的准确率。
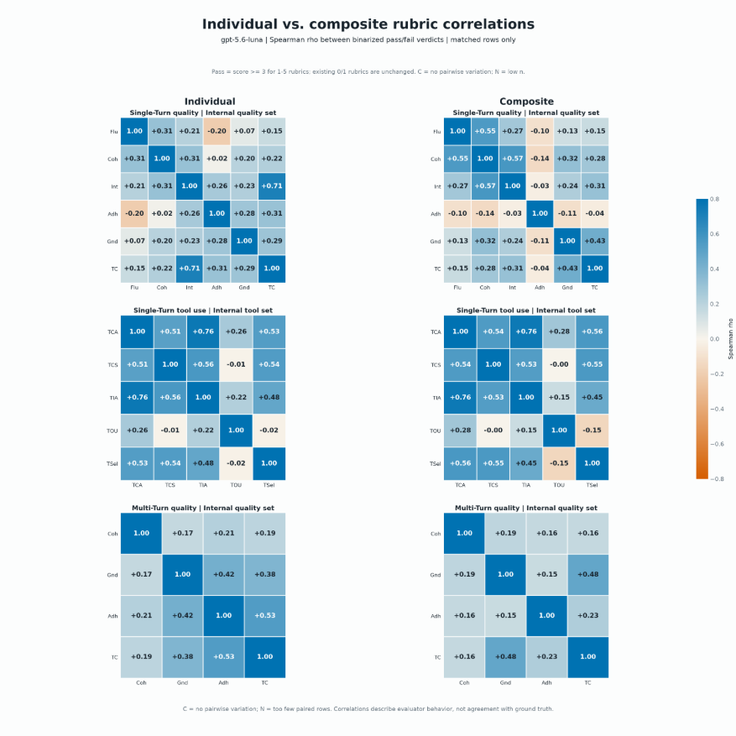
单独评估与复合评估的评分标准相关性热力图对比
热力图比较的是 GPT-5.6 Luna 二值化评分结论的 Spearman 相关系数,取的是两种模式都打过分的行。工具使用的结构特别稳定,Tool Call Accuracy 与 Tool Input Accuracy 的相关性最强,两种模式下都是 0.76。质量方面的关系就比较杂了。例如 Single-Turn 的 Intent Resolution 与 Task Completion 从 0.71 掉到 0.31,Multi-Turn 的 Task Adherence 与 Task Completion 从 0.53 掉到 0.23。批量评估能保住大体的评分结构,但不是每一对关系都保得一样好。
发现三:可靠性同时取决于评分标准和 Judge
Multi-Turn 质量评估的可靠性
团队在同样的 200 行 BFCL 数据上把六评估器复合调用重复跑了四次。九个 Judge 里,DeepSeek V4 Flash 的平均 flip rate 最低,为 3.9%;GPT-5.6 Sol 和 Grok 4.1 Fast 是 5.2%,DeepSeek V4 Pro 是 5.6%,GPT-5.6 Luna 是 6.8%,GPT-4o 是 7.4%,GPT-5.6 Terra 是 7.8%,GPT-5.4 mini 是 10.9%,GPT-5.4 是 15.6%。
比排行榜更值得看的是按评分标准拆开的结果:
- Fluency:平均 flip rate 为 0.0%
- Coherence:2.4%
- Intent Resolution:8.6%
- Task Adherence:6.7%
- Task Completion:11.5%
- Groundedness:16.4%
同一个 Judge 可能在某条标准上非常稳,在另一条上却很飘。可靠性应该按标准逐条监控,没法从一个汇总分数里推出来。
Multi-Turn 工具使用的可靠性
五评估器的多轮工具研究也得出了同样的结论,需要逐条标准监控。在四次 BFCL 重复运行中,GPT-5.6 Terra 和 DeepSeek V4 Flash 的平均 flip rate 最低,为 6.0%,GPT-5.6 Sol 是 6.1%,GPT-5.6 Luna 和 GPT-4o 是 7.0%。GPT-5.6 Sol 取得了最强的四次取众数 Tool Call Accuracy kappa,为 0.759,而 Terra 在单次运行的质量与定位结果里领先。Tool Call Success 是最稳定的标准,各 Judge 的平均 flip rate 只有 4.7%。
实践建议
综合质量、工具使用、失败定位和可靠性几组研究,作者给出了选 Judge 和选择批量评估器的实用建议。
推荐的 Judge:GPT-5.6 系列
在质量、工具使用、失败定位和可靠性这些实验里,GPT-5.6 系列的整体结果一直最强。个别基准偶尔会偏向别的模型或某个特定的 GPT-5.6 变体,但 Luna、Sol 和 Terra 反复排在前列,在各类工作负载上的表现也最均衡。Sol 在多次重复的质量与工具使用研究里通常最可靠,Terra 在若干 BFCL 工具使用和失败轮次定位评估中领先,Luna 在所有测试负载上的平均质量最高。如果你的工作负载和实验里的相近,作者建议先从 GPT-5.6 Judge 开始,再按自己的侧重在 Sol、Terra 和 Luna 里选。部署成本更低的时候,Luna 是很有吸引力的选项,它保持了前沿水准的评估质量,同时在实验里平均表现最强。相比之下,成本更低的模型往往要在质量、可靠性和基准表现上做更大的取舍。具体省多少钱取决于模型定价和部署配置,所以在只看成本做优化之前,先在接近生产的负载上给候选 Judge 做个基准测试。
适合合并的评估器
下面这些评估器放进复合评估器后,表现和单独跑时一样好,可以直接合并:
- Fluency 和 Coherence:在九个 Judge 和多次重复中都非常稳定
- Tool Call Success 和 Tool Selection:在测试过的各个 Judge 模型上都很稳健
- Task Completion:在各基准上与单独评估接近,GPT-5.6 Luna 在 BFCL 上略强
- Tool Call Accuracy、Tool Input Accuracy 和 Tool Output Utilization:在生产风格的轨迹上表现很好,准确率随评估器和 Judge 在 0.75 到 0.95 之间
需要留意的评估器
下面这些评估器的结果会随工作负载或 Judge 而变。它们仍然可以合并,但建议在自己的数据上核对:
- Task Adherence:普通对话上表现不错,但一条请求里包含很多彼此独立的约束时就吃力
- Intent Resolution:虽然有些数据集上一致性很高,但整体上各数据集的结果不太一样
- Groundedness:这是测试里最不稳定的评估器,重复运行时分数的变化比其他任何维度都多,不过在 GPT-5.6 Luna 和 GPT-5.4 这类前沿模型上表现更好。如果你的场景对 grounding 的准确性要求很高,可以把单独的评估器留作后备
这种做法适合用在哪
复合评估最适合当作有选择的默认方案,不适合无差别地取代所有独立评估器。GPT-5.6 Sol 的整体平衡性最好,Terra 在单次运行的 BFCL 工具结果里领先,Luna 是推荐的较便宜的高质量选项。不管选哪个,Judge 和评分标准都应该在接近生产的数据上验证。
Multi-Turn 对比有一个结构上的边界:Multi-Turn 的 Fluency 和 Intent Resolution 并没有原生的单独评估器。复合评估器可以产出这两个维度,但在这种设置下,没办法做单独评估与复合评估的直接验证。
最后一点,token 节省换算成钱,没有一个固定的百分比。价格随模型和部署而不同,输出长度和重试行为也随工作负载而不同。
小结
复合评估器能把评估流水线里重复的上下文去掉。在更新后的 100 行对比里,六个质量评估器的总输入 token 减少了 61.25%,五个工具使用评估器减少了 71.07%,completion token 减少 46.63% 到 63.89%,实测运行耗时分别减少 35.74% 和 46.10%,很多维度上的质量仍然相当。
最稳妥的做法是有选择地用,别全盘切换:先选一个 GPT-5.6 系列的模型,把稳定的评估器合并起来并分别监控,对不稳定的评估器保留专门的后备。
我自己的看法是,这篇文章最有价值的不是那几个百分比,而是它把每条评分标准的稳定性单独拆开给你看。Fluency 的 flip rate 是 0.0%,Groundedness 是 16.4%,同样是合并,风险完全不是一个量级。
上手试试
可以先用复合评估器跑一小批已知好和已知坏的 Agent 对话。想评估六条质量标准就选 Output Quality,想评估五条工具使用标准就选 Tool Use Quality。逐条看分数和适用状态,再针对你最在意的失败模式,和单独评估器的结果抽查对比。
作者推荐从 GPT-5.6 系列开始选 Judge 模型。换了 Judge 模型,或者对话所属的领域变了,记得重新核对结果。
现在就可以在 Microsoft Foundry 门户里试这些评估器,使用方法见文档 Agent Evaluators for Generative AI - Microsoft Foundry | Microsoft Learn。
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-10-05-evaluate-more-spend-less-batching-microsoft-foundry-evaluators/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。