[译]基于模型的机器学习 - 7.1 众包工作者模型
在海地地震期间发送的消息,是按照表 7.1 所示的九个主要类别来标注的。每个类别又被进一步细分为若干子类别——例如,“基础设施损毁"下设有"建筑物倒塌"“结构不稳"“道路封堵"“桥梁受损"和"通信线路中断"等子类别。其结果是,可以为任何一条给定消息赋予的子类别标签多达 50 个,不过消息也可以只用一个主类别来标注。
……一个技术老兵工作的点滴记录,专注、沟通、乐在分享!
在海地地震期间发送的消息,是按照表 7.1 所示的九个主要类别来标注的。每个类别又被进一步细分为若干子类别——例如,“基础设施损毁"下设有"建筑物倒塌"“结构不稳"“道路封堵"“桥梁受损"和"通信线路中断"等子类别。其结果是,可以为任何一条给定消息赋予的子类别标签多达 50 个,不过消息也可以只用一个主类别来标注。
……本文根据 Naveen Gopalakrishna 发表于 Microsoft Foundry Blog 的工程指南整理,原文发布日期为 2026 年 11 月 3 日。
企业接入 Claude Code 时,还要管理登录身份、可用模型、预算和私有网络。Naveen 开发的 Claude Code on Foundry(CCOF)处理的就是这些问题。据原作者介绍,这套架构已在多家企业上线;代码公开在 CCOF 仓库,但它不是微软产品。
接入时,先部署环境、验证一名用户,再考虑扩大范围。文中配图来自作者记录的实验室运行,名称和标识符已替换或遮蔽,并非客户生产环境。已有企业部署经验不能代替具体工作负载的容量验证。
……2010 年,一场 7.0 级地震袭击了海地,造成大量人员伤亡和大范围破坏。随后展开的人道主义援助工作因通信系统、交通设施和电力网络的损毁而受阻。来自受灾地区人们发出的消息,成为救援人员至关重要的信息来源。但这些消息需要经过分诊和归类——而承担这项工作的志愿者,其能力、偏见和细心程度各不相同。在未来的危机中,基于模型的机器学习能否利用这些相互矛盾且充满噪声的信息,来推断出地面上的真实状况呢?
……VS Code 最近把 Agent 的执行安全问题摆到了更显眼的位置:Copilot Agent 不再只是生成文本,它还可能执行终端命令、启动语言服务器、调用 MCP Server,并访问网络。于是,很多人第一次遇到 Permission denied、命令无法启动、依赖下载失败,或者看到“Allow Outside Sandbox”时,往往不知道这是权限问题、沙箱策略问题,还是运行环境缺少依赖。
既然我们的建模工具箱里有了门,我们就可以扩展过敏模型,让不同的孩子能够拥有不同的过敏获得与丢失模式。你也许还记得,在第 6.2 节中,我们想要做的模型改动是编码这个修改后的假设:
这个假设要求每个孩子都属于某个致敏类别,但我们并不知道每个孩子属于哪个类别。我们可以用一个针对每个孩子的 sensClass 随机变量来表示这种未知的类别归属,它取值为 $0, 1, 2, \dots$,取决于孩子在类别 0、类别 1,等等。因为这个变量可以取多于两个的值,我们不能用 Bernoulli 分布来表示它的不确定取值。相反,我们需要一个离散分布(discrete distribution),它是 Bernoulli 分布向“取多于两个值的变量”的推广。
门允许因子图的一部分被打开或关闭。
在上一节中,我们看到了如何通过手工推断一个“在多个可选过程之间做选择”的随机变量上的后验分布,来比较这些可选过程。现在我们将看到如何通过定义一个合适的模型、并在该模型内执行推断来完成同样的计算。为此,我们需要一种新的建模结构,它允许在模型中表示各种可选项。我们可以用来做这件事的建模结构称为门(gate),如 Minka and Winn [2009] 所述。
门把因子图的一部分包围起来,并根据一个称为选择变量(selector variable)的随机变量的状态来打开或关闭这部分。当选择变量取某个特定值(称为键,key)时,门是打开的;对所有其他取值,门是关闭的。图 6.11 的因子图中展示了一个门的例子。门以一个虚线矩形表示,键值(true)位于左上角。选择变量 selector 有一条边连接到门——边上的箭头表明门被视为选择变量的子节点。当 selector 等于 true 时,门是打开的,于是 x 服从 Bernoulli(0.2) 分布。否则门是关闭的,x 服从均匀分布,因为此时它没有连接到任何因子。
在前面所有章节中,我们都假设数据源自单一的潜在过程。但现在我们不能再这样假定了,因为我们预期:会发展出过敏和哮喘的孩子与不会发展出的孩子,遵循的是不同的过程。为了处理这类可选过程,我们需要引入一种新的建模技术。
这种技术将使我们能够:
为了介绍这项新技术,我们暂时把哮喘项目放在一边,转而看一个双过程情形的简单例子(如果你更愿意继续聚焦于哮喘项目,可以直接跳到第 6.5 节)。既然我们身处医学领域,有一个绝佳的双过程情形可用:随机对照试验。随机对照试验是一种临床试验,常用于检验各类医疗干预(如新药)的有效性。在这类试验中,每个受试者被随机分配到治疗组(接受实验性干预)或对照组(不接受干预)。试验的目的是判断实验性干预是否对一个或多个关注的结局有影响,并理解这种影响的性质。
……现在我们有了一个完整的模型,可以在一些研究数据上试验它了。正如本书前面多次强调的,在使用真实数据集时,务必仔细查看数据集,确保它是完整、正确且符合你预期的形式。请记住,许多常见的机器学习问题都是由数据问题引起的(例如第 2.5 节中列举的那些)。检查数据集的一个好办法是构建可视化,让你一眼就能看清它的样子。在本例中,我们需要为每个孩子、每种过敏原和每个时间点创建检测结果的可视化。然而,这个研究数据集包含私密的医疗数据,因此我们无法在本书中公开分享这些数据,哪怕是以可视化的形式。从这次可视化中我们学到的最重要一点是:数据集中有大量检测结果缺失。
当存在缺失数据时,总是值得分析一下它们为什么缺失。在图 6.6 中,我们绘制了数据集中每个年龄、每种检测类型的检测结果数量(无论阳性还是阴性)。
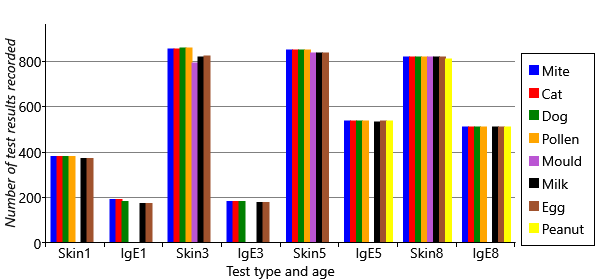
图 6.6:为两类检测各自记录的检测结果,按孩子的年龄拆分。
你可以在图 6.6 中看到几种不同的缺失数据模式。首先,图中显示某些年龄和检测类型对特定过敏原完全没有数据。例如,花生在 1 岁和 3 岁完全没有结果,5 岁时只有 IgE 结果。霉菌完全没有 IgE 结果,1 岁时也没有皮肤试验结果。其次,越早的年龄缺失数据越多,尤其是 1 岁。第三,图中显示 IgE 检测总体上比皮肤试验缺失得多。我们需要把所有这些缺失数据点的影响考虑进来。
……原文:Voice agents in Foundry Agent Service: architecture, trust boundaries, and real-audio latency
以前做企业语音智能体,得自己把语音服务、实时模型、轮次检测和工具编排拼在一起,每个环节出问题也都得自己兜底。Foundry Agent Service 里的语音智能体(voice agents)把这一整套多服务方案收拢成一个带版本的托管智能体,运行时的工程量少了很多,但身份、授权、数据、网络、留存和运维这些事仍然得企业自己扛。
……本文整理自 Microsoft Foundry 博客的 Evaluating Voice Agents: How Reliable Are Foundry’s Multi-turn Evaluators?,作者是 Sheng Liu、Shivank Goel 和 Morteza Ziyadi。
做语音 Agent 的团队迟早会撞上一个现实:每天几千通电话,Agent 还隔三差五更新,光靠人工听录音根本跟不上,只能上自动评估。Microsoft Foundry 给的办法是多轮评估器,它会看完整段对话,评估 Agent 的行为和结果。
……