[译]基于模型的机器学习 - 5.4 我们的首次推荐
竖起或放下大拇指

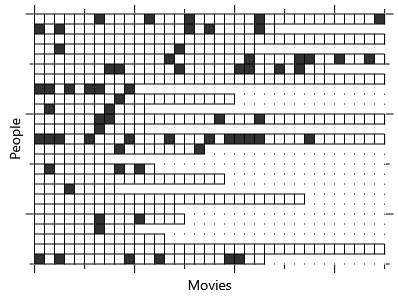
有了我们训练好的两特质模型,我们现在准备好做一些推荐了!在训练期间,我们学到了每部电影和每个人在特质空间中(不确定的)位置。我们现在可以为验证集中每一条被留出的评分做预测。我们一次做一条评分——也就是说,一次针对一个人和一部电影。首先,我们把电影 trait 和人的 preference 的先验设为训练期间学到的后验。然后我们运行期望传播来推断 likesMovie 上的后验分布,以计算这个人会喜欢这部电影的概率。在验证集中所有评分上重复这一过程,就得到了每个人喜欢每部电影的概率,如图 5.15a 所示。图 5.15b 显示了对应的真实标签喜欢/不喜欢的值。
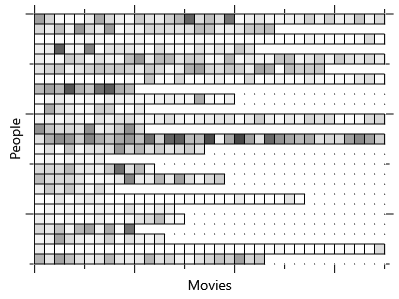
图 5.15a 推断的喜欢概率

(a) 推断的喜欢概率

图 5.15b 真实标签喜欢/不喜欢

(b) 真实标签喜欢/不喜欢

图 5.15:我们推荐模型的初步结果。(a) 计算得到的每个人喜欢每部电影的概率。白色方块对应概率 1.0,黑色对应概率 0.0,灰色的深浅表示介于两者之间的概率值。(b) 真实标签——白色表示这个人喜欢这部电影,黑色表示他不喜欢。

从图 5.15b 中最先引人注意的一点是,人们大多喜欢电影,而不是不喜欢它们。因此从某种意义上说,我们给推荐系统设定的任务,是试图找出一个人不喜欢的少数几部电影。看图 5.15a 中预测的概率,我们可以在这个任务上看到一些成功——因为某些较暗的方块确实与真实标签中的黑色方块正确对齐了。此外,某些行总体上比平均更暗或更亮,表明我们能够学到每个人总体上有多可能喜欢或不喜欢电影。然而,这些预测并不完美——有许多不喜欢的电影被漏掉了,也有一些不喜欢的预测是错误的。但在我们对模型做任何改进之前,我们需要先决定用哪些评估指标来度量和追踪这些改进。

……
阅读全文

[译]基于模型的机器学习 - 5.3 训练我们的推荐系统

在能够训练我们的模型之前,我们需要一些数据来训练它。好消息是,有一些高质量的公开数据集可以用来训练推荐模型。我们将使用明尼苏达大学 GroupLens Research 提供的、极为出色的 MovieLens 数据集之一 [Harper and Konstan, 2015]。我们将使用一个已经免费提供、供教育和开发用途的数据集——谢谢你,MovieLens!你可以自己使用这个链接下载该数据集。

认识我们的数据

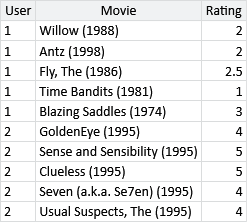
与任何新数据集一样,我们的首要任务是认识数据。首先,这里是数据集中 10 条评分的样本:

表 5.3

表 5.3:来自 MovieLens 数据集的评分样本。

……

阅读全文

评估智能体 AI:Microsoft Foundry 如何超越“最终答案质量”

原文:Evaluating Agentic AI in Microsoft Foundry: Beyond Final-Answer Quality,作者 jothsnapraveena,发布于 2026-09-10

AI 系统正在从单轮对话助手演变成会调用工具的智能体,评估方式也必须跟着变。这是我最近研究 Microsoft Foundry 智能体评估功能时最直接的感受。

做传统 LLM 应用的团队,通常只关心最终回复是否相关、连贯、有依据。但智能体不一样,这只是问题的一部分。

……

阅读全文

[译]基于模型的机器学习 - 5.2 多重特质与多人

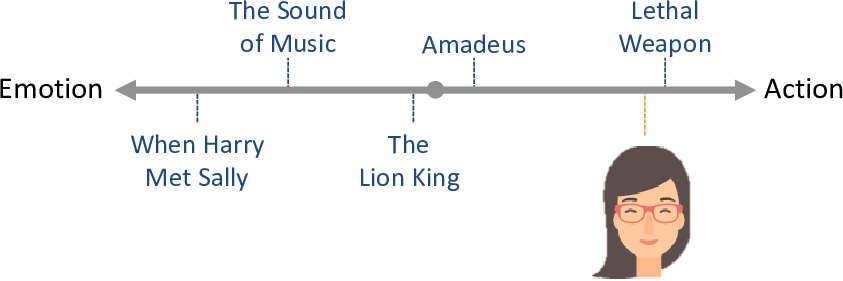
我们那个只有一个特质的模型,并不能很好地刻画电影。为了看清这一点,让我们再看一眼图 5.4:

图 5.4

只用动作/情感这一个特质,我们几乎无法区分《狮子王》和《莫扎特传》,因为它们在这条特质线上的位置非常接近。因此,对于这幅图中的这位女士,我们没办法在不同时推荐像《狮子王》这样的电影(她不喜欢)的情况下,去推荐像《莫扎特传》这样的电影(她喜欢)。

我们可以通过使用额外的特质来解决这个问题。如果我们加入第二个特质,表示影片有多逃避现实或多写实,那么每部电影现在除了在原来的特质线上有一个位置外,在这条第二特质线上也会有一个位置。这个第二特质值让我们能够区分这两部电影。为了看清这一点,我们可以把电影展示在一张二维图上,其中逃避现实/写实的特质位置位于纵轴上,如图 5.8 所示。

……

阅读全文

智能体的自动化,为什么还没有想象中那么高效

自动化操作界面这件事,其实做了很多年,比现在这一波智能体热潮早得多。做过爬虫的人都知道,早年靠的是人工写脚本,解析网页结构,模拟鼠标点击,往文本框里塞字符,效率全看脚本写得细不细。这两年多了视觉能力,智能体可以直接看着屏幕做判断,写脚本这一步确实省了不少。但要说这是自动化能力质的突破,我觉得有点急。

……

阅读全文

[译]基于模型的机器学习 - 5.1 学习用户和电影

本章的目标是向特定的人做出个性化的电影推荐。思考这个问题的一种方式,是想象一张表格,其中行是电影、列是人。表格的单元格显示这个人喜欢还是不喜欢这部电影——例如,如表 5.1 所示。这张表格是一个例子,展示了我们用来训练推荐系统时可能拥有的那类数据:我们询问了若干人,让他们说出自己是喜欢还是不喜欢某些特定的电影。

……

阅读全文

人机协同里,卡住我们的常常不是机器,是人

在之前的文章里我提过,现在的大模型已经足够聪明,却始终解决不了一件事:怎么跟使用者的价值观对齐。这段时间我又留意到一个更具体的现象,我们一边拼命教大模型像人一样思考、像人一样做事,一边又受不了它真的需要跟人商量。

这个要求本身没问题。让大模型学会像人一样处理事情,是脑力劳动能被替代、人的负担能被减轻的前提,方向没有错。但只要往前多走一步就会发现,大模型给出的任何规划都绕不开跟人协同这件事。总有一些关键的判断和决策,只能由人来拿主意,它自己走不出电脑那一步,那一步还得人去补。可我们一边希望它像机器一样不吃不睡、连轴转,一边又见不得它真的需要人插手:它做的事总有需要收尾、需要人兜底的地方,让人没法完全放心;等它真按要求把决策权交回来,跟人配合,我们又嫌它一点人味都没有,理解不了它为什么非要这样。这个矛盾挺有意思,我们既想要一个像人一样思考的工具,又不想承担一个像人一样需要沟通的伙伴该有的成本。

……

阅读全文

大模型会推理了,但还学不会企业的价值观

过去一年多,大模型的变化越来越明显。它们不再只是等待提问、生成答案的语言工具,越来越像 agent 的执行引擎。以前我们要让一个模型真正做事,往往需要在外围搭很多东西:上下文管理、检索、工具调用、流程编排,每一步都要由开发者事先安排好。现在,不少模型已经能够自己理解目标,判断是否需要调用工具,再根据工具返回的结果继续往下做。

……

阅读全文

[译]基于模型的机器学习 - 5 做出推荐

无论你钟情于音乐、书籍、电影还是电子游戏,一条好的推荐都能带来实实在在的乐趣——还能帮助那些名气不大的作品走入聚光灯下。但一个人眼中的新经典,另一个人可能会一口断定为烂作。能否用一个模型来理解一个人的喜好与厌恶,理解得足够透彻,从而提供量身定制的推荐呢?

各行各业的零售商都渴望向他们的顾客做出准确、个性化的推荐。然而,开发一套自动推荐系统所需的专业能力和投入,超出了许多零售商——尤其是较小的零售商——的承受范围。作为替代方案,这类零售商可以转向云端,利用在线推荐服务。

……

阅读全文

Microsoft Foundry 与 Azure OpenAI 模型迁移全流程

本文整理自 Microsoft Community Hub 的文章 Model Migration Process on Microsoft Foundry and Azure OpenAI,原作者 Meera Kurup(Microsoft)。我把里面这套模型迁移流程读了几遍,觉得挺实用,就整理成中文分享给大家,案例和数据都保留了原文的说法。

只要你的应用是跑在某个大模型上的,迟早会碰到换模型这件事。可能是你在用的模型被官方标了退役日期,也可能单纯是有更好、更快或更便宜的新模型出来了。把代码里的模型名从 gpt-4o 换成 gpt-5.1,理论上一行代码就能搞定。但这一行代码背后藏着的工作量,经常被严重低估。

……

阅读全文

最近文章

分类

标签

友情链接

其它