Microsoft Foundry 中的文章

Foundry Agent Service 中的语音智能体:架构、信任边界与真实音频延迟

原文:Voice agents in Foundry Agent Service: architecture, trust boundaries, and real-audio latency

以前做企业语音智能体,得自己把语音服务、实时模型、轮次检测和工具编排拼在一起,每个环节出问题也都得自己兜底。Foundry Agent Service 里的语音智能体(voice agents)把这一整套多服务方案收拢成一个带版本的托管智能体,运行时的工程量少了很多,但身份、授权、数据、网络、留存和运维这些事仍然得企业自己扛。

……
阅读全文

语音 Agent 评估:Foundry 多轮评估器到底有多可靠?

本文整理自 Microsoft Foundry 博客的 Evaluating Voice Agents: How Reliable Are Foundry’s Multi-turn Evaluators?,作者是 Sheng Liu、Shivank Goel 和 Morteza Ziyadi。

做语音 Agent 的团队迟早会撞上一个现实:每天几千通电话,Agent 还隔三差五更新,光靠人工听录音根本跟不上,只能上自动评估。Microsoft Foundry 给的办法是多轮评估器,它会看完整段对话,评估 Agent 的行为和结果。

……

阅读全文

补上 AI Agent 的治理缺口:用 Microsoft Foundry 和 Azure 服务建立可见性与护栏

本文整理自 Microsoft Foundry 博客的 Closing the AI Agent Governance Gap with Microsoft Foundry,作者是 Alexandra Miller-Browne。

开发者上线 Agent 的速度,已经快过安全团队给它们登记造册的速度。组织从试点走向同时运行几十个甚至上百个 Agent 之后,总会反复冒出同一个问题:我到底怎么才能看清整个环境里有哪些 AI Agent?

这篇文章讲的是如何借助 Azure 的现有服务,为 AI 资产建立可见性、护栏和成本归属。读完我最大的感受是,它并没有让你另起炉灶,而是把大多数组织手上已经有的身份、网络和合规控制,接到 Agent 这套新东西上。

……

阅读全文

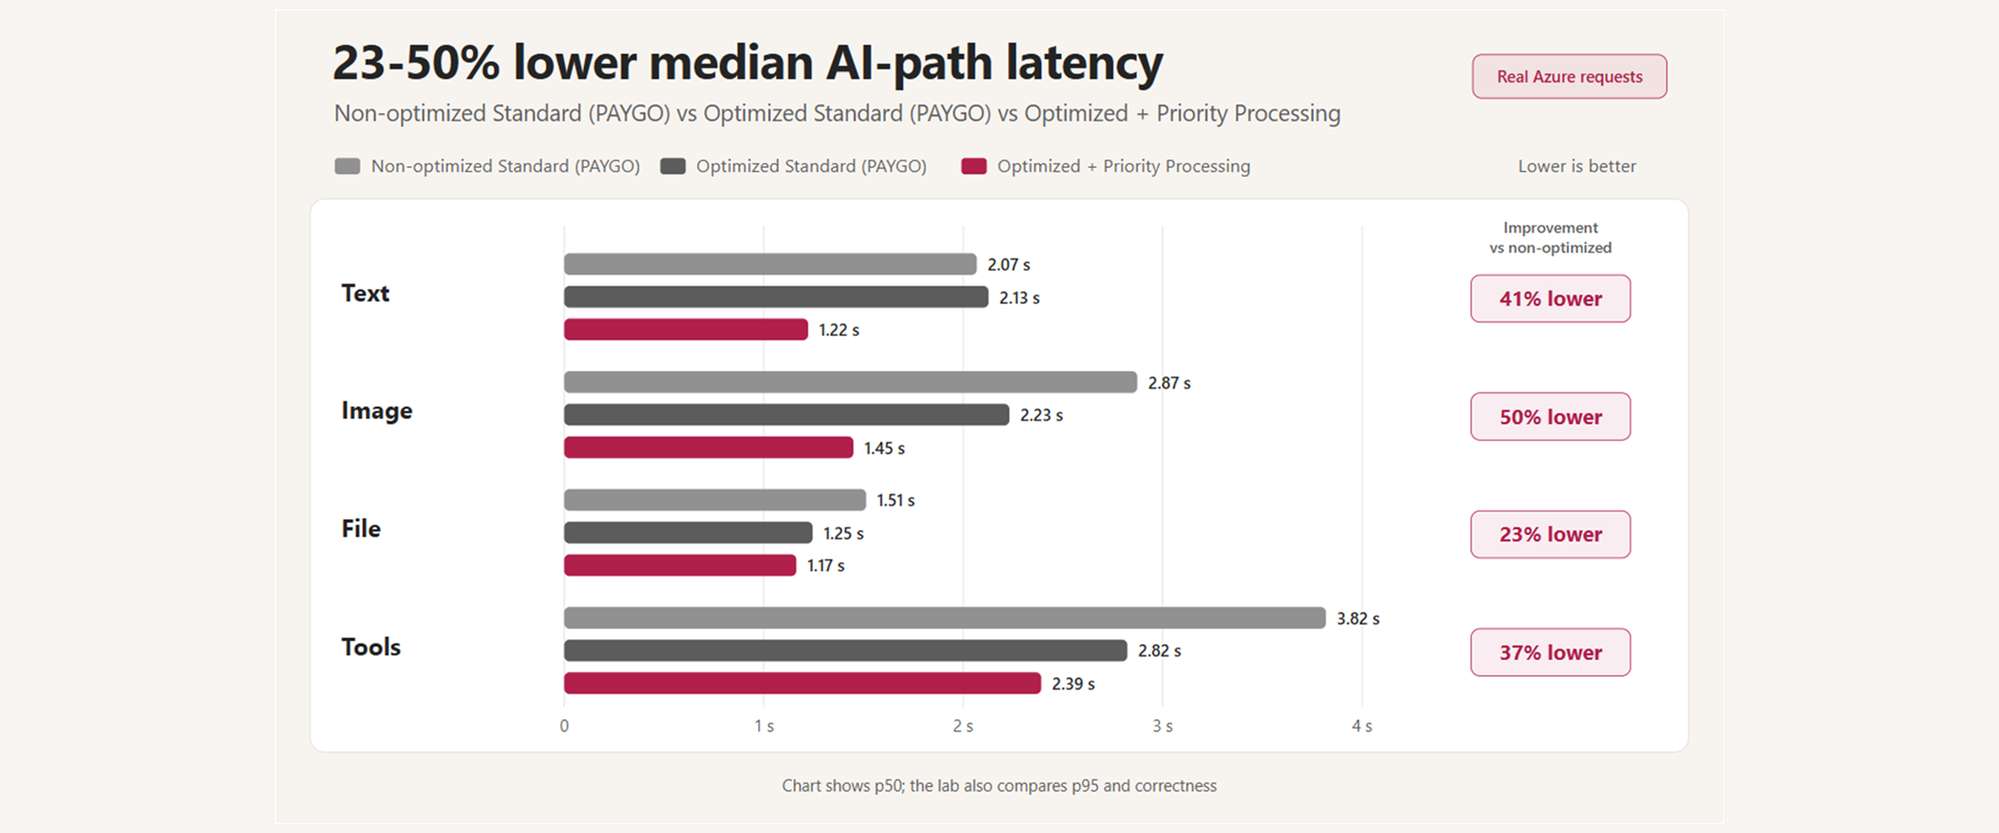
如何让 Microsoft Foundry 上的 AI 响应更快:来自 2,040 次测量的经验

How to make AI responses faster on Microsoft Foundry

题图来自 Microsoft Foundry 博客的 How to make AI responses faster on Microsoft Foundry: lessons from 2,040 measurements,作者是 Yassine El Ghali。

模型换得更快,应用不一定就更快。这篇文章的作者在 Microsoft Foundry 上把文本、图片、文件、工具和 MCP 几类工作负载都测了一遍,想知道哪些改动真能降低延迟,又不牺牲正确性。我读下来最大的感受是,延迟的来源比我平时想的杂得多:输出长度、重复的 prompt 内容、图片和文档处理、工具选择、连接建立、串行等待,还有多出来的模型请求,都会占时间。

……

阅读全文

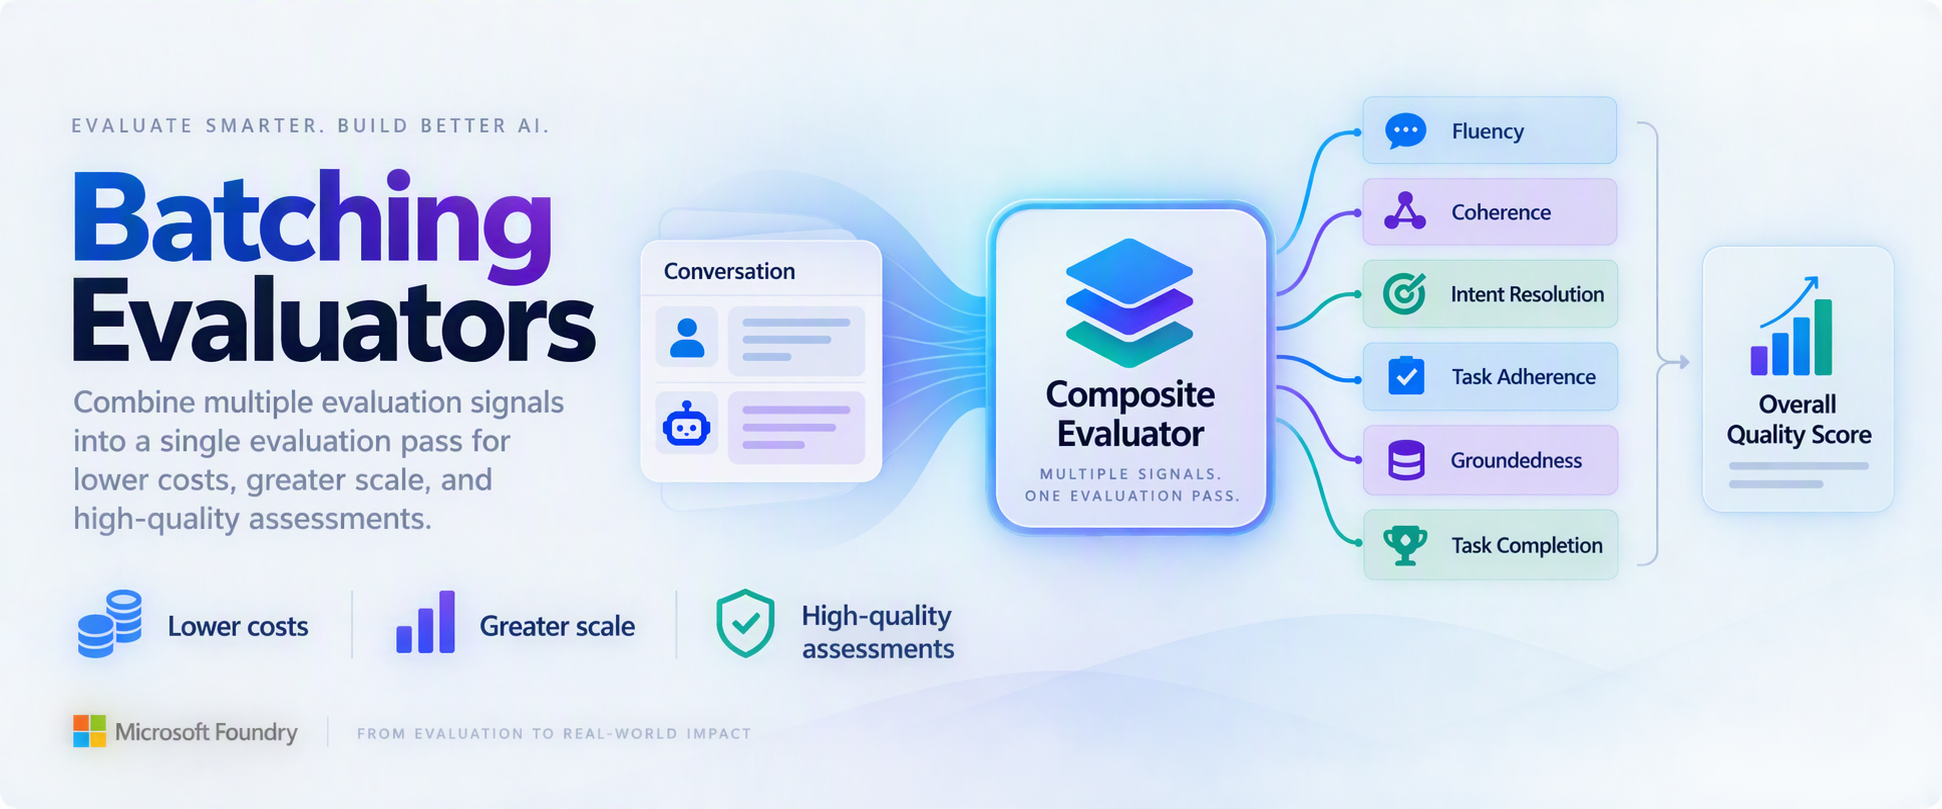
评估更多,花费更少:把 Microsoft Foundry 评估器合并成一次调用

Evaluate More, Spend Less: Batching Microsoft Foundry Evaluators

题图来自 Microsoft Foundry 博客的 Evaluate More, Spend Less: Batching Microsoft Foundry Evaluators for Efficient Evaluation,作者是 Salma Elshafey、Ali Mahmoudzadeh、Kayla Ames、Ahmad Qardahji、Vivek Bhadauria、Morteza Ziyadi 和 April Kwong。

给 Agent 做评估时,同一段对话往往要分别发给好几个评估器。这篇文章讲的是微软 Foundry 团队的一项实验:用一次 Judge 调用同时跑五六个 Microsoft Foundry 评估器,总输入 token 少了 61.25% 到 71.07%,实测运行耗时少了 35.74% 到 46.10%,而且在几个价值较高的评估维度上,前沿 Judge 模型的质量没有明显波动。我把它读完后觉得,数字好看是一回事,更有用的是它顺带给出了哪些评估器适合合并、哪些得留着单独跑。

……

阅读全文

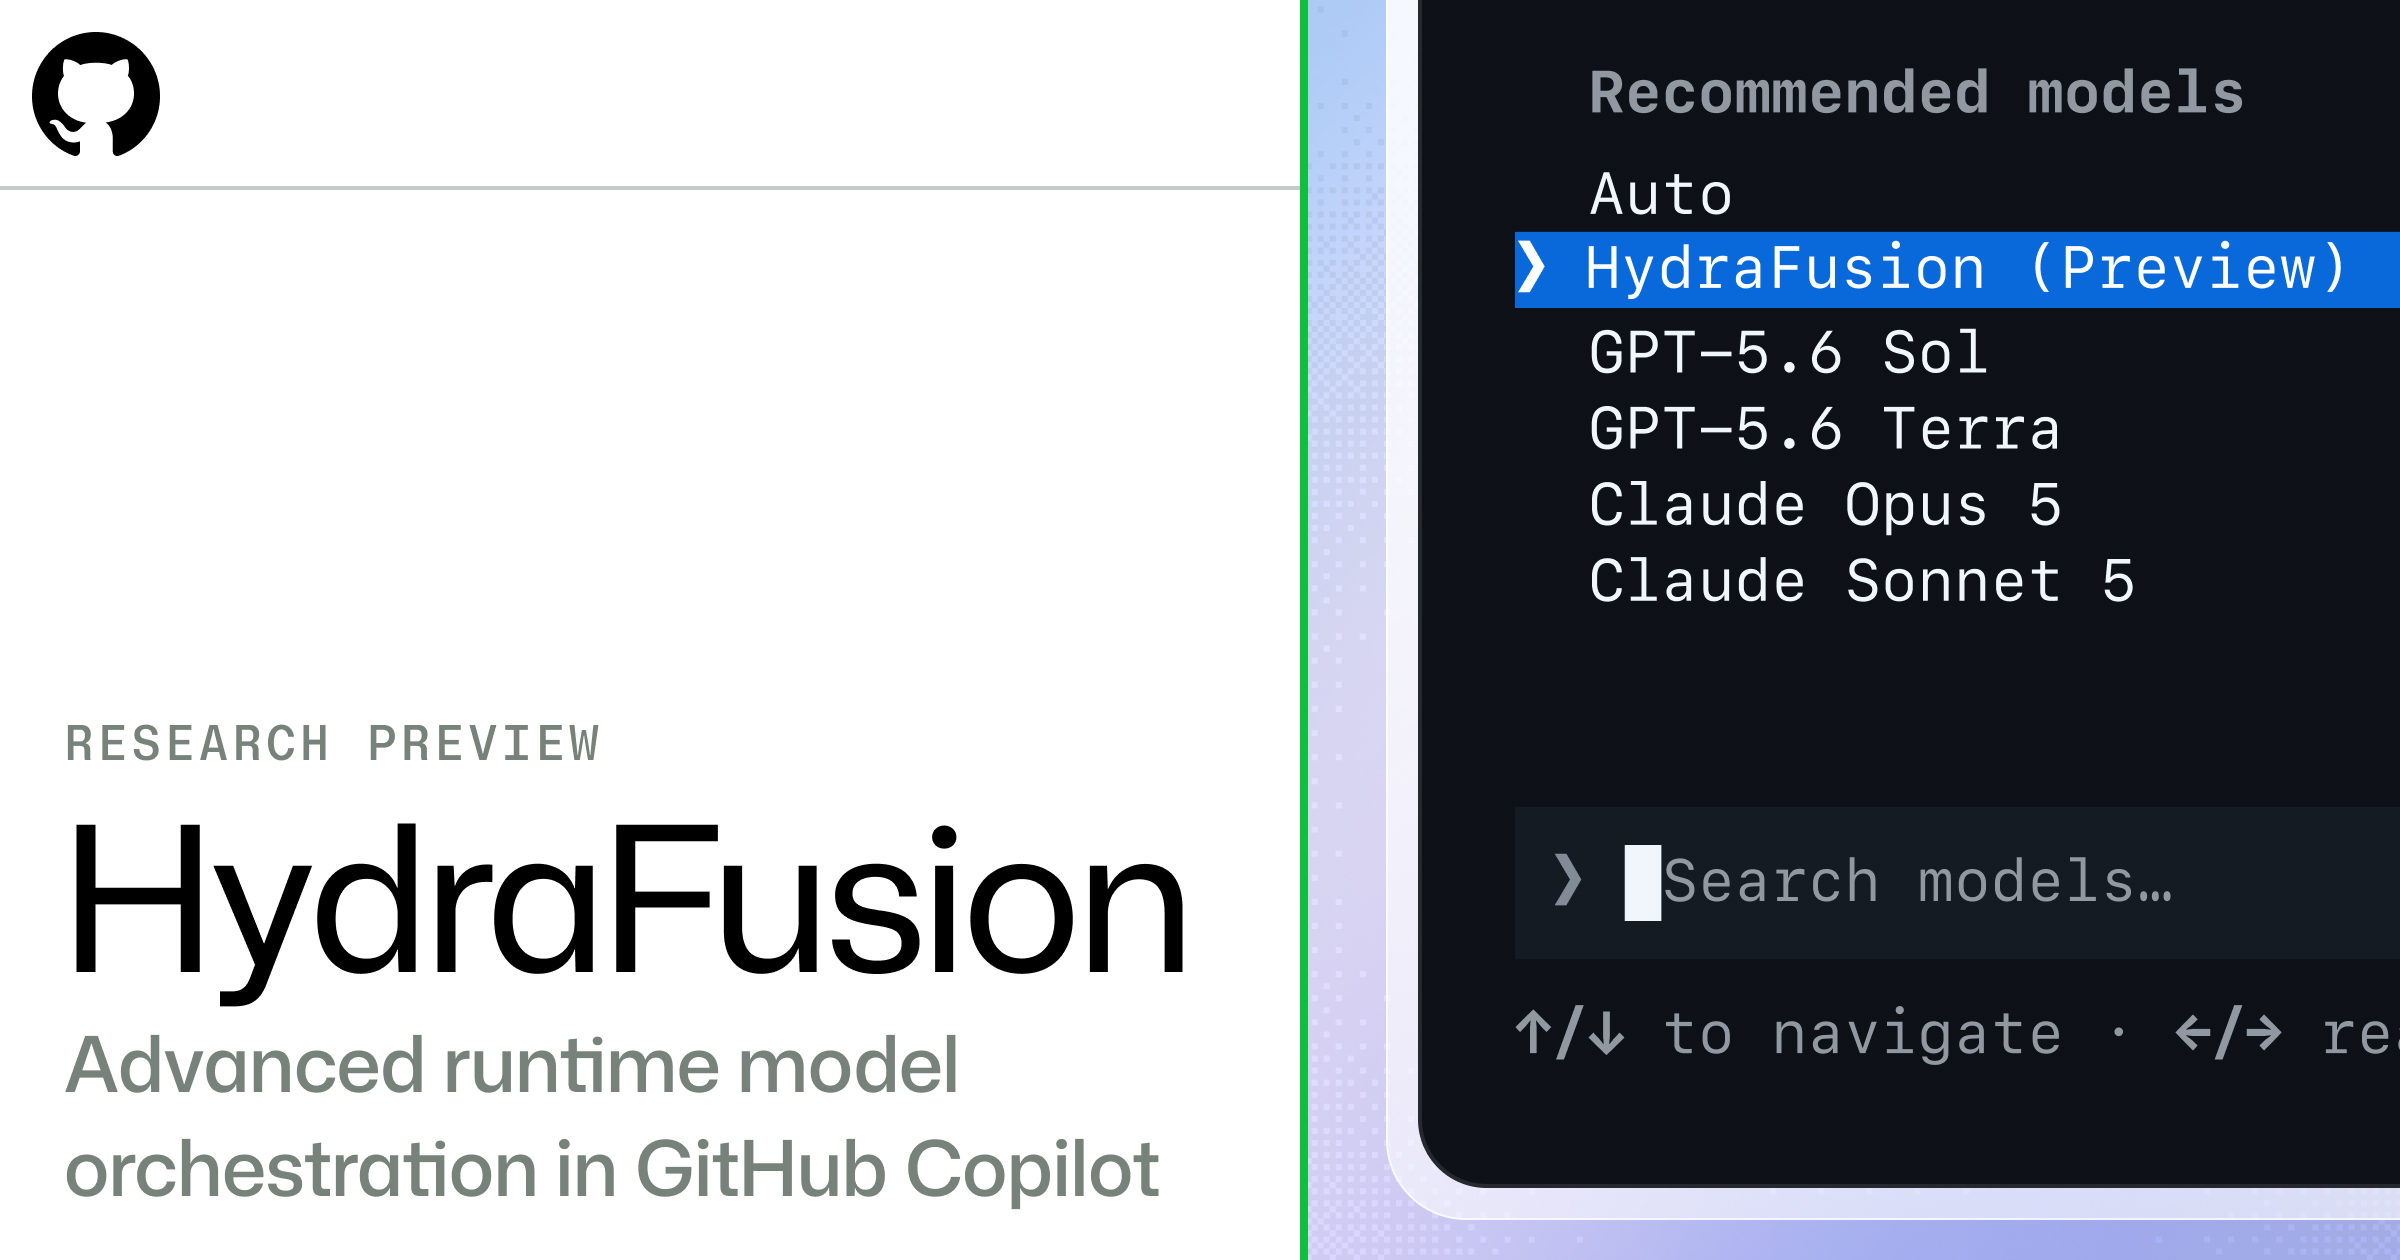
深入理解 GitHub Copilot HydraFusion:从选模型到编排工作流

Research preview: HydraFusion. Advanced runtime model orchestration in GitHub Copilot.

题图来自 GitHub Blog 的 Project HydraFusion。

9 月初 GitHub 放出了 HydraFusion,一个在 Copilot 模型选择器里排着的"模型",但它其实不是模型。我把官方博客、Changelog、社区讨论帖、HyDRA 论文和 Rubber Duck 的两篇文章放在一起读了一遍,想弄清楚三件事:它到底在每一轮里做了什么,那组"成本降 67%、质量还更高"的数字能信到什么程度,以及现在值不值得切过去用。

……

阅读全文

在 Microsoft Foundry 的 Agent 中使用 Jev 做模型评估

本文参考了 Microsoft Community Hub 上 Robin Lester 的文章 Using Jev with Agents in Microsoft Foundry for Model Evaluation,下面是我整理的理解和步骤。

Jev 是什么

Jev 是 TypeSafe AI 推出的新模型,2026 年 9 月 15 日开放了抢先体验。TypeSafe 把它称为自家第一个“System One”模型,它不写长篇文字,只负责又快又结构化地做判断。

用法很直接:把一段状态或上下文交给它,再说明你想让它做什么判断,它会返回一个带类型的概率化结果。结果有三种形式:

……

阅读全文

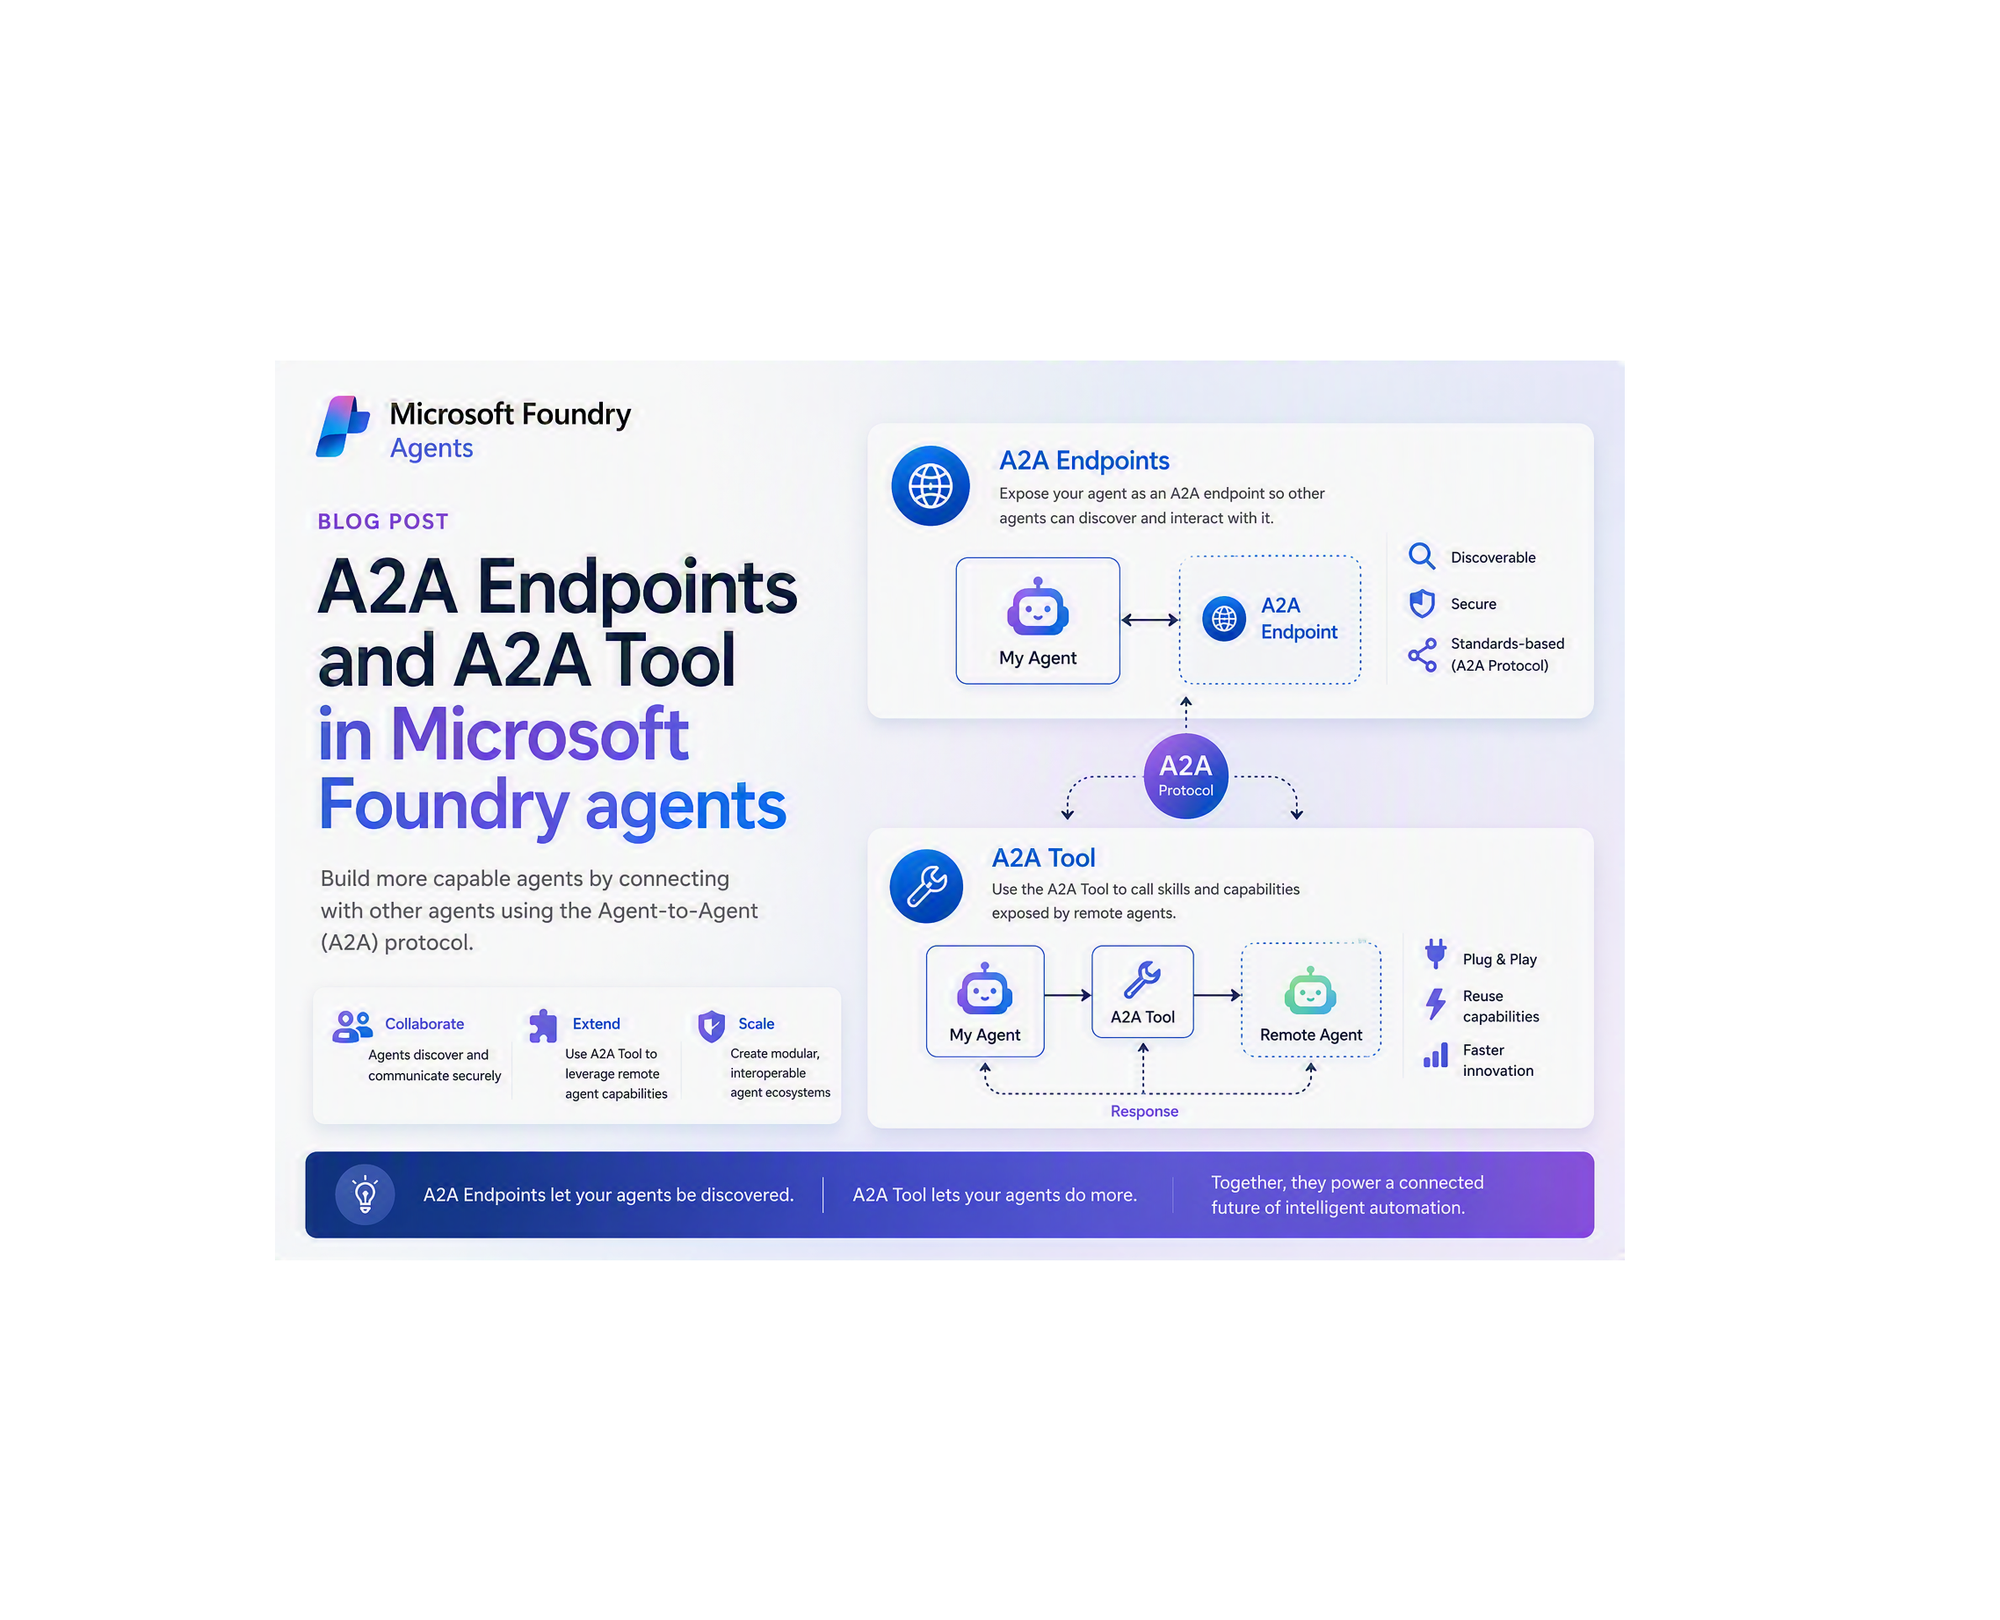
Microsoft Foundry 智能体的 A2A 端点与 A2A 工具

A2A Endpoints and A2A Tool in Microsoft Foundry agents

最近我在研究 Microsoft Foundry 的多智能体能力时,注意到一个变化:智能体之间的协作终于不用再靠一堆自定义 API 拼凑了。A2A 工具和新的入站 A2A 端点现在支持 A2A 协议 1.0 版本,这个版本已经正式发布(GA)。之前预览阶段用的 a2a_preview 工具类型和 0.3 版协议依然保留,给已有的集成留了一条兼容路径。托管智能体(Hosted Agents)也可以通过暴露在 MCP 上的 Foundry 工具箱来使用 A2A 工具。

……

阅读全文

评估智能体 AI:Microsoft Foundry 如何超越“最终答案质量”

原文:Evaluating Agentic AI in Microsoft Foundry: Beyond Final-Answer Quality,作者 jothsnapraveena,发布于 2026-09-10

AI 系统正在从单轮对话助手演变成会调用工具的智能体,评估方式也必须跟着变。这是我最近研究 Microsoft Foundry 智能体评估功能时最直接的感受。

做传统 LLM 应用的团队,通常只关心最终回复是否相关、连贯、有依据。但智能体不一样,这只是问题的一部分。

……

阅读全文

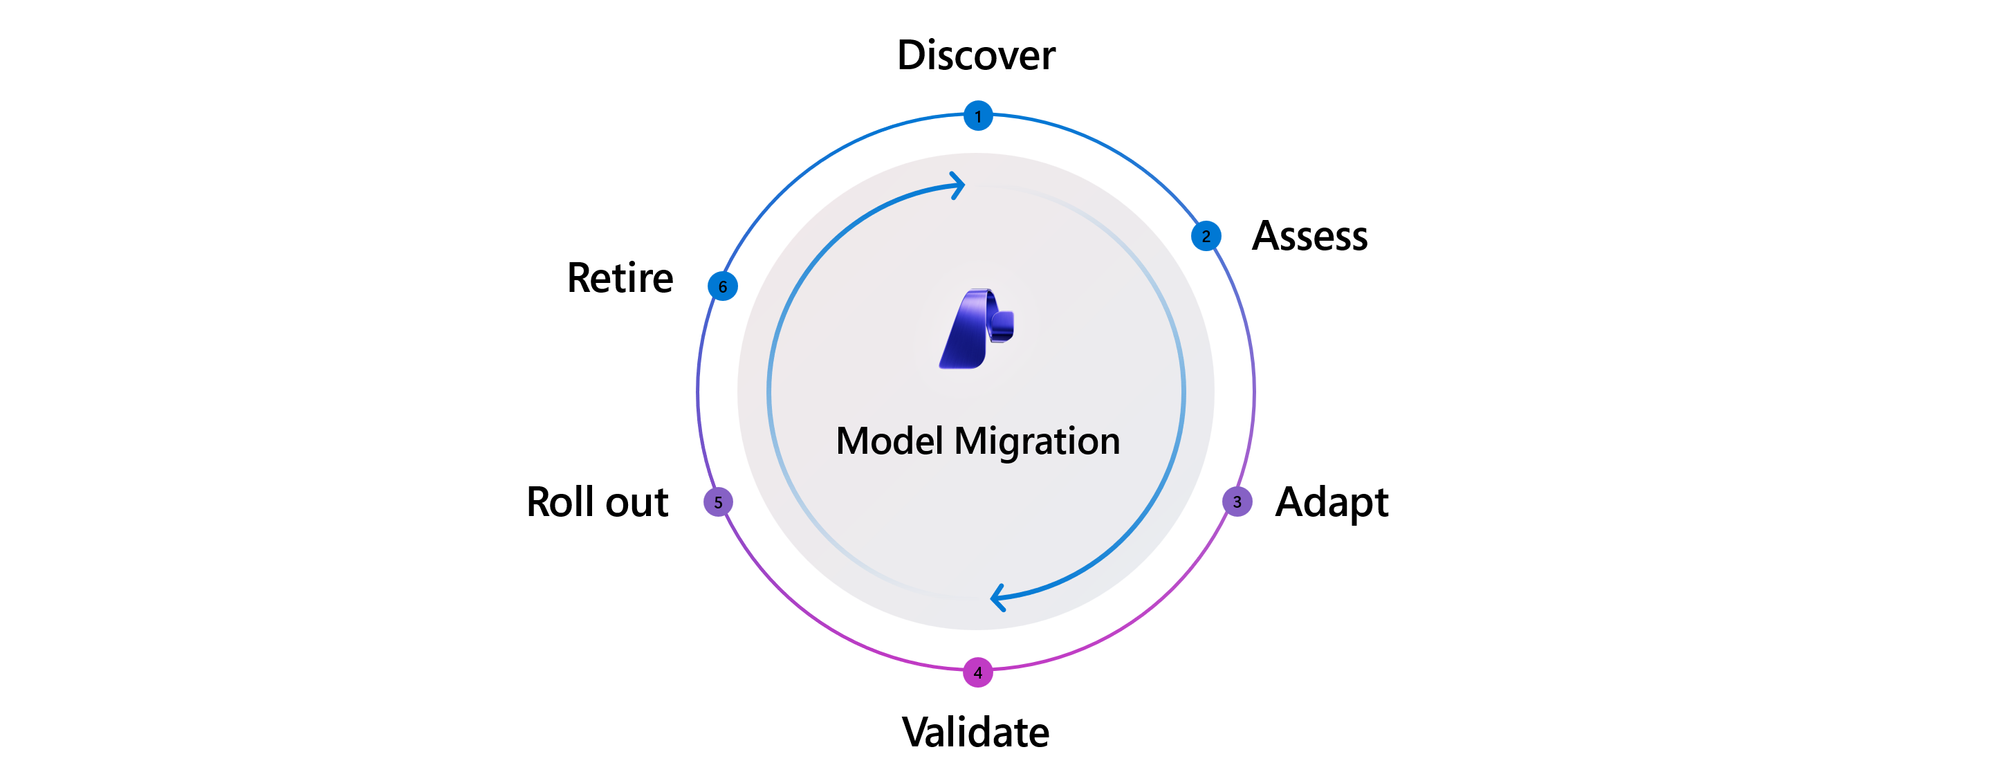
Microsoft Foundry 与 Azure OpenAI 模型迁移全流程

本文整理自 Microsoft Community Hub 的文章 Model Migration Process on Microsoft Foundry and Azure OpenAI,原作者 Meera Kurup(Microsoft)。我把里面这套模型迁移流程读了几遍,觉得挺实用,就整理成中文分享给大家,案例和数据都保留了原文的说法。

只要你的应用是跑在某个大模型上的,迟早会碰到换模型这件事。可能是你在用的模型被官方标了退役日期,也可能单纯是有更好、更快或更便宜的新模型出来了。把代码里的模型名从 gpt-4o 换成 gpt-5.1,理论上一行代码就能搞定。但这一行代码背后藏着的工作量,经常被严重低估。

……

阅读全文

最近文章

分类

标签

友情链接

其它