[译]基于模型的机器学习 - 5.5 建模星级评分
我们的模型把完整的星级评分范围变成了简单的喜欢或不喜欢,这意味着它丢弃了大量有用的信息。给一部电影打 3 星和打 5 星之间有天壤之别,然而我们却把这两种情况同等对待。为了利用不同的星级评分,我们需要改变模型,使其能够处理完整的评分范围,而不是二值的喜欢/不喜欢。这不仅让我们能够在星级评分上训练,还让我们能够预测星级评分——一举两得!
我们可以在已经设计好的二值喜欢/不喜欢模型的基础上做出这一改变。在这个模型中,我们有一个 affinity(好感度)变量,它是一个连续的数字,表示一个人对一部电影的喜欢程度。目前我们在零处对这个好感度取阈值,说大于零的值意味着这个人喜欢这部电影,小于零的值意味着他们不喜欢这部电影。为了建模不同的星级评分,我们可以假设更高的好感度意味着一个人会给出更高的星级评分。更确切地说,我们现在不再只在零处取阈值,而是为每一个星级评分引入一个阈值。如果一个人对一部电影的好感度高于某个特定星数的阈值,那么我们就预期他们会给这部电影至少那么多星。
要把这些阈值加入我们的模型,我们需要再做一个额外的假设。我们需要决定是否应该对所有人使用相同的阈值,还是不同的人可以有不同的阈值。允许不同的阈值可能是有用的——例如,有可能某些人给一部真正糟糕的电影打两星,而另一些人给一部真正糟糕的电影打一星甚至半星。如果我们想建模这些不同的行为,我们就需要允许不同的人有不同的阈值。这可以做到,但它会引入数据稀缺的问题,因为某些人对某些特定阈值可能没有任何评分。我们不去解决这些问题,而是做一个简化假设:所有人的阈值都相同。我们可以精确地表述这个假设,如下所示:
6 当两个人对一部电影有相同的好感度时,他们会给它相同的星数。
图 5.19 展示了对一个扩展模型编码这一假设的因子图。在这个模型中,我们添加了一个新变量 starThreshold,它位于一个 stars 板块内,意味着对每一个星数都有一个阈值。
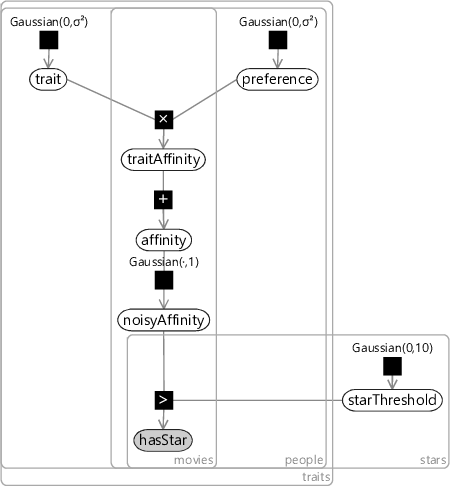
图 5.19:一个能够消费和预测星级评分的推荐模型的因子图。如正文所讨论,评分间接地使用变量 hasStar 的二值来表示。
对于每一部电影和每一个人,这个图中被观测的变量现在被称为 hasStar。这个变量位于 stars 板块内,因此对每一个星数都有一个值。换句话说,每一个单独的星级评分都被表示为一组二值变量。对于某个特定星数的二值变量,当评分至少达到那个星数时为真。举个例子,三星的评分意味着前三个二值变量为真,而其余两个为假。图 5.20 展示了星级评分与用于观测 hasStar 的二值之间的关系。
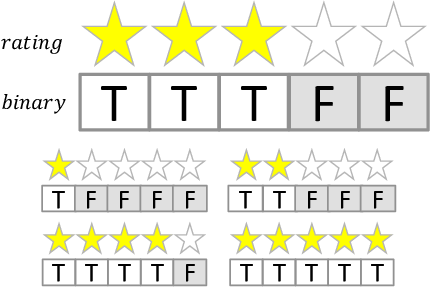
图 5.20:不同星级评分与图 5.19 因子图中 hasStar 变量所用二值之间的关系。
当我们训练这个模型时,我们把 hasStar 设为图 5.20 中对应评分所给出的观测值。当使用这个模型做推荐时,我们会得到每个二值变量为真的后验概率。这些可以通过减法转换为拥有某个特定星数的概率。例如,如果我们预测拥有 3 星或以上的概率是 70%、拥有 4 星或以上的概率是 60%,那么恰好拥有 3 星的概率一定是 $70\%-60\%=10\%$。使用这个技巧,我们可以把各个二值概率转换回每个星级评分各自的概率。
在我们能够训练这个模型之前,还有几个细节需要处理。首先,在我们的数据集中,我们需要能够处理半星评分,比如 3½ 星。我们可以通过把阈值数量翻倍来处理它们,从而既有整星评分的阈值,也有半星评分的阈值。其次,星级阈值与偏置之间存在一种对称性——给所有用户或电影偏置加上一个常数值、再从所有阈值中减去那个值,会导致相同的预测。这可以通过把其中一个阈值固定为零来解决——在我们的实验中,我们选择把三星阈值固定为零。最后,如果你看图 5.20,你会注意到第一个二值总是为真。这意味着好感度必须始终大于最低的阈值,所以我们可以简单地把它从模型中移除。在我们的情形下,这意味着不会有 ½ 星的阈值,因此最低的阈值将是 1 星的。有了这些改动,我们现在就准备好训练了!
使用星级评分的结果
既然我们能够在星级评分上训练,我们就可以使用和之前相同的训练数据(5.3 节),但不再把评分转换为喜欢/不喜欢。当我们做这样的训练时,我们期望来自星级评分的额外信息能让我们在特质空间中更精确地定位电影。回到之前的图 5.14,我们发现,在喜欢/不喜欢上训练之后,有 158 部电影在特质空间的每个维度上都有小于 0.2 的后验方差。在星级评分上训练之后,具有如此低后验方差的电影数量增加了,证实了这些额外信息确实让我们能够更精确地定位电影。
作为训练模型的一部分,我们还学到了每个星级评分的高斯后验阈值——这些展示在图 5.21 中。
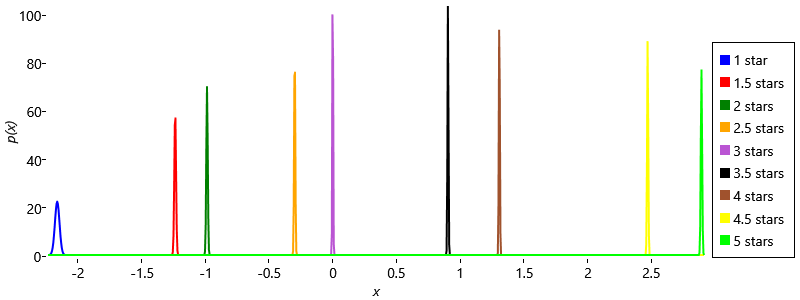
图 5.21:从 1 星到 5 星的星级评分阈值的后验分布。3 星的阈值被固定为恰好为零——所有其他阈值都是学习得到的。
这些阈值后验值得一看。首先要注意的是,阈值从 1 星到 5 星被正确地排序了,正如我们所预期的。这种排序并没有在模型中直接强制,因为所有阈值的先验都是相同的——相反,这种排序是从模型被训练的方式中产生的。另一件要注意的事是,1 星的后验分布比其他阈值宽得多。这是因为训练集中半星和一星极少(要确认这一点,回看之前的图 5.12)。正是这些评分被用来学习 1 星的阈值,因此它们的相对稀缺导致了阈值位置上更高的不确定性。最后一点是,半星阈值一般更靠近其上方的整星评分,而不是下方的。例如,3½ 星阈值离 4 星阈值比离 3 星阈值近得多。这意味着当一个人给一部电影打 3½ 星时,在他们心中,他们认为那几乎和一部 4 星电影一样好,而不是仅仅比 3 星电影好一点。另一种解释是,某些人可能从不使用半星(这就能解释为什么它们比周围的整星相对更稀缺),这会在推断出的阈值中引入一些偏置。思考如何改变模型以反映某些人从不使用半星这一事实,是一个有趣的练习。
使用我们新训练的模型,我们可以为和 5.4 节中完全相同的人和电影做预测。既然我们的模型现在预测的是星级评分,我们就可以绘制最可能的星级评分,而不是喜欢的后验概率。
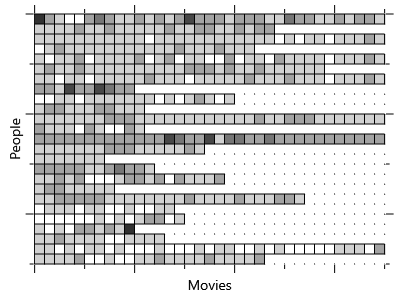
(a) 推断的最可能星数
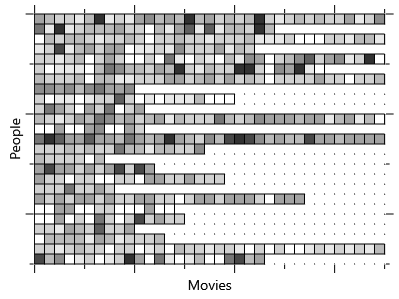
(b) 真实标签星数
图 5.22:我们带星级评分的推荐模型的结果。(a) 预测的最可能评分,其中白色方块对应五星,黑色对应半星,灰色的深浅表示介于两者之间的星数。(b) 使用相同颜色标度的真实标签评分。
图 5.22a 很好地展示了,我们现在能够预测星数,而不仅仅是喜欢或不喜欢。比较两幅图,我们可以看到我们的预测中有时存在较暗或较亮的区域,与真实标签中的区域相对应——但同样常常并非如此。几乎不可能看着图 5.22 就说出新模型是否比旧的做出了更好的推荐。相反,我们需要做一个定量的比较,通过重新计算和之前相同的指标并比较结果。对于 NDCG,我们可以按星级评分对推荐排序,并像之前一样完全相同地计算这个指标。对于喜欢/不喜欢准确率,我们需要把星级预测转换回二值的喜欢/不喜欢预测。我们可以通过把所有 3 星或更高评分的概率相加来做到——如果这个和大于 0.5,那么我们预测这个人会喜欢这部电影,否则预测他们会不喜欢它。图 5.23 显示,我们的新模型有明显改善的 NDCG,证明了使用完整星级评分的价值。这种改善甚至在我们相对不敏感的“预测正确比例”指标上也体现了出来,尽管变化要小得多。
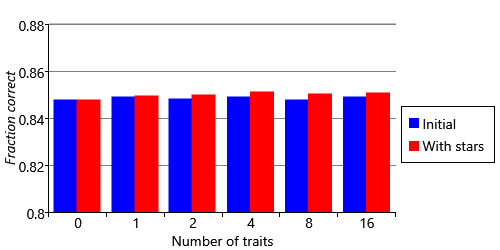
(a) 预测正确的比例
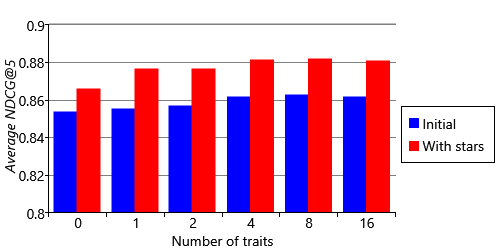
(b) 平均 NDCG@5
图 5.23:旧的喜欢/不喜欢模型与新的带星级评分模型两个指标的比较。星级评分模型给 NDCG 带来了显著的提升,甚至在喜欢/不喜欢准确率上也显示出了小的改善。
因为我们在计算喜欢/不喜欢准确率指标时把不同星级评分的概率加在一起,我们其实丢弃了关于我们推荐的信息。例如,我们丢弃了我们预测的是 3、4 还是 5 星。其结果是使这个指标对准确性的改善不那么敏感。我们只是为了能够和最初模型的结果做比较,才为图 5.23 计算了它。既然我们现在有了星级评分的预测,我们就需要用一个能够利用评分的新指标来替代这个指标。对于这个新指标,我们可以看预测评分正确匹配真实标签评分的次数比例。然而,这将意味着一个差半星的预测会和一个差四星的预测被同等对待。相反,我们可以看预测的星数离实际星数有多远,于是误差为:
$$ \text{误差} = |\text{预测星级评分} - \text{真实标签星级评分}| \tag{5.1} $$在方程 (5.1) 中,竖线表示我们取差的绝对大小。例如,如果预测是两星、真实标签是五星,误差就是 3.0。如果我们把这两者互换,使预测是五星、真实标签是两星,误差同样是 3.0。因为我们使用这个绝对大小,我们把这个误差称为绝对误差。为了在所有预测上计算一个指标,我们对每个预测的绝对误差取平均,得到一个称为平均绝对误差(Mean Absolute Error,MAE)的指标。
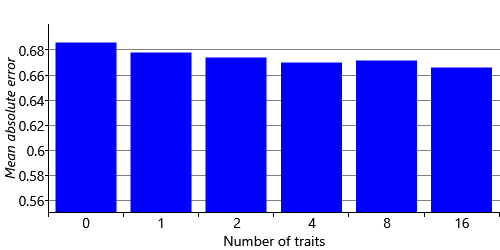
图 5.24:我们新的星级评分模型中不同特质数量下的平均绝对误差。随着我们增加特质数量,MAE 一般略有下降。
图 5.24 展示了在我们新模型中,为不同特质数量计算的这个指标。把三个指标放在一起看,拥有更多特质一般似乎能给出更高质量的推荐。所以我们可以选择使用我们最新模型的 16 特质版本,它给出的 NDCG@5 为 0.881、MAE 为 0.663。虽然这给了我们迄今为止表现最好的推荐系统,但能够做出进一步的改进仍然是好的。在下一节中,我们将诊断我们仍在哪里犯错,并研究一种进一步提高推荐准确性的方法。
本页引入概念回顾
绝对误差(absolute error):预测值与对应真实标签值之间的差,忽略结果的符号。2 星和 5 星之间的绝对误差是 3。5 星和 2 星之间的绝对误差也是 3。因为我们忽略符号,绝对误差总是正的(或为零)。
平均绝对误差(mean absolute error):在所有预测上,预测值与真实标签值之间绝对误差的平均值(均值)。这个指标可能的最佳值是 0。所有其他值都是正数,较小的值被认为优于较大的值。
下一节:另一个冷启动问题
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-09-22-mbml-recommender_modelling_star_ratings/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。