[译]基于模型的机器学习 - 5.1 学习用户和电影
本章的目标是向特定的人做出个性化的电影推荐。思考这个问题的一种方式,是想象一张表格,其中行是电影、列是人。表格的单元格显示这个人喜欢还是不喜欢这部电影——例如,如表 5.1 所示。这张表格是一个例子,展示了我们用来训练推荐系统时可能拥有的那类数据:我们询问了若干人,让他们说出自己是喜欢还是不喜欢某些特定的电影。
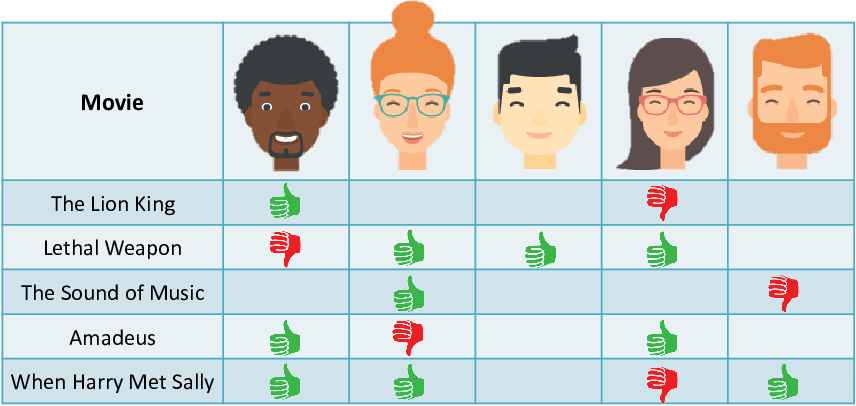
表 5.1:一张表格,显示用于训练推荐系统的那类数据。每一行是一部电影,每一列是一个人。填充的单元格表示某人已经说出他喜欢或不喜欢某部电影。空白的单元格表示我们没有任何关于这个人是否喜欢这部电影的信息,因此正是我们可以做出喜欢/不喜欢预测的地方。为某人一列中的每个空白单元格都做出这样的预测,就能让我们为那个人做出电影推荐——例如,推荐那部这个人最有可能喜欢(概率最高)的电影。
表 5.1 中的空白单元格表示我们不知道这个人是否喜欢这部电影。这样的空白单元格必然存在——我们不可能就每一部电影都去询问每一个人,而且即便我们这样做了,也总会有某个人还没看过的电影。我们的推荐系统的目标,可以被看作是填补这些空白单元格。换句话说,给定一个人和一部电影,预测他会喜欢还是不喜欢那部电影。那么,我们该如何着手做出这样的预测呢?
刻画电影
让我们从思考如何刻画一部电影开始。直观地讲,我们可以假设每部电影都具有某些特质(trait),比如它是逃避现实的还是写实的、是动作片还是情感片、是搞笑的还是严肃的。如果我们把某个特定的特质想象成一条线,我们就可以想象把电影放置在那条线上,就像这样:
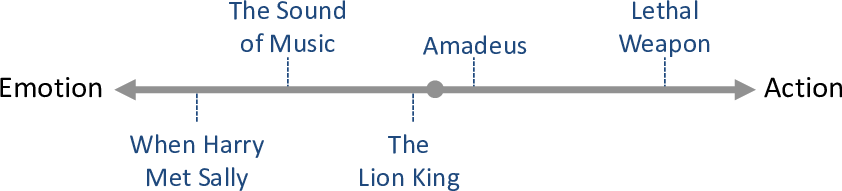
图 5.2:电影被放置在一条线上,这条线表示每部电影在多大程度上是一部情感片或一部动作片(或者两者都不是)。
靠近线左端的电影是情感片,比如浪漫喜剧。靠近线右端的电影是动作片。靠近线中间的电影是中性的——既不是动作片也不是情感片。注意,在定义这个特质时,我们做了一个假设:动作和情感是彼此对立的两端。
现在让我们来考虑人。某个特定的人可能喜欢情感片而不喜欢动作片。我们可以把这个人放置在线的左侧(图 5.3)。我们会预期这样的人喜欢线左端的电影、不喜欢线右端的电影。
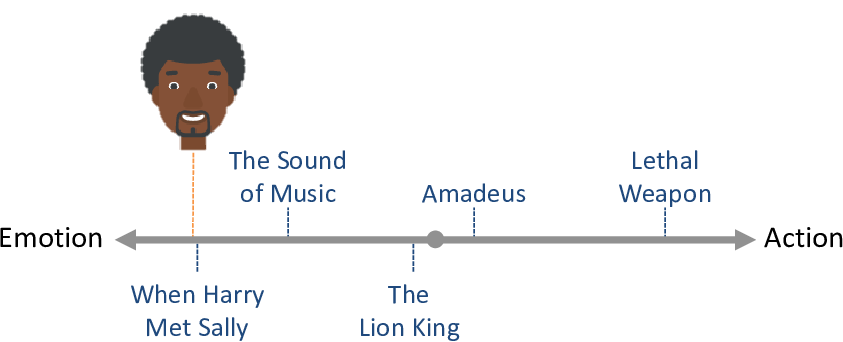
图 5.3:一个被放置在线左侧的人,会被预期喜欢情感片、不喜欢动作片。
另一个人可能有相反的口味:不喜欢情感片、热爱动作片。我们可以把这个人放置在线的右侧(图 5.4)。我们会预期这样的人不喜欢线左端的电影、喜欢线右端的电影。
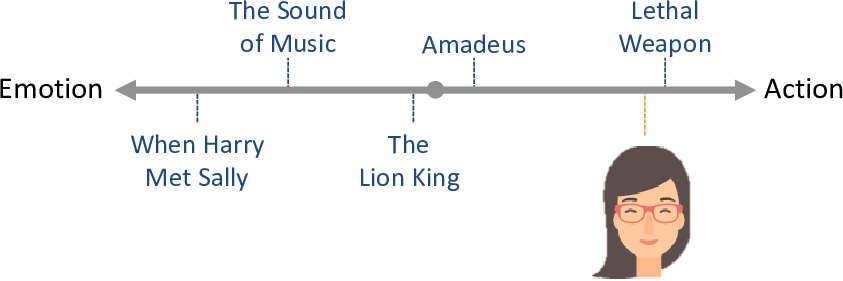
图 5.4:一个被放置在线右侧的人,会被预期喜欢动作片、不喜欢情感片。
一个人当然也完全可能既喜欢(或既不喜欢)动作片又喜欢(或又不喜欢)情感片。我们可以认为这样的人对动作/情感这个特质是中性的,把他放置在线的中间(图 5.5)。我们会预期这样的人可能喜欢或不喜欢线上任何位置的电影。
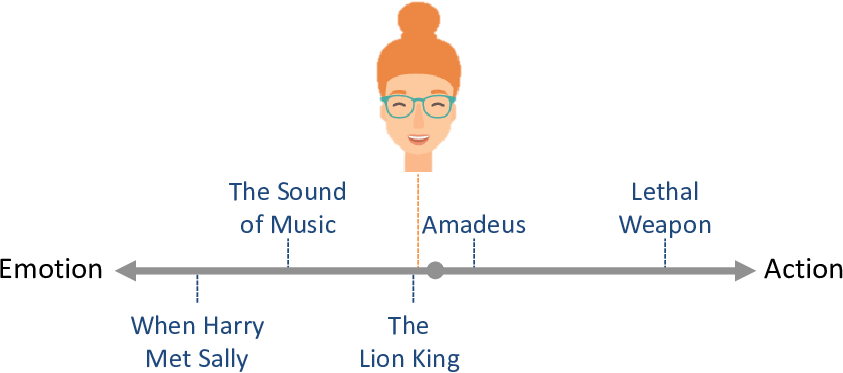
图 5.5:一个被放置在线中间的人,会被预期并不在意一部电影是动作片还是情感片。
我们希望用这样一种方法来做出个性化的推荐。问题在于,我们并不知道电影落在线上的什么位置,也不知道人落在线上的什么位置。幸运的是,我们可以用基于模型的机器学习,借助一个合适的模型来推断出这两者。
一个特质的模型
让我们为刚才描述的动作/情感特质构建一个模型。首先,让我们陈述几条从上面的描述中得出的假设:
- 每部电影都可以由它在特质线上的位置来刻画,这个位置表示为一个连续数值。
- 一个人的偏好可以由他在特质线上的位置来刻画,同样表示为一个连续数值。
在我们的模型中,我们将用一个 trait 变量来表示每部电影在特质线上的位置。由于它在各部电影之间被复制,这个变量需要放在一个 movies 板之内。我们还需要一个变量来表示这个人在线上的位置,我们将称之为 preference,因为它编码了这个人关于该特质的偏好。为了做出预测,我们需要一个变量来表示这个人被预期在多大程度上喜欢每部电影。我们将称之为 affinity 变量,并假设这个变量取正值意味着我们预期这个人喜欢这部电影,取负值意味着我们预期这个人不喜欢这部电影。
我们需要一种方法把 trait 和 preference 结合起来,从而得到上一节所描述的行为。也就是说,一个 preference 为负(线左端)的人应当偏好 trait 值为负(线左端)的电影。一个 preference 为正(线右端)的人应当偏好 trait 值为正(线右端)的电影。最后,一个 preference 接近零的中性的人,无论电影的 trait 值是多少,都不应偏好任何电影。这种行为可以概括为一条假设:
preference取正值意味着这个人偏好trait取正值的电影(负值的情形反之亦然)。preference值的绝对大小表示偏好的强度,其中零表示无所谓。
这条行为假设可以通过把 affinity 定义为 trait 与 preference 的乘积,编码进我们的模型。因此我们可以用一个乘积因子把这些变量连接起来,得到图 5.6 的因子图。
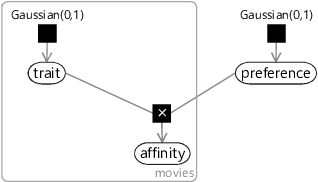
图 5.6:单个特质的因子图。每部电影都有一个 trait 值,它与这个人的 preference 相乘,得到这个人对那部电影的 affinity。affinity 值越正,意味着这个人越可能喜欢这部电影。
如果你的记性非常好,你可能会注意到,这个因子图与上一章中单特征分类器的因子图(图 4.1)几乎完全相同。唯一的区别在于,我们这里有一个未观测的 trait 变量,而之前我们有的是一个已观测的 featureValue。从某种意义上说,我们可以把我们的推荐模型看作是在根据人们的喜欢和不喜欢来学习一部电影的特征——这一点我们稍后会更多地讨论。随着我们逐步构建推荐模型,你会看到它在许多方面都与第 4 章中的分类模型相似。
有了这个因子图,我们希望从关于这个人对电影的喜欢和不喜欢的数据中,同时推断出电影的 trait 值和这个人的 preference。要做任何形式的学习,我们都需要在模型中拥有某个我们能够观测的变量——更具体地说,我们需要一个能取两个值之一(喜欢或不喜欢)的二值变量。而现在我们只有一个连续的 affinity 变量,而不是一个二值变量。听起来是不是很熟悉?没错!我们早在上一章的第 4.2 节中就遇到过完全相同的问题,当时我们想把一个连续的 score 转换成一个二值的回复预测。我们当时的解法是加入高斯噪声,然后对结果做阈值处理,以得到一个二值变量。我们在这里可以使用完全相同的解法:制作一个 affinity 的带噪声版本(称为 noisyAffinity),然后对它做阈值处理,以得到一个二值的 likesMovie 变量。最终结果就是图 5.7 的因子图(它与上一章的图 4.4非常相似)。
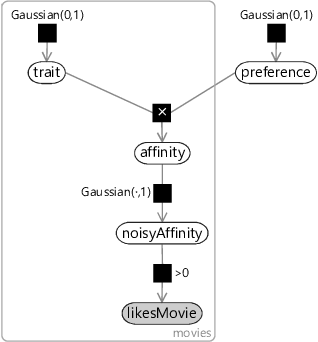
图 5.7:扩展后的因子图,它把连续的 affinity 转换成一个二值的 likesMovie 变量,这个变量可以被观测以训练模型。
我们本可以开始用这个只有一个特质、一个人的模型,但那不会让我们走得很远——我们只能了解到这个人已经评过分的那些电影,因此也就只能推荐他已经看过的电影。在下一节中,我们将扩展我们的模型,以处理多个特质和多个人,从而能够更准确地刻画电影,并把许多人汇集在一起的评分信息利用起来,为每个人提供更好的推荐。
下一节:多重特质与多人
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-09-06-mbml-recommender_learning_about_people_and_movies/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。