[译]基于模型的机器学习 - 6.2 试验模型
现在我们有了一个完整的模型,可以在一些研究数据上试验它了。正如本书前面多次强调的,在使用真实数据集时,务必仔细查看数据集,确保它是完整、正确且符合你预期的形式。请记住,许多常见的机器学习问题都是由数据问题引起的(例如第 2.5 节中列举的那些)。检查数据集的一个好办法是构建可视化,让你一眼就能看清它的样子。在本例中,我们需要为每个孩子、每种过敏原和每个时间点创建检测结果的可视化。然而,这个研究数据集包含私密的医疗数据,因此我们无法在本书中公开分享这些数据,哪怕是以可视化的形式。从这次可视化中我们学到的最重要一点是:数据集中有大量检测结果缺失。
当存在缺失数据时,总是值得分析一下它们为什么缺失。在图 6.6 中,我们绘制了数据集中每个年龄、每种检测类型的检测结果数量(无论阳性还是阴性)。
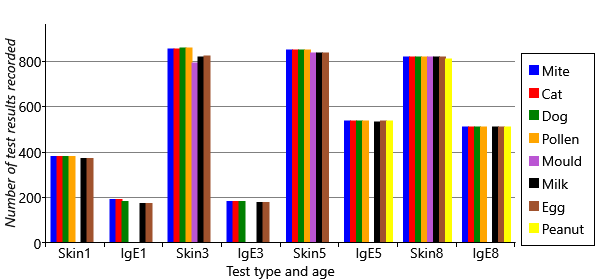
图 6.6:为两类检测各自记录的检测结果,按孩子的年龄拆分。
你可以在图 6.6 中看到几种不同的缺失数据模式。首先,图中显示某些年龄和检测类型对特定过敏原完全没有数据。例如,花生在 1 岁和 3 岁完全没有结果,5 岁时只有 IgE 结果。霉菌完全没有 IgE 结果,1 岁时也没有皮肤试验结果。其次,越早的年龄缺失数据越多,尤其是 1 岁。第三,图中显示 IgE 检测总体上比皮肤试验缺失得多。我们需要把所有这些缺失数据点的影响考虑进来。
处理缺失数据
缺失数据可能掩盖或扭曲数据集中的模式。
缺失数据可能在通过对模型运行推断所计算出的后验分布中引入偏差,导致错误或误导性的结果。这种影响是否会发生、偏差有多大,取决于数据点最初为什么会缺失。在统计学中,通常考虑三种缺失类型,它们用下面这些(相当令人困惑的!)术语来称呼:
完全随机缺失(missing completely at random,MCAR)——缺失数据点完全随机地出现。换句话说,数据缺失这一事实与该缺失数据点的取值(即如果检测真的做了本会得到的检测结果)无关。
当数据是 MCAR 时,剩下的、未缺失的数据点实际上就是整个数据集的一个随机子集。在这种情况下,概率推断计算出的后验分布不会因缺失数据而产生偏差。遗憾的是,现实中缺失数据很少是完全随机缺失的。不过,假设它是,可能是一种可接受的近似——在这种情况下,做出这个假设时应充分理解可能引入偏差的风险。
随机缺失(missing at random,MAR)——缺失并非随机,但其他已知的数据值能够完全解释数据缺失这一事实。例如,假设男孩比女孩更可能拒绝 IgE 检测。考虑到男孩更可能有过敏,这会在我们的结果中引入偏差,因为缺失的检测比未缺失的检测更可能为阳性。
当数据是 MAR 时,至少在某种程度上,可以通过适当地修改模型来解释数据为什么缺失,从而校正偏差。这种扩展需要在模型中为每个数据点创建一个新变量:如果该数据点缺失则为 true,否则为 false,然后构建一个合适的子模型来解释这个新变量。例如,如果男孩比女孩更可能跳过 IgE 检测,那么为了校正偏差,我们需要扩展模型来表示这种效应,比如添加一个与缺失变量相连的新的性别变量。我们还需要让这个性别变量以适当的方式影响致敏的概率。这种方法在多大程度上校正缺失数据引入的偏差,取决于缺失模型有多好。一如既往,更好的模型会给出更好的结果。
非随机缺失(missing not at random,MNAR)——缺失既不是 MCAR 也不是 MAR。在这种情况下,一个数据点是否缺失取决于该数据点的取值。例如,如果有很多过敏的孩子因为担心阳性检测带来的不适而更可能跳过皮肤点刺试验,就会出现这种情况。又或者这类孩子更习惯于医疗干预,因而可能因为怕针而跳过血液检测的可能性更低。
当数据是 MNAR 时,若不对偏差的性质做出建模假设(这可能很危险,因为没有数据可以验证这些假设),就无法校正偏差。一种可能的做法是尝试收集与数据缺失原因相关的额外信息,希望借此把它变成随机缺失(MAR)。
关于处理缺失数据的更多信息,参见 Little and Rubin [2014]。
对于我们的研究,我们需要弄清各种缺失数据模式是如何产生的。再次咨询 MAAS 团队后,我们发现:
- 临床医生选择在 1 岁时省略霉菌检测,因为这是一种罕见的过敏,而且大家希望尽量减少对婴儿进行的检测数量。类似地,研究进行到一半时决定加入花生检测。
- 1 岁时检测数量减少是由于研究扩大过程中的人力限制——并非所有孩子都能在 1 岁前被带来检测。
- IgE 检测缺失较多,是由于孩子不愿意抽血,或者父母不愿意让婴幼儿抽血。
对于第 1 点,我们知道数据为什么缺失——因为临床医生选择不做某些检测。这类数据可以假设为完全随机缺失,因为在每个年龄执行哪些检测的选择,与任何检测结果无关。对于第 2 点,研究团队选择是否邀请某个孩子在 1 岁前来检测,因此可以用一种不受孩子过敏情况影响的方式(如随机)来选择。所以我们同样可以假设这类数据完全随机缺失。对于第 3 点,我们可能会更担心,因为现在是孩子或父母的决定在影响检测是否进行。如上文所讨论的,这更可能受到孩子过敏情况的影响,因此这类缺失数据有可能不是完全随机缺失的。为简单起见,我们将假设它是——这个假设如此重要,我们应当把它记录下来:
6 缺失的检测结果是完全随机缺失的。
做出这个假设后,我们应当记住,我们的推断结果可能包含偏差。一个令人安心的点是:在我们没有 IgE 检测结果的地方,往往有皮肤试验结果。这意味着即使 IgE 检测结果缺失,我们仍然掌握一些关于潜在致敏状态的信息,这很可能会减弱其缺失所导致的任何偏差。
缺失数据还有另一个影响。即便缺失数据没有引入偏差,如果缺失数据很多,它也可能带来不确定性,表现为非常宽的后验分布。例如,在若干时间点上我们没有霉菌或花生的数据,因此这些年龄的获得/保持概率会非常不确定,从而具有很宽的后验分布。当把这类很宽的分布放进结果图时,它们会分散人们对其余有意义结果的注意力。为了让我们的图尽可能清晰,我们干脆从数据集中去掉霉菌和花生这两种过敏原,只考虑其余六种过敏原。
一些初步结果
在决定把缺失数据当作完全随机缺失来处理之后,我们现在可以对模型应用期望传播并得到一些结果了。在有缺失数据点的地方,我们只是不观测对应随机变量的取值。
运行推断算法之后,我们首先要看的后验分布是 probSkinIfSens、probSkinIfNotSens、probIgeIfSens 和 probIgeIfNotSens 的后验。这些后验是 beta 分布,我们可以用一个均值加减一个表示 beta 分布宽度的值来概括,如表 6.3 所示。
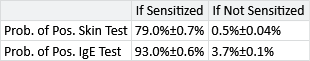
表 6.3:每种检测类型、每种致敏状态下的阳性检测概率。正负号后的值表示后验 beta 分布所给出的概率的不确定性。表中显示皮肤试验的假阳性率较低,但真阳性率也较低。反之,IgE 检测的假阳性率较高,但真阳性率非常高。这些结果表明,两种检测合在一起,具有互补的优势和劣势。
表 6.3 中的结果表明两类检测是互补的:皮肤点刺试验的假阳性率非常低(<1%),但因此真阳性率也随之降低($\sim79\%$);相比之下,IgE 检测的真阳性率很高($\sim93\%$),但因此假阳性率也较高($\sim4\%$)。两种检测的互补性说明了为什么它们要一起使用——每种检测都为孩子潜在的致敏状态带来额外的信息。在推断过程中,我们的模型会在推断每个时间点的致敏状态时自动把这些真阳性率和假阳性率考虑进来,从而既能获得两种检测各自优势带来的好处,又能把它们的劣势降到最低。
接下来,让我们看看为每种过敏原推断出的“初始拥有、获得和保持致敏”的概率。图 6.7a 显示了初始拥有致敏(1 岁)的概率,以及随后获得致敏(3、5、8 岁)的概率。类似地,图 6.7b 显示了自上一个时间点以来保持致敏的概率(仅 3、5、8 岁)。由于每个概率都有一个 beta 后验分布,图表使用每个 beta 分布的上下四分位数来展示与概率值相关的不确定性。
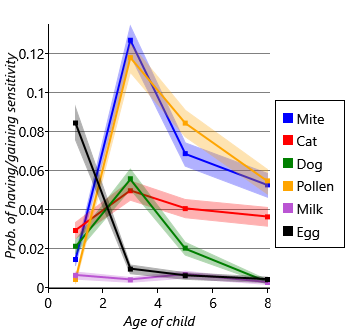
(a) 拥有致敏(1 岁)或随后获得致敏(3、5 和 8 岁)的概率。
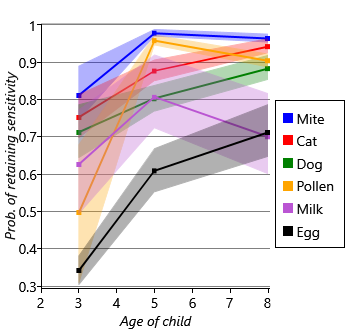
(b) 3、5 和 8 岁时自上一个时间点以来保持致敏的概率。
图 6.7:展示每个时间点、每种过敏原的 (a) 拥有/获得致敏和 (b) 保持致敏概率的图。
把图 6.7a 和图 6.7b 放在一起看,我们可以看到不同过敏原有不同的致敏起始和消退模式。例如,对鸡蛋的初始致敏概率很高,但在那之后获得致敏的概率非常低。鸡蛋保持致敏的概率也最低,这意味着孩子往往在生命很早期就出现鸡蛋过敏,然后迅速失去它。再举一例,尘螨和花粉的初始致敏概率非常低,但到 3 岁时获得致敏的概率非常高。在对尘螨或花粉致敏之后,保持该致敏的概率非常高。换句话说,对尘螨或花粉获得致敏的孩子最可能在 1 岁到 3 岁之间致敏,之后很可能保持该致敏(至少到 8 岁)。猫和狗彼此有相似的获得和消退模式,但两者的初始致敏概率都更高,峰值都比尘螨和花粉更低。牛奶显示出最低的致敏概率,意味着它在这批孩子中是一种罕见的过敏。因此,保持牛奶致敏的概率更不确定,因为它是从相对较少的孩子身上学到的。这种不确定性由图 6.7b 中牛奶那条很宽的阴影区域体现出来。
将这些结果可视化的另一种方式是查看推断出的致敏。我们已经推断出每个孩子在每个时间点对每种过敏原致敏的后验概率。然后我们可以统计“更可能致敏而非不致敏”(即概率 >50%)的孩子数量。为每种过敏原和年龄绘制这个致敏计数,就得到图 6.8。
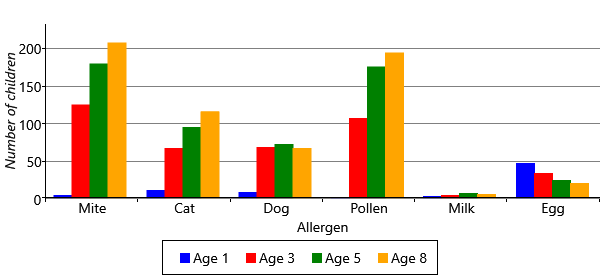
图 6.8:每种过敏原、每个时间点上被推断为致敏的孩子数量。
图 6.8 用另一种方式展示了获得和失去致敏的模式,即展示致敏孩子的计数。图表显示鸡蛋过敏起初很常见,随时间消失。图表还显示尘螨和花粉过敏在 1 岁到 3 岁之间开始,而过敏孩子的总数只随年龄增加。在许多方面,这张图比图 6.7a 和图 6.7b 的折线图更易读,因为它直接看致敏的计数,而不是看致敏的变化。而且所有信息都出现在一张图上,而不是两张。因此,随着本章后面对模型的演进,我们将使用这类图表来呈现结果。
总结一下,我们已经构建了一个能够学习获得和失去过敏致敏模式的模型。我们找到的模式适用于整批孩子——实际上它们是整个群体的模式。这个模型没有告诉我们的是:在这批孩子中,是否存在具有不同过敏致敏模式的子群体,而这些不同模式可能引发不同的疾病。把所有孩子放在一起看时,这个信息就丢失了。回顾我们的假设,有问题的是这一条:
5 与初始拥有、获得或保持对某种特定过敏原致敏相关的概率,对所有孩子都相同。
我们真正想做的是修改这个假设,允许孩子处于不同的分组,其中每一组孩子可以有不同的致敏模式。我们把这些分组称为“致敏类别”(sensitization classes)。假设于是变为:
5(修改后) 与初始拥有、获得或保持对某种特定过敏原致敏相关的概率,对每个致敏类别中的所有孩子都相同。
问题在于我们并不知道哪个孩子属于哪个致敏类别。我们需要一个能够表示获得和失去致敏的多种可选过程、并且能够判定每个孩子的数据是由哪种过程产生的模型。换句话说,我们需要能够为每个孩子的数据比较多个可选模型,并判定哪一个最可能是产生该数据的模型。要做到这一点,需要一些用于建模和推断的新工具,我们将在下一节中介绍。
本页引入的概念回顾
缺失数据(missing data) 在数据集中,缺失数据点是指某次观测中的某个变量没有可用值。取值缺失的原因很重要,会影响使用其余非缺失值进行概率推断的有效性。参见第 6.2 节。
完全随机缺失(missing completely at random) 缺失数据点完全随机地出现。换句话说,数据缺失这一事实与该缺失数据点的取值无关。
随机缺失(missing at random) 缺失数据点并非随机出现,但其他已知的数据值能够完全解释数据缺失这一事实。
非随机缺失(missing not at random) 缺失数据既不是完全随机缺失(MCAR)也不是随机缺失(MAR)。在这种情况下,一个数据点是否缺失取决于该数据点的取值。当数据非随机缺失时,很难避免推断结果中的偏差。
下一节:比较可选模型
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-10-12-mbml-asthma_trying_out_the_model/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。