[译]基于模型的机器学习 - 5.4 我们的首次推荐
有了我们训练好的两特质模型,我们现在准备好做一些推荐了!在训练期间,我们学到了每部电影和每个人在特质空间中(不确定的)位置。我们现在可以为验证集中每一条被留出的评分做预测。我们一次做一条评分——也就是说,一次针对一个人和一部电影。首先,我们把电影 trait 和人的 preference 的先验设为训练期间学到的后验。然后我们运行期望传播来推断 likesMovie 上的后验分布,以计算这个人会喜欢这部电影的概率。在验证集中所有评分上重复这一过程,就得到了每个人喜欢每部电影的概率,如图 5.15a 所示。图 5.15b 显示了对应的真实标签喜欢/不喜欢的值。
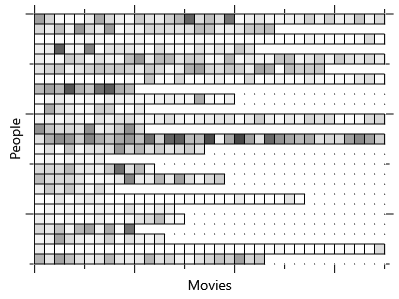
(a) 推断的喜欢概率
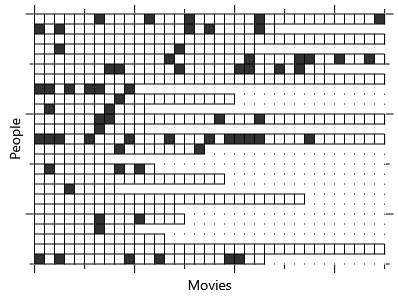
(b) 真实标签喜欢/不喜欢
图 5.15:我们推荐模型的初步结果。(a) 计算得到的每个人喜欢每部电影的概率。白色方块对应概率 1.0,黑色对应概率 0.0,灰色的深浅表示介于两者之间的概率值。(b) 真实标签——白色表示这个人喜欢这部电影,黑色表示他不喜欢。
从图 5.15b 中最先引人注意的一点是,人们大多喜欢电影,而不是不喜欢它们。因此从某种意义上说,我们给推荐系统设定的任务,是试图找出一个人不喜欢的少数几部电影。看图 5.15a 中预测的概率,我们可以在这个任务上看到一些成功——因为某些较暗的方块确实与真实标签中的黑色方块正确对齐了。此外,某些行总体上比平均更暗或更亮,表明我们能够学到每个人总体上有多可能喜欢或不喜欢电影。然而,这些预测并不完美——有许多不喜欢的电影被漏掉了,也有一些不喜欢的预测是错误的。但在我们对模型做任何改进之前,我们需要先决定用哪些评估指标来度量和追踪这些改进。
评估我们的预测
为了评估这些预测,我们需要确定一些评估指标。正如在第 2 章中讨论过的,考虑多个指标是明智的,以避免落入古德哈特定律所描述的陷阱。对于第一个指标,我们将直接使用预测正确的比例,即当我们预测 likesMovie 最可能的取值时。对于上面的两特质实验,我们看到有 84.8% 的预测是正确的。这个指标有助于追踪我们推荐系统的原始准确率,但它并不直接告诉我们,对用户而言我们的推荐体验会有多好。为此,我们需要一个更聚焦于推荐系统实际使用方式的第二个指标。
推荐系统最常见的用途,是向用户提供一个有序的推荐列表。我们可以使用我们预测的“喜欢”概率来生成这样一个列表:把概率最高的电影放在最前面,然后是概率第二高的,以此类推。在这种场景下,一个合理的假设是,用户会浏览这个列表以寻找一个吸引人的推荐——但他们可能在浏览过程中的某个时刻放弃。由此可知,列表中第一项正确是最重要的,然后是第二项、第三项,如此一直到列表末尾。我们希望使用一个评估指标,它对列表开头正确预测的奖励多于对列表末尾的(并且对列表开头错误的惩罚多于对列表末尾错误的)。
一个具有这种行为的指标是折损累计增益(Discounted Cumulative Gain,DCG),它被定义为各个推荐得分的总和,每一个都由一个取决于该推荐在列表中位置的折损函数加权。图 5.16 展示了对一个含五个推荐的列表计算 DCG 的过程。在这幅图中,所使用的折损函数是 $\frac{1}{\log_2(\mathit{position}+1)}$,其中 $\mathit{position}$ 是列表中的位置,从 1 开始。这个函数经常被使用,因为它随列表位置平滑地递减,如图中蓝色条形所示。我们将为一个推荐使用的得分,是这个人给那部电影打的真实标签星数。所以如果他们打了三星,那么得分就是 3。由于我们是在为一个含五个推荐的列表计算 DCG,我们有时把它写作 DCG@5。
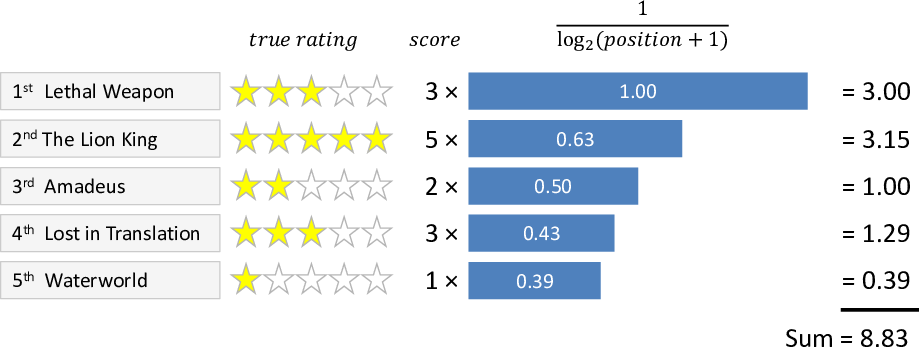
图 5.16:对一个含五部电影推荐的列表计算折损累计增益(DCG)。
只有当我们知道一个人对被推荐电影的实际评分时,我们才能评估这个推荐。对于我们的数据集,这意味着我们只能为验证集中那 30% 评分所涉及的电影做推荐。实际上,我们会把这些电影从“最可能喜欢这部电影”到“最不可能喜欢这部电影”排序,取前 5 部,并用 DCG 来评估这个排序。
DCG 的一个问题是,其可达到的最大值会随这个人给验证集电影所打的评分而变化。如果有 5 个高评分,那么可达到的最大 DCG@5 就会很高。但如果只有 2 个高评分,那么可达到的最大 DCG@5 就会较低。为了解读这个指标,我们真正想知道的只是我们离可达到的最大 DCG 有多近。我们可以通过计算最大 DCG(如图 5.17 所示)、然后把我们的 DCG 值除以这个最大可能值来实现这一点。这就得到了一个新指标,称为归一化折损累计增益(Normalized Discounted Cumulative Gain,NDCG)。NDCG 为 1.0 总是意味着做出了可能的最佳一组推荐。使用图 5.17 中的最大值,图 5.16 中那些推荐的 NDCG 等于 $8.83/9.64=0.916$。
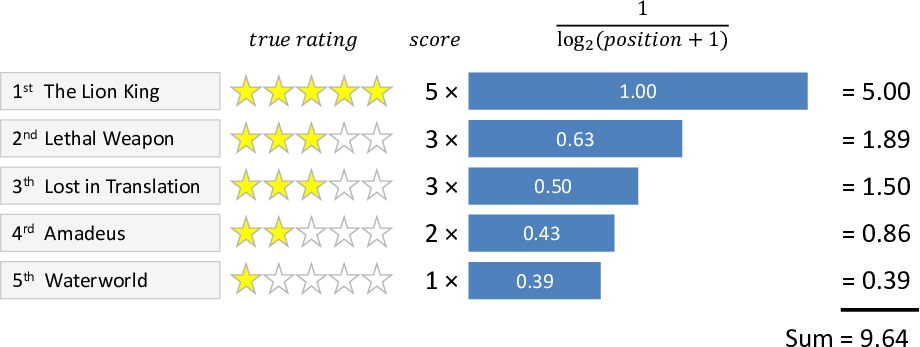
图 5.17:对图 5.16 中的五部电影计算最大可能 DCG。最大 DCG 对应于把电影按真实标签评分的星数降序排列。
我们为验证集中的每个人生成一个推荐列表,因此可以为这些列表中的每一个计算一个 NDCG。为了把它们汇总为单个指标,我们随后取所有各个 NDCG 值的平均。对于我们刚刚运行的实验,这给出的平均 NDCG@5 为 0.857。
我们应该使用多少个特质?
上面计算的指标是针对一个具有两个特质的模型的。在实践中,我们会想使用那个根据我们的指标能给出最佳推荐的特质数量。我们可以用 1、2、4、8 和 16 个特质来运行模型,看看改变特质数量如何影响我们推荐的准确性。我们还可以用零个特质来运行模型,这意味着它给每个人相同的推荐——这提供了一个有用的基线,并表明我们通过使用特质来为每个人个性化推荐究竟获益多少。注意,在使用零个特质时,我们仍然把电影和用户偏置包含在模型中。
图 5.18 显示了随着我们改变特质数量,我们的两个指标如何变化。看图 5.18a 中的喜欢/不喜欢准确率,可以看到随着我们改变特质数量,准确率基本没有变化。但图 5.18b 中的 NDCG 讲述了一个非常不同的故事:随着我们把特质数量增加到大约 4 或 8,NDCG@5 有明显的提升。超过这一点之后,添加更多特质似乎没有帮助(甚至可能略微降低准确性)。你可能会认为添加更多特质总会有帮助,但特质越多,我们就需要越多的数据才能把电影定位在特质空间中。在数据量固定的情况下,添加特质所引起的位置不确定性的增加,实际上会降低整体的推荐准确性。
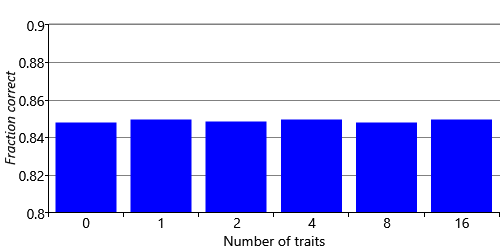
(a) 预测正确的比例
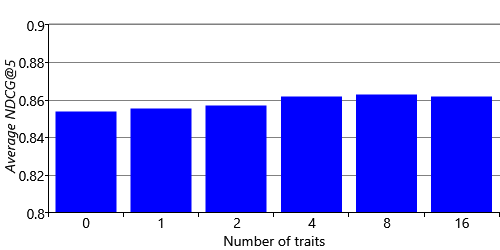
(b) 平均 NDCG@5
图 5.18:为不同特质数量计算的准确率和 NDCG 指标。为了让这些条形图中指标的变化可见,我们不得不把 y 轴从 0.8 而非零开始。一般来说,应当避免这种做法,因为它会虚假地夸大各条形之间的差异。既然我们在这里以及后面一些图表中选择了这样做,请务必牢记,实际的差异比图表可能显示出来的要小。
你可能会疑惑,为什么在预测准确率没有提升时,我们却看到了平均 NDCG 的提升。答案是,NDCG 是一个更敏感的指标,因为它利用了原始的真实标签星级评分,而不是把这些评分转换成喜欢/不喜欢之后的结果。这种敏感性提示我们,如果在完整的星级评分范围上、而不是仅仅在二值的喜欢或不喜欢上训练我们的模型,我们会有所获益。在下一节中,我们将探讨为实现这一点需要对模型做哪些改动。
本页引入概念回顾
折损累计增益(Discounted Cumulative Gain):一个针对推荐列表的指标,被定义为每个单独推荐得分的总和,每一个都由一个取决于该推荐在列表中位置的折损函数加权。选择该折损函数使其对列表开头的推荐给予较高的权重、对末尾的推荐给予较低的权重。因此,当把好的推荐放在列表开头时,DCG 会高于把列表重新排序、把它们放到末尾时的 DCG。关于计算 DCG 的可视化示例,见图 5.16。
归一化折损累计增益(Normalized Discounted Cumulative Gain):折损累计增益的一个缩放版本,其缩放使得最大可能值等于 1。这种缩放是通过把实际 DCG 除以最大可能 DCG 来实现的。关于计算 DCG 和最大可能 DCG 的可视化示例,见图 5.16 和图 5.17。
下一节:建模星级评分
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-09-18-mbml-recommender_our_first_recommendations/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。