Foundry Agent Service 中的语音智能体:架构、信任边界与真实音频延迟
原文:Voice agents in Foundry Agent Service: architecture, trust boundaries, and real-audio latency
以前做企业语音智能体,得自己把语音服务、实时模型、轮次检测和工具编排拼在一起,每个环节出问题也都得自己兜底。Foundry Agent Service 里的语音智能体(voice agents)把这一整套多服务方案收拢成一个带版本的托管智能体,运行时的工程量少了很多,但身份、授权、数据、网络、留存和运维这些事仍然得企业自己扛。
这篇文章的作者 Yassine El Ghali 先前有一篇发布公告讲产品能力,这一篇换了个角度:这个功能能不能作为企业语音架构的起点? 他用了自己早先那篇架构对比里的六条标准,又补了一轮覆盖六种配置、共 300 个轮次的真实音频测试。
读完这篇文章你会知道:
- Foundry 托管了什么,哪些仍然是解决方案团队的责任;
- 怎么评估数据、网络、身份、成本和运维这几条边界;
- 六种配置下,300 轮真实音频测试的延迟结果说明了什么。
需要先说明时间:截至 2026 年 9 月 29 日,语音智能体仍处于公开预览阶段。文中的产品表述核对于当天,测量数据采集于 2026 年 9 月 26 日。
总体评估
现在一个语音智能体把模型、指令、音频配置、轮次检测、工具、临时回复和存储策略都封装在一个托管的实时端点后面。团队可以少花精力拼运行时,多花精力治理整个工作负载。
Foundry 接管了语音运行时的大部分工作,但身份、授权、数据位置、网络设计、留存策略和运维可用性,依然由客户负责。
| 标准 | 微软托管或提供 | 客户责任 |
|---|---|---|
| 功能与工作量 | 托管的实时语音运行时、语音与模型编排、轮次检测、智能体版本管理、工具编排、渠道、追踪、监控和评估界面。 | 客户端与渠道集成、业务工作流、工具实现、来电者控制、治理、回归测试、容量规划和事件管理。 |
| 数据驻留 | 已发布的服务与模型地理承诺、平台加密,以及文档化的存储和留存行为。 | 选择部署类型和区域;梳理语音、模型、存储、工具、遥测和渠道各自的处理位置;配置留存策略并记录合规依据。 |
| 私有网络 | Agent Service 的网络隔离能力、私有终结点,以及与客户自管的 Storage、Azure AI Search、Azure Cosmos DB 的集成。 | 客户端连接、私有 DNS、路由、工具访问、遥测与电话出口、防火墙策略,以及端到端的可达性测试。 |
| 身份验证与授权 | 面向受支持访问模式的 Microsoft Entra 身份验证、托管身份与智能体身份、基于角色的访问控制,以及委托身份的基础能力。 | 来电者登录与准入、按用户的数据授权、工具权限、委托访问、审批与升级验证,以及重复操作的防护。 |
| 成本 | 服务计量、用量信号、预估成本遥测,以及 Azure Cost Management 的账单记录。 | 选择模型托管方式和容量,度量完整工作负载,设置预算与预测,核对费用并优化用量。 |
| 延迟 | 托管运行时,加上服务端的延迟指标、追踪和监控视图。 | 模型、语音、轮次检测、工具、检索、网络和渠道的选择;真实音频与并发测试;面向用户的延迟目标和启动体验。 |
连接启动时间: 这次测试里,建立一个新的语音智能体连接需要 3.72 到 12.37 秒。要么在对话开始前先把连接建好,要么在界面上告诉用户智能体还在连接。
这个数字我印象很深。后面的延迟结果看上去都是一两秒的事,可用户在听到第一句话之前,可能已经干等了十秒。
架构上新在哪里
新 API 把整个体验表示为一个 VoiceAgentDefinition。它的 kind 是 voice,每次创建或更新都会在稳定的智能体名称下生成一个不可变的智能体版本。这个定义里要选定:
- 模型托管方式、模型、指令和可选的问候语;
- 输入音频、转写、增强和轮次检测;
- 输出音频、声音、语言、语速和可选的虚拟形象;
- 工具、工具策略、临时回复和对话存储。
运行时通过一条持久的实时连接访问。Foundry Agent Service 负责智能体生命周期和工具编排,Voice Live 提供语音运行时。
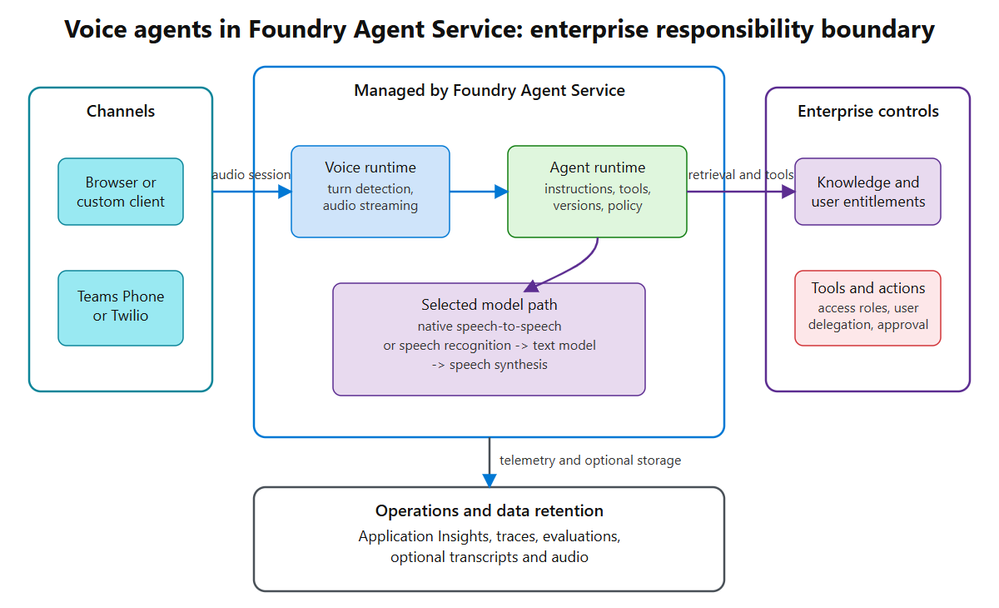
托管的语音运行时减少了实现工作,但并不会把它周围的身份、数据、网络和留存边界合并成一个。
一个功能,两条模型路径
Foundry 会根据所选模型推导出语音架构。
原生语音到语音
|
|
这条路径面向自然、低延迟的对话。模型直接接收和输出音频,可用的声音和音频控制取决于所选模型。
级联文本模型
|
|
这条路径可选的文本模型和 Azure 声音范围更广,还提供明确的转写、短语列表和语音合成控制。代价是多个串行阶段都落在延迟的关键路径上。
另外,服务托管(managed)和客户自部署(self_deployed)是一个独立的决策,它决定模型在哪里托管、在哪里计量。至于最终走的是原生路径还是级联路径,由模型本身决定。
标准 1:功能与实现工作量
这是该功能在架构上最实在的价值。Foundry 把实时会话、轮次切换、转写、声音、智能体版本、模型、知识库、工具、渠道、追踪、监控、评估和可选的虚拟形象放到了一起。门户支持无代码测试,客户端库和 Azure Developer CLI 则能让定义从源代码管理里直接部署。
仍由客户负责的部分
企业依然要管:客户端或获批的电话渠道、来电者准入与滥用控制、按用户的检索与操作授权、重要工具的审批和重复操作防护、转人工、留存策略、回归测试、容量和事件管理。
渠道支持也比通用的智能体发布要窄。目前语音渠道体验提供一个预览版 Web 应用,以及通过 Teams Phone 扩展或 Twilio 接入的电话号码集成。标准的 Microsoft Teams 或 Microsoft 365 智能体发布不能替代 Teams Phone 扩展。
标准 2:数据驻留
数据驻留不是一个区域字段能回答的问题。一轮语音对话会经过多个处理和存储面:
| 环节 | 驻留问题 |
|---|---|
| 语音与模型 | 轮次检测、识别、合成和模型推理在哪里处理?模型是全局、数据区域还是区域部署? |
| 智能体状态与对话 | 服务状态存在哪里?转写文本和原始音频有没有启用 store? |
| 知识与工具 | 文件、索引、检索到的段落、工具请求和输出在哪里处理? |
| 可观测性 | Application Insights 把遥测存在哪里?是否开启了敏感内容采集? |
| 渠道 | Azure Communication Services、Teams Phone 或 Twilio 又引入了哪些额外处理? |
Voice Live 的数据隐私文档说,Voice Live 本身默认不保留客户数据,但与之相连的功能可能会保留。如果客户选择开启支持日志,微软可以在资源所在区域保留相关语音数据,最长 30 天。Agent Service 文档则规定,有状态服务功能的静态数据存放在 Azure OpenAI 资源所在的地理范围内,而模型推理和工具遵循各自的配置与托管位置。
对于 self_deployed 配置,模型推理遵循所选的全局、数据区域或区域部署类型,但这个选择并不决定语音、存储、工具或渠道的位置。managed 配置则使用服务托管的模型。光看项目所在区域,回答不了完整的驻留问题,需要在微软文档里逐一核对所选语音、模型、存储、遥测和渠道组件当前的处理与存储承诺。
标准 3:私有网络
Foundry Agent Service 支持网络受保护的标准(Standard)配置:委托子网、私有终结点、客户提供的 Azure Storage、Azure AI Search 和 Azure Cosmos DB,并关闭公网访问。项目托管身份会获得这些依赖项的数据平面访问权限。不过这只是起点,并不能证明一个语音方案端到端都是私有的。下面这些路径要分别审查:
| 连接 | 需要证明什么 |
|---|---|
| 客户端到语音智能体终结点 | 私有 DNS、实时连接能否成功建立、可达性,以及已部署客户端环境下的空闲超时行为;或者是一个带身份验证的公共边缘 |
| 语音运行时到所选模型 | 所选语音配置实际使用的托管或自部署路由 |
| 智能体到数据与工具 | 私有终结点、DNS、基于角色的访问控制、路由、凭据,以及运行时能否成功访问 |
| 遥测与电话 | 获批的 Application Insights 出口,以及各提供商特有的媒体与信令路径 |
Agent Service 私有网络指南描述了通用的私有部署方式。但某个资源上有私有终结点,并不能证明语音特有的每一跳托管链路都是私有的。
标准 4:身份验证与授权
语音智能体的安全可以拆成四层身份来理解:
- 来电者身份。托管 Web 体验的访问权限可以分配给组织用户和组。自定义客户端仍然需要登录、会话准入、限流和业务权益校验。
- 会话调用身份。公开的 SDK 和门户访问方式使用 Microsoft Entra ID 来访问 Foundry 项目和智能体终结点。电话渠道集成还要加上提供商特有的身份验证和连接配置:Teams Phone 扩展用到 Azure Communication Services、Event Grid 和应用注册,Twilio 则使用由 Twilio 凭据支撑的项目连接。应用应该使用合适的工作负载身份,不能把长期凭据放进浏览器代码。
- 智能体身份。Foundry 智能体身份模型同样适用于语音智能体,用来向下游工具进行身份验证。把智能体发布成通用的 Agent Application 会创建一个独立的身份,所以项目权限不会自动转移过去。
- 委托用户身份。对于有人值守的场景,OAuth 代理(on-behalf-of)流程让下游服务可以同时评估智能体身份和用户的委托权限。
有效的令牌只能证明身份,不能证明请求的操作是安全的。智能体可能有权查询某个索引,而来电者只能看到其中一部分文档;它也可能能调用某个工具,但来电者无权授权这个操作。所以在内容到达模型之前,就应该先按来电者的文档权限做过滤。对有实际后果的操作,需要应用层策略、必要时的升级验证、口头确认,以及重复操作防护,免得重连之后副作用被执行两次。也别把识别出的声音或一个电话号码当成身份证明。
标准 5:成本
现在已经有了官方的语音智能体定价指南,但它更适合拿来理解计费结构,而不是当作一张长期有效的价格表。
文档里列出了五个影响成本的因素:
- 音频输入和输出的 token;
- 托管与自部署的模型托管方式;
- 连接会话的时长;
- 工具调用以及背后的服务;
- 虚拟形象、对话存储等可选功能。
完整架构还可能包括语音识别与合成、自定义声音托管、Application Insights、Azure Storage、Azure AI Search、Azure Cosmos DB、电话、应用入口、身份和网络基础设施。
使用 model_type: managed 时,用量作为语音智能体的一部分计费。使用 model_type: self_deployed 时,模型用量则记在客户自己的 Foundry 模型部署上,按该部署的标准或预配容量定价模式收费。
调优期间,语音追踪可以暴露 token 用量和预估成本属性。微软明确表示这些是估算值,不是账单记录,真正的计费依据仍然是 Azure Cost Management。
为什么这篇文章没有给出美元估算
给出单次对话的估算会造成虚假的精确感,因为区域、协议、模型、音频量、会话时长、工具和可选服务都会改变结果。更稳妥的做法是:记录每一轮的用量和会话时长,在 Cost Management 里核对实际费用,再用真实的通话时长、并发、转接和重试去建模。
别忘了把运维成本算进去。托管功能省掉的是语音运行时的代码,治理、身份、网络和渠道运维一样不会少。
标准 6:延迟
来电者只关心一个延迟指标:我说完之后,智能体多久开口? 模型路径决定了有哪些处理阶段,但最终结果取决于模型选择、轮次检测设置、网络距离、工具、检索、回复长度和渠道缓冲。
测了什么
配套的测试工具把之前的三种模式和新功能放在同一个真实音频测试里重跑了一遍:
- Realtime API 直连和使用自有模型的 Voice Live,都用同一个客户部署的
gpt-realtime-1.5模型。 - 先前的 Voice Live + 提示词智能体路径,和新的级联语音智能体,都用
gpt-4o-mini、同一个 Azure 神经网络声音,并且不带工具。这是架构变量控制得最严的一对。 - 新功能还跑了托管的
gpt-realtime-2.1和级联的gpt-5。
每条路径收到的都是同一段 1.33 秒的 “Say hello briefly” 录音,按实时速度播放,使用同样的简短回答指令,以及同样的服务端轮次检测设置,包括 500 毫秒的静音等待。每种配置在五个全新会话里测 50 个轮次,每个会话排除一次预热,并按随机顺序依次运行。知识库和工具都被关闭,第一方智能体也不存储对话。
主指标的计时从来电者说完话开始,到第一段响应音频到达客户端为止:
- “典型轮次”是中位数,也就是一半轮次比它快,一半比它慢。
- “95% 在此之前开始”是慢端结果,只有二十分之一的轮次比它更慢。
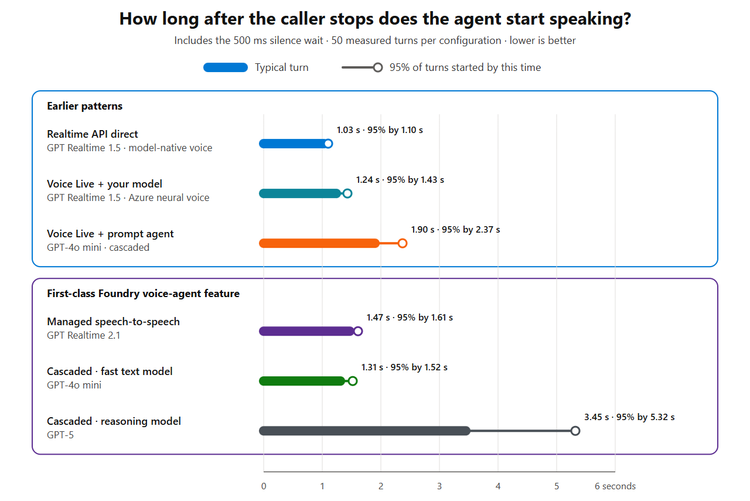
从来电者说完话到响应音频到达客户端的时间。越低越好,结果只适用于这个测试环境。
| 架构与配置 | 典型轮次 | 95% 在此之前开始 |
|---|---|---|
先前模式:Realtime API 直连,gpt-realtime-1.5 |
1.03 s | 1.10 s |
先前模式:Voice Live 搭配自有模型,gpt-realtime-1.5 |
1.24 s | 1.43 s |
先前模式:Voice Live + 提示词智能体,gpt-4o-mini |
1.90 s | 2.37 s |
新功能:托管 gpt-realtime-2.1 |
1.47 s | 1.61 s |
新功能:级联 gpt-4o-mini |
1.31 s | 1.52 s |
新功能:级联 gpt-5 |
3.45 s | 5.32 s |
全部 300 个测量轮次都返回了响应音频和预期的转写结果。
最有参考价值的是同模型、同声音的级联对比。第一方的 gpt-4o-mini 语音智能体,在典型轮次上比 Voice Live 搭配无工具提示词智能体快 0.59 秒,在 95% 边界上快 0.85 秒。这是这两种配置之间观察到的端到端差异,没法说明是内部哪个阶段造成的。
Realtime API 直连在这个环境里最快。Voice Live 搭配自有模型在典型轮次上慢 0.21 秒,在 95% 边界上慢 0.32 秒。两者用的是同一个实时部署,但直连用的是模型原生声音,Voice Live 用的是 Azure 神经网络声音,所以这个差距衡量的是两套配置,并不是单独的 Voice Live 开销。
在新功能内部,托管的 gpt-realtime-2.1 和级联的 gpt-4o-mini 非常接近,这一轮结果还不足以给它们定一个长期的先后顺序。而把级联模型换成 gpt-5 影响就大得多,典型结果从 1.31 秒升到 3.45 秒。模型选择始终是架构决策的一部分。
为什么服务监控里能看到亚秒级的结果
Foundry Agent Service 语音智能体监控视图里的“整体延迟”图表,测的是语音活动检测判定来电者说完之后到第一段音频的时间。而基准测试的图表从来电者真正停止说话时就开始计时,所以包含了配置的半秒静音等待。
按服务侧这个较晚的边界来算:
- 托管的语音到语音,典型值 0.88 秒,95% 的轮次在 1.02 秒内开始。
gpt-4o-mini级联,典型值 0.78 秒,95% 在 0.99 秒内开始。gpt-5级联,典型值 2.92 秒,95% 在 4.78 秒内开始。
两种计时都成立,只是回答的问题不同。文中的图表用的是来电者视角,因为它更接近用户的真实感受。服务边界较晚,所以运维指标可以是亚秒级,而来电者那边的时间却超过一秒,差出来的就是检测轮次结束和跨网络传送音频所需的时间。
和之前那组测量的关系
先前那篇文章用的是十个预热过的、文本注入的轮次,不包含真实语音和轮次结束检测。那里的数值不要和这张图直接比。这次统一重跑才是跨模式的对比,因为每条路径用的是同样的音频、来电者侧计时边界、预热策略、样本数、区域、网络和无工具负载。
测试范围与复现
测试包含真实语音、轮次结束检测、模型处理和返回的音频。它不包括设备缓冲、电话、工具、检索、并发、私有网络和生产客户端,所以结果描述的只是这个环境,并不是一个通用目标。
想复现的话,可以看这些资源:统一基准测试工具、仅用于基准测试的提示词智能体创建脚本、第一方语音智能体创建脚本、音频生成脚本、原始轮次数据与方法,以及可编辑的图表源文件。
企业架构检查清单
做工作负载决策时,建议逐项确认:
- 平台适配:所在区域支持所选的模型、声音、音频功能、工具和渠道,服务配额能覆盖预期的并发。
- 数据与网络:每个处理和存储位置都有记录,每条路由在目标客户端和网络拓扑下都能走通。
- 身份与授权:来电者已通过身份验证,检索遵守他们的文档权限,工具身份、委托、审批和重复操作防护都经过测试。
- 留存:对话存储、追踪采集、音频访问、删除、用户同意和法定留存期限都已获批。
- 性能:用真实音频、工具、目标网络和并发做过测试,并且为典型轮次和最慢的 5% 都定了目标。
- 运维:配额、错误、重连、转人工、依赖项故障、监控和回滚都演练过。
结论
如果要在 Microsoft Foundry 上从头做一个企业语音方案,又能接受预览状态,Foundry Agent Service 里的语音智能体值得优先评估。它把语音变成托管的、带版本的智能体生命周期,运行时、渠道、追踪、监控和评估都在一处。与其默认自己重搭这些层,从它起步要省事得多。
作者也说得很清楚,它不一定更快,也不一定更便宜。这次测试里 Realtime API 直连最快,gpt-5 的结果则说明模型选择可以左右最终体验。托管功能同样没有消除周围的信任边界,身份、授权、数据位置、网络、留存和运维,仍然要企业自己设计。
所以之前的几种模式依然成立,只是新建项目时,它们应当是经过考量的备选,而不是默认起点。作者的建议大致是这样:
先评估 Foundry Agent Service 里的语音智能体功能。当它的预览状态、区域、模型、声音、渠道、身份、数据、网络、成本和实测性能都符合工作负载时再采用它。只有当某项有文档依据的需求需要更多控制、更多能力或某个托管定义不提供的处理边界时,才选择 Realtime API 或更底层的 Voice Live 模式。
想了解这些底层替代方案,以及自己掌控运行时和使用托管层之间的取舍,可以看先前那篇三模式架构对比。产品功能概览和发展方向则可以读发布公告。
参考资料
- Introducing voice agents in Microsoft Foundry
- Agents in Microsoft Foundry
- Create a voice-based prompt agent
- Configure a voice agent
- Voice-agent design best practices
- Voice-agent tracing, monitoring, and evaluation
- Pricing for voice-based agents
- Foundry Agent Service regions and limits
- Private networking for Foundry Agent Service
- Agent identity concepts
- Data, privacy, and security for Voice Live
- Data, privacy, and security for Agent Service
- Publish and share a voice-based agent
- Integrate telephony channels with a voice agent
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-10-11-voice-agents-in-foundry-agent-service-architecture-trust-boundaries-and-real-audio-latency/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。