如何让 Microsoft Foundry 上的 AI 响应更快:来自 2,040 次测量的经验
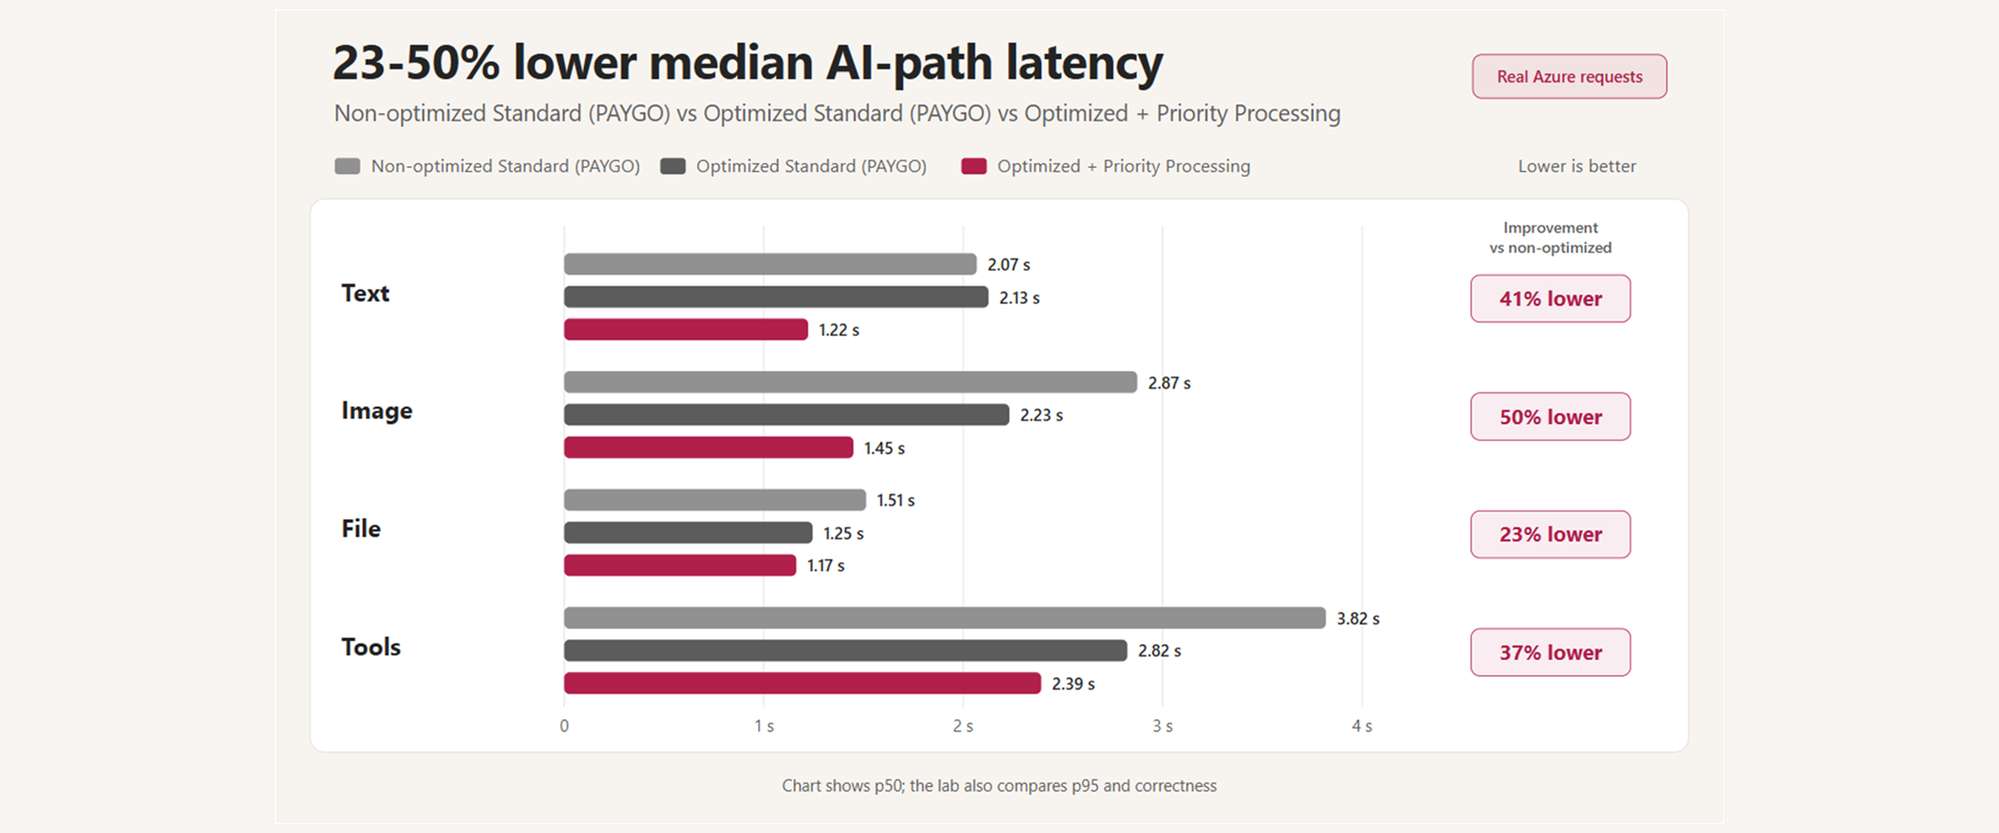
题图来自 Microsoft Foundry 博客的 How to make AI responses faster on Microsoft Foundry: lessons from 2,040 measurements,作者是 Yassine El Ghali。
模型换得更快,应用不一定就更快。这篇文章的作者在 Microsoft Foundry 上把文本、图片、文件、工具和 MCP 几类工作负载都测了一遍,想知道哪些改动真能降低延迟,又不牺牲正确性。我读下来最大的感受是,延迟的来源比我平时想的杂得多:输出长度、重复的 prompt 内容、图片和文档处理、工具选择、连接建立、串行等待,还有多出来的模型请求,都会占时间。
按作者的口径,把优化过的软件配置和经过验证的 Priority Processing 组合起来,与未优化的 Standard 按量付费相比,AI 路径的中位延迟降低了 23% 到 50%,具体看工作负载。要注意,这个数字没有单独拆出 Priority Processing 的贡献。
先看短版本:
- 去掉不必要的输出、视觉处理和工具定义。
- 复用稳定的 prompt 前缀,以及由应用管理的 MCP 会话。
- 去掉串行等待和多余的模型轮次,再对剩下的工作测试 Priority Processing。
延迟要和正确性、可靠性一起测。又快又错的答案,不算性能提升。
测量方法
这里的一次测量,指的是某个场景、某个变体、某个 fixture 的一次执行。每个用例在五个确定性 fixture 上,按带种子的随机顺序跑出 30 个有效观测。处理组和对照组在同一个 fixture、同一轮、同一次执行里运行时,会配对比较。
分析用的数据集一共有 2,040 次测量。审计记录里有 2,160 次基准执行,是发布前那轮实验里记下来的,不含云端预检。另有 120 次更早的客户端生命周期运行,因为后来修正了计时边界,被排除在外。
自动化的确定性评分器会检查必填字段、事实、工具调用和参数。失败和不正确的运行仍然算在可靠性统计里,延迟百分位只用正确完成的运行来算,也不会悄悄重试失败的请求。
AI 路径延迟,从模型请求(或一段编排好的模型加工具工作流)发出之前开始计时,到该响应或工作流完成为止。校验决定结果能否进入延迟分析,但校验耗时不在主计时器里。用户到应用之间的网络、UI 渲染,以及图片缩放、PDF 生成、文本提取、OCR 这类预处理,也都在计时之外。
基准只用了一个 Azure 账号,资源在 East US 2。除非某个处理组明确要测内部请求或工具的扇出,否则一次只跑一个基准用例。组合基准用的是 Azure OpenAI Global Standard 部署,所以 East US 2 只说明资源所在区域,并不保证推理一直在这个区域里完成。单项优化测试用的是 gpt-4.1-mini,组合基准用的是 gpt-4.1,版本 2025-04-14。这不是负载测试,两组结果的百分比不能放在一起算。
fixture 是合成的、确定性的。组合基准复用了同一批 fixture 家族,所以它不是在留出的生产输入上做的独立复现。中位数效应用的是 5,000 次抽样的 bootstrap 区间,区间没有针对多重比较做校正,30 个观测算出的 p95 只能当作描述性数字。协议和局限在 lab report 里有记录,执行 ID、产物版本、区间和可靠性事件在 result ledger 里。
结果速览
下表汇总了最值得参考的单变量结果。
| 测试的改动 | 工作负载 | 观测到的中位数结果 | 重要的限定条件 |
|---|---|---|---|
| 生成简洁的文本回答 | 文本 | 快 26.0% | 29/30 正确,有一次流在完成前就结束了 |
| 生成简洁的 JSON | 图片 | 快 24.9% | 30/30 正确 |
| 复用可缓存的 prompt 前缀 | 文本 / 图片 | 分别快 14.9% / 23.6% | 请求必须报告命中了缓存 token |
| 使用低图片细节 | 图片 | 快 17.8% | 细小文字和视觉证据必须仍然准确 |
| 发送已提取的文本,而不是 PDF | 文件 | AI 路径快 17.2% | 提取或 OCR 的时间在计时之外 |
| 并发处理三个相互独立的页面 | 文件 | 快 56.8% | 模型请求还是那三个,只改了调度 |
| 在一次模型响应里请求两个必需的函数 | 函数工具 | 快 28.2% | 主要是少了一次模型请求,不只是处理函数并行了 |
| 暴露 5 个工具而不是 20 个 | 函数工具 | 快 16.8% | 必需的工具必须仍然可用 |
| 使用最简工具描述 | 函数工具 | 快 14.4% | 工具选择和参数必须仍然正确 |
| 复用由应用管理的 MCP 会话 | MCP | 冷会话慢 34.1% | 需要安全的生命周期和恢复处理 |
| 给 50 个工具的 Toolbox 加上 tool search | Toolbox / MCP | p50 慢 43.0% | 输入 token 降了 26%;正确率 30/30 对 29/30,描述性 p95 更低 |
这些都是针对具体工作负载的发现,不是服务保证。只有配对的中位数效应 95% 区间不包含零时,作者才标注为"更快"。
一、去掉任务不需要的工作
只生成需要的输出
文本方面,证据最清楚的优化是缩短输出约定。
文本任务里,要求紧凑回答把中位延迟从 2,078 ms 降到 1,537 ms,在正确完成的请求里提升了 26.0%。
图片提取任务里,改成简洁 JSON 把中位数从 1,646 ms 降到 1,237 ms,提升 24.9%,30/30 正确完成。
这不是说每个回答都该写得很短。意思是,模型不该生成下一步应用会丢掉的内容。
一张 UI 卡片可能只要五个字段,一个路由步骤可能只要一个枚举值,一个工具规划器可能只需要校验过的参数。先把这份约定明确写出来,再验证更短的回答是否仍然满足产品需求。
减少输入则是另一回事。去掉 12 轮无关的历史对话,文本中位延迟降了 12.7%,但配对的 95% 置信区间包含零,所以在这个小测试里结论不确定。去掉无关上下文仍然可以降低输入 token 的成本,但这个实验并没有证明它能降低延迟。
只用任务需要的视觉表示
在提取发票 ID、总额和状态的任务上,低图片细节比高细节快 17.8%。
低细节和缩小源文件不是一回事。完整图片仍然会发送,只是 detail: "low" 让服务去分析一个 512 x 512 的表示,而不是做高分辨率的分块检查。参见 Configure image detail level。
对于大而清晰的印刷字段,这样做效果不错,但它可能漏掉小字、手写内容、图表或空间位置上的证据。只有确定性校验证实所有必需字段仍然准确时,才从低细节开始。
缩放图片也把中位数降了 12.8%,但描述性 p95 从 5.1 秒升到了 8.8 秒。这不影响中位数的结论,只是变慢的尾部延迟观测还需要进一步调查。本地缩放耗时同样在 AI 路径计时器之外。
文件方面,发送已经提取好的文本,比直接发原生 PDF 快 17.2%。这个结论刻意限定得很窄,因为提取或 OCR 发生在计时之前。
任务只依赖文字事实时,用文本就行。版面、签名、图表、手写内容或其他视觉证据重要时,就保留原生文档处理。要做完整流水线的决策,必须把提取成本和可靠性算进去。
二、复用工作和连接
把重复的 prompt 内容放在最前面
Prompt caching 缓存的不是模型的回答。它临时复用的是服务已经对长输入开头部分做过的处理。第一次请求照常处理,之后的请求可以复用匹配的前缀。
对实验里的 gpt-4.1 模型来说,符合条件的请求至少要有 1,024 个输入 token,并且前 1,024 个 token 要与最近的某次请求一致。
服务不会分别缓存请求里的各个字段,而是从开头开始,只复用匹配的内容,直到出现第一处差异为止。所以请求里内容的顺序很重要。
下面是一个简化的 Responses API 请求:
{
  "model": "<deployment-name>",
  "instructions": "[REUSABLE] Stable system instructions, examples, and output rules",
  "input": [
    {
      "type": "message",
      "role": "user",
      "content": [
        {
          "type": "input_text",
          "text": "[REUSABLE] Reference content shared by many requests"
        },
        {
          "type": "input_text",
          "text": "[CHANGES] The current user's question"
        }
      ]
    }
  ]
}
可复用的开头部分可以包含系统指令、示例、输出规则、工具定义或共享的参考文本。保持它们完全一致并放在最前面,当前的问题、请求 ID、图片、文档和其他会变的内容放在后面。
如果开头出现了时间戳或请求 ID,各个请求从一开始就不同,后面那些稳定的指令也就没法形成一段足够长的匹配前缀。
预热前缀的缓存让文本中位延迟降了 14.9%,图片降了 23.6%。文本的平均首 token 时间从 991 ms 降到 602 ms。
作者没有想当然地认为机制生效,而是做了验证。大约 93% 到 100% 的重复请求报告了缓存命中。对照组在开头改了一个值,就没有报告任何缓存 token。
做法就是:共享内容放前面,请求特有的内容放后面,再检查响应里的 cached_tokens。
在这次运行里,缓存对文件任务和函数工具任务没有带来明确的中位数改善。当文档处理、工具选择或别的环节占了大头时,复用 prompt 的处理就没那么重要了。
最新的资格条件和保留时长见 Prompt caching。
别让每个任务都重新连接 MCP
当应用自己充当 MCP 客户端时,连接建立和工具发现可能在关键路径上占相当一部分。
复用会话时,p50 是 2,283 ms。每个任务都新开一个会话并发现工具,p50 升到 3,061 ms,冷路径比复用路径慢 34.1%。建立会话加工具发现平均花 1,016 ms,本地工具本身不到 5 ms。
这是应用生命周期层面的优化,不是模型层面的优化,结果也不会自动适用于服务托管的 MCP。
可以在多个任务之间复用一个兼容的会话和已经发现的工具目录。一个会话无法安全支撑预期并发时,就用一个有上限的连接池。复用要按身份和租户划定范围,并且要考虑过期、重连、凭据轮换、目录刷新、健康检查和故障隔离。
仓库里附有完整的 MCP 连接辅助代码。
三、去掉串行等待和不必要的模型请求
并发处理相互独立的页面请求
单变量里效果最大、且有证据支持的,是并发处理三个相互独立的文档页面。
两种配置发出的模型请求都是三个。串行版本要等一个响应回来才发起下一个,并发版本是三个请求都发出去之后再等结果。
中位延迟从 2,811 ms 降到 1,216 ms,提升 56.8%。
这是调度层面的结果,只在请求相互独立、模型配额也撑得住突发流量时才成立。生产代码还是需要有上限的并发、超时和部分失败的处理。
去掉函数工作流里可避免的一轮模型调用
这个函数工具任务需要同时查天气和当地时间:
Slower: model -> weather -> model -> time -> model -> final answer
Faster: model -> weather + time -> model -> final answer
更快的设计让一次模型响应同时请求两个函数,把工作流从三次模型请求减到两次,p50 从 3,646 ms 降到 2,617 ms,提升 28.2%。
合成的处理函数都在 5 ms 内完成,所以收益大部分来自少了一次模型请求。让处理函数并发执行是另一种机制。
对于由应用执行的函数:
- 允许模型请求多个调用
- 校验工具名称和参数
- 确认这些调用相互独立,且可以安全地重叠执行
- 把异步 I/O 放在一起跑
- 为每个原始调用 ID 返回一个输出
- 所有必需的结果都到齐后,再让模型生成最终回答
parallel_tool_calls=True 只是允许多个调用,并不保证模型会选出每个必需的工具。asyncio.gather 能让异步 I/O 重叠,但不会让阻塞的同步代码变成并行。
28.2% 这个结果只适用于由应用执行的函数工具。没有单独的基准测试,也没有能说明实际执行行为的 trace,就不要把它套到服务托管的 MCP 或 Foundry Agent Service 上。
四、限制每个请求可用的工具
工具定义也是模型输入的一部分。即使函数本身几毫秒就跑完,工具选择和最终生成仍然可能要花几秒。
把活跃的工具目录从 20 个函数工具减到 5 个,p50 降了 16.8%。使用最简描述,p50 降了 14.4%。
可以参考的设计模式是:
- 先把请求路由到某个领域
- 只暴露该领域相关的工具
- 名称、描述和 schema 保持简洁,但要有区分度
- 校验工具选择和参数,不能只看 token 数
其他针对工具 schema 的处理,在这个样本量下结论都不确定。暴露 50 个工具、加入复杂 schema、把描述写得含糊、调整定义顺序,都没有产生有统计支持的中位延迟变化。有些描述性的 p95 更慢,但 30 次尝试不足以断定这些处理会稳定地损害尾部延迟。
Toolbox 能改善工具选择,但多了一轮搜索
Microsoft Foundry Toolbox 的 tool search 会把庞大的工具目录挡在初始 prompt 之外,需要时再去发现相关工具。
在这个合成的 50 工具测试里,它把平均输入 token 降低了 26%,正确完成了 30/30 次,直连 MCP 是 29/30。不过多出来的搜索这一轮,把 p50 从 2,528 ms 提高到 3,614 ms,增加了 43.0%。
单个测试不能证明 Toolbox 总体上能提高准确率,它展示的是一种取舍:目录规模、上下文压力或工具选择是主要问题时,用 tool search。如果首次响应的延迟最重要,而且应用已经知道相关的子集,直接暴露这个更小的子集可能更快。
参见 Tool search 和 Toolbox overview。
五、软件优化之后再测 Priority Processing
作者最早那批标注为 Priority Processing 的请求,给了他们一个重要的验证教训:所选的模型并不支持请求的那个 tier,每个响应报告的都是 service_tier=default。
这些观测留在了审计记录里,但不作为 Priority Processing 的证据。
和 gpt-4.1-mini 上的单项优化测试不同,组合基准用了支持该 tier 的 gpt-4.1 部署。每个成功的 Priority Processing 响应报告的都是 service_tier=priority。
对比的是三种配置:
- 未优化的 Standard 按量付费
- 优化后的 Standard 按量付费
- 同样的优化配置,加上 Priority Processing
| 工作负载 | 未优化 Standard | 优化后 Standard | 优化 + Priority Processing | 组合提升 |
|---|---|---|---|---|
| 文本 | 2,070 ms | 2,125 ms | 1,222 ms | 快 41.0% |
| 图片 | 2,872 ms | 2,234 ms | 1,448 ms | 快 49.6% |
| 文件 | 1,512 ms | 1,245 ms | 1,165 ms | 快 23.0% |
| 函数工具 | 3,817 ms | 2,824 ms | 2,393 ms | 快 37.3% |
表里每个值都是 AI 路径延迟的中位数。组合提升比较的是"优化后的软件加 Priority Processing"与"未优化的 Standard"。
单靠软件优化,图片、文件和函数工具三类工作负载都有明确改善。优化后的文本配置在 gpt-4.1 上结果不确定,延迟甚至略高了一点(2,070 ms 对 2,125 ms)。
在优化配置上再加 Priority Processing,四类工作负载观测到的 p50 都降了。文本和图片的配对区间不包含零,文件和函数工具的区间跨过了零,所以这两类上的增量效果不确定。
Standard 的 240 次运行全部正确完成,Priority Processing 是 119/120,有一次函数工具失败。文件和函数工具的描述性 p95,在这次运行里 Priority Processing 比优化后的 Standard 更慢。每组只有 30 次尝试,这只能说明在定 SLO 之前该多收集一些尾部观测,不是确定的尾部延迟结论。
Priority Processing 是按量付费,有自己的价格。Provisioned Throughput 则是预留以 PTU 计量的专用容量,不在这次对比范围内。作者没有算具体的货币成本,所以需要另外评估当前各区域的定价。选处理方式之前,先看一下当前的 deployment categories 和 Priority Processing 文档。
没有产生明确中位数改善的做法
负面和不确定的发现,同样是结果的一部分:
gpt-4.1-nano并没有稳定地比gpt-4.1-mini快,在测试的图片任务上反而慢了 25.0%- 去掉 12 轮无关的文本历史,对延迟的影响不确定
- 重新创建 SDK 客户端,影响不确定
- 只选一页 PDF 而不是三页,影响不确定
- 在测试的文件和函数工具任务上,prompt caching 的影响不确定
- 多参数和嵌套的 schema、含糊的描述、重新排序的工具定义,影响都不确定
这些发现并不证明这些改动永远没用。它们说明的是,模型名称、token 数和架构上的直觉都不算性能证据。要在真实任务上测,给正确性打分,保留失败记录,并找出真正占大头的是哪个环节。
实用决策指南
| 可能的延迟来源 | 该测什么 | 必须仍然成立的条件 |
|---|---|---|
| 生成的回答太长 | 只请求需要的输出 | 回答仍然完整且正确 |
| 重复的长 prompt 内容 | 把稳定内容放前面并保持一致 | 响应报告了缓存 token |
| 图片处理 | 试试低细节 | 细小文字和必需的视觉证据仍然准确 |
| 文档的表示方式 | 对比原生 PDF 和提取后的文本 | 计入提取时间,需要时保留视觉证据 |
| 相互独立的页面请求 | 并发运行 | 请求之间确实独立,配额撑得住突发 |
| 工具之间多出来的模型轮次 | 在一次模型响应里请求必需的函数 | 选出的函数和参数相同 |
| 慢的、相互独立的应用端函数 | 让异步 I/O 重叠 | 副作用、配额、超时和失败都能安全处理 |
| 庞大的静态工具集 | 路由到更小的相关目录 | 正确的工具仍然可用 |
| 庞大的动态目录 | 测试 Toolbox tool search | token 和选择上的收益值得多花那一轮搜索 |
| 重复的 MCP 建立过程 | 复用由应用管理的会话 | 认证、过期、重连和隔离仍然安全 |
| 服务端的处理时间 | 测试 Priority Processing | 返回的 tier、p50、p95、可靠性、质量、成本和数据驻留都满足目标 |
每个实验可以按下面的顺序来做:
- 定义一个正确答案必须包含什么
- 写明计时器确切的开始和结束位置
- 在有代表性的 fixture 上配对对照组和处理组
- 随机决定谁先运行
- 把失败保留在可靠性结果里
- 只用正确完成的运行来计算延迟
- 把兼容的优化放在一起测试,不要把各自孤立的百分比加起来
复现或查看这个实验
AI response performance benchmark 仓库里有基准的实现、Terraform 环境、确定性 fixture、原始结果的处理脚本和报告。
照着仓库 README 配置好 Azure 环境,就能运行自带的 smoke、单变量和组合基准配置。在跑要花钱的基准轮次之前,先从 smoke 配置开始。使用合成数据或经批准的数据,先确认配额和预期成本,再把自带的 fixture 换成能代表你生产工作负载的样例。
仓库里还有:
- 一份 AI response performance testing guide
- 完整的 lab report
- 可审计的 publication result ledger
- 一个 AI response performance Copilot skill,可以把这套方法用到别的仓库上
我自己最想带走的是顺序:先定义什么叫正确,把每个阶段的耗时量出来,砍掉能避免的工作,最后才轮到平台选项,去优化关键路径上还剩下的那段时间。
- 本文作者:BeanHsiang
- 本文链接:https://beanhsiang.github.io/post/2026-10-06-how-to-make-ai-responses-faster-on-microsoft-foundry-lessons-from-2040-measurements/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。